Skill 与 Agent 进阶 · 第 8 章
Markdown 格式化:让乱糟糟的文字自动变整齐
多人协作的 Markdown 总会越写越乱。用一个格式化 Skill 把标题层级、列表与空行统一, diff 才能看得清。
Markdown 格式化:让乱糟糟的文字自动变整齐
🎯 学什么:学会设计「多步骤/多阶段」的 Skill 流水线——从分析到执行到报告。这是 Level 1 中最重要的一课,因为它引入了一种全新的 Skill 架构模式。 💡 难易度:⭐⭐⭐ | ⏱️ 预计时间:55 分钟
1. 课程概览
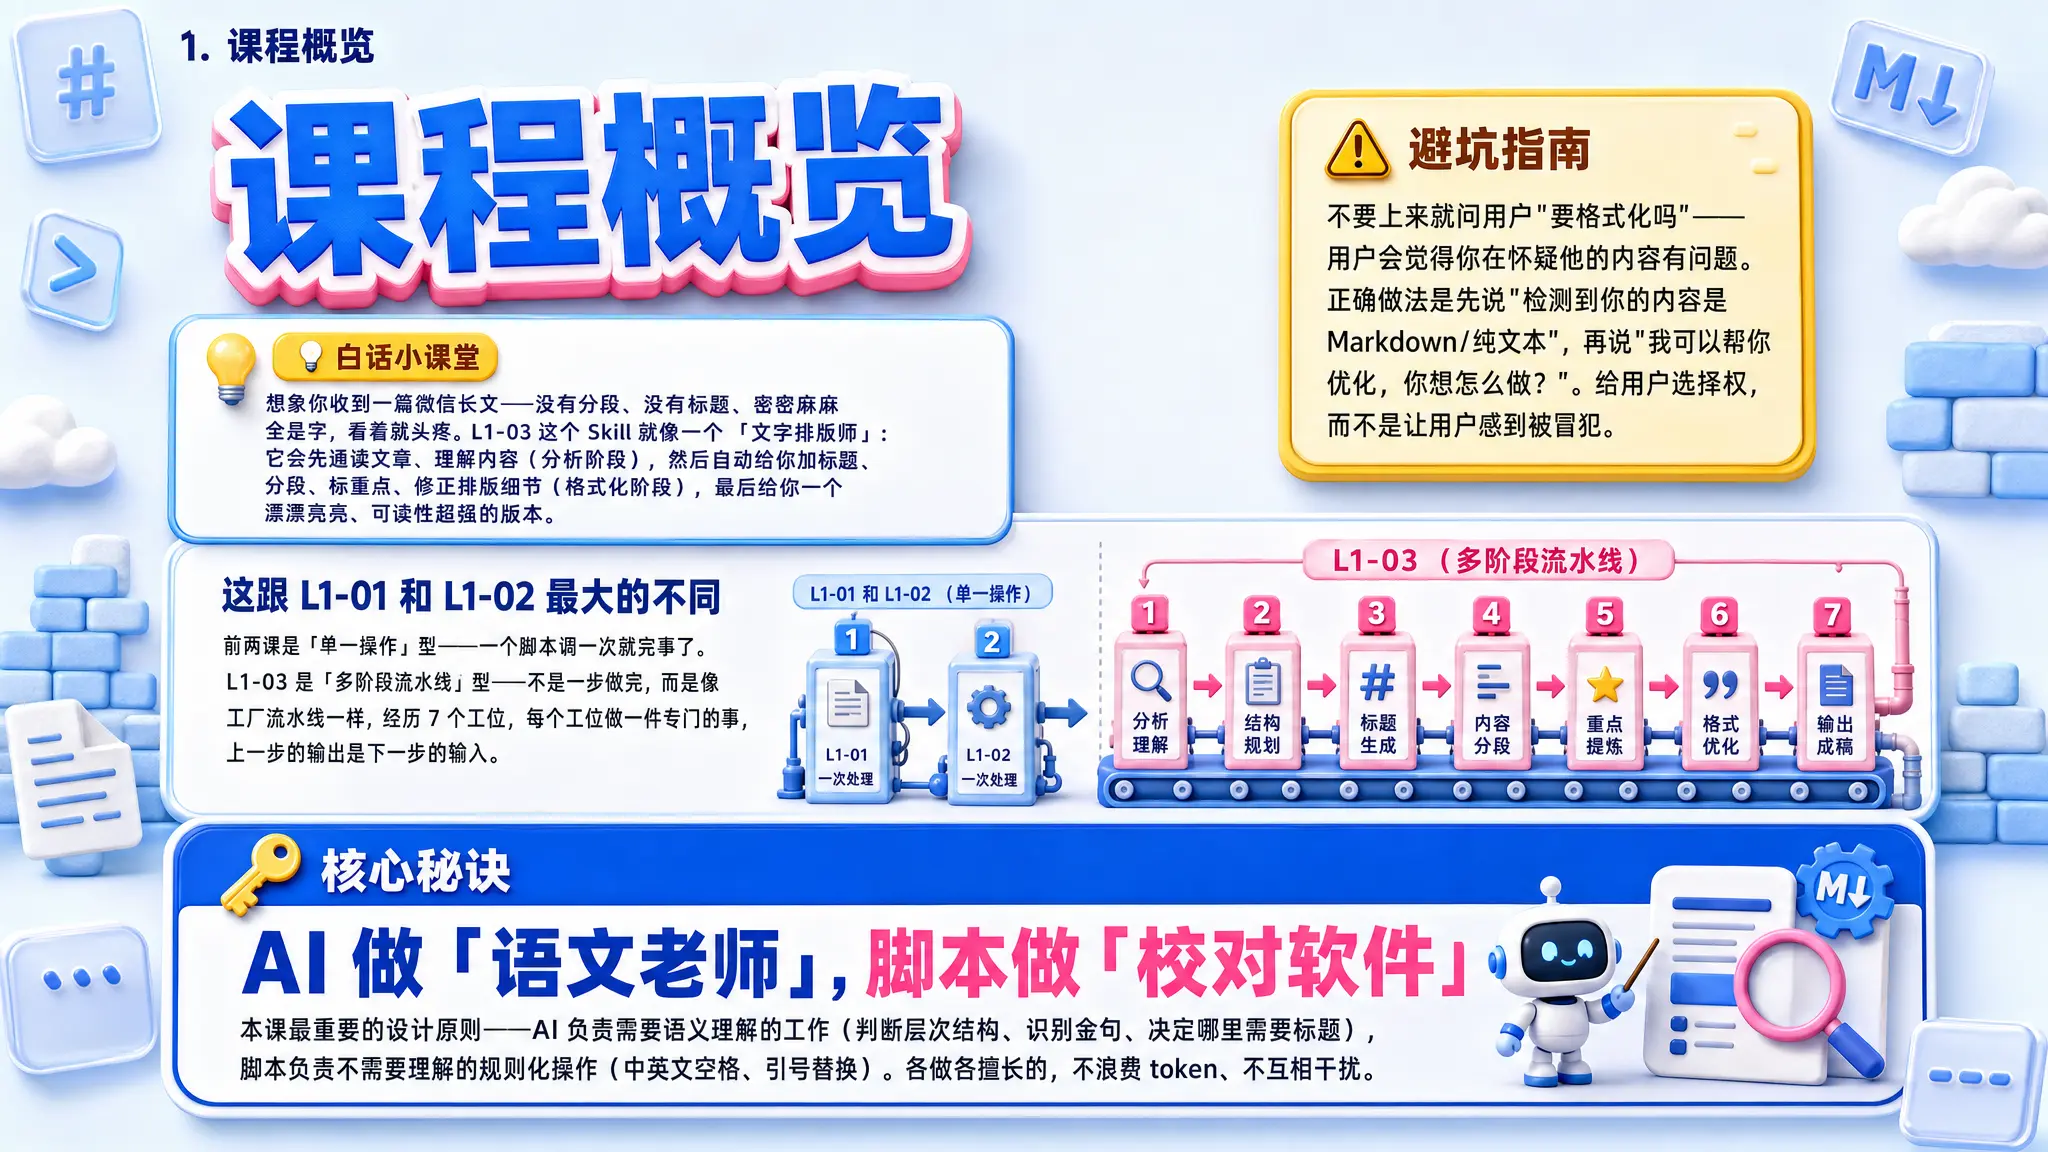
💡 白话小课堂:想象你收到一篇微信长文——没有分段、没有标题、密密麻麻全是字,看着就头疼。L1-03 这个 Skill 就像一个「文字排版师」:它会先通读文章、理解内容(分析阶段),然后自动帮你加标题、分段、标重点、修正排版细节(格式化阶段),最后给你一个漂漂亮亮、可读性超强的版本。
这跟 L1-01 和 L1-02 最大的不同:前两课是「单一操作」型——一个脚本调一次就完事了。L1-03 是「多阶段流水线」型——不是一步做完,而是像工厂流水线一样,经历 7 个工位,每个工位做一件专门的事,上一步的输出是下一步的输入。
⚠️ 避坑指南:不要上来就问用户"要格式化吗"——用户会觉得你在怀疑他的内容有问题。正确做法是先说"检测到你的内容是Markdown/纯文本",再说"我可以帮你优化,你想怎么做?"。给用户选择权,而不是让用户感到被冒犯。
🔑 核心秘诀:本课最重要的设计原则——AI 做「语文老师」,脚本做「校对软件」。AI 负责需要语义理解的工作(判断层次结构、识别金句、决定哪里需要标题),脚本负责不需要理解的规则化操作(中英文空格、引号替换)。各做各擅长的,不浪费 token、不互相干扰。
2. 七步流水线详解
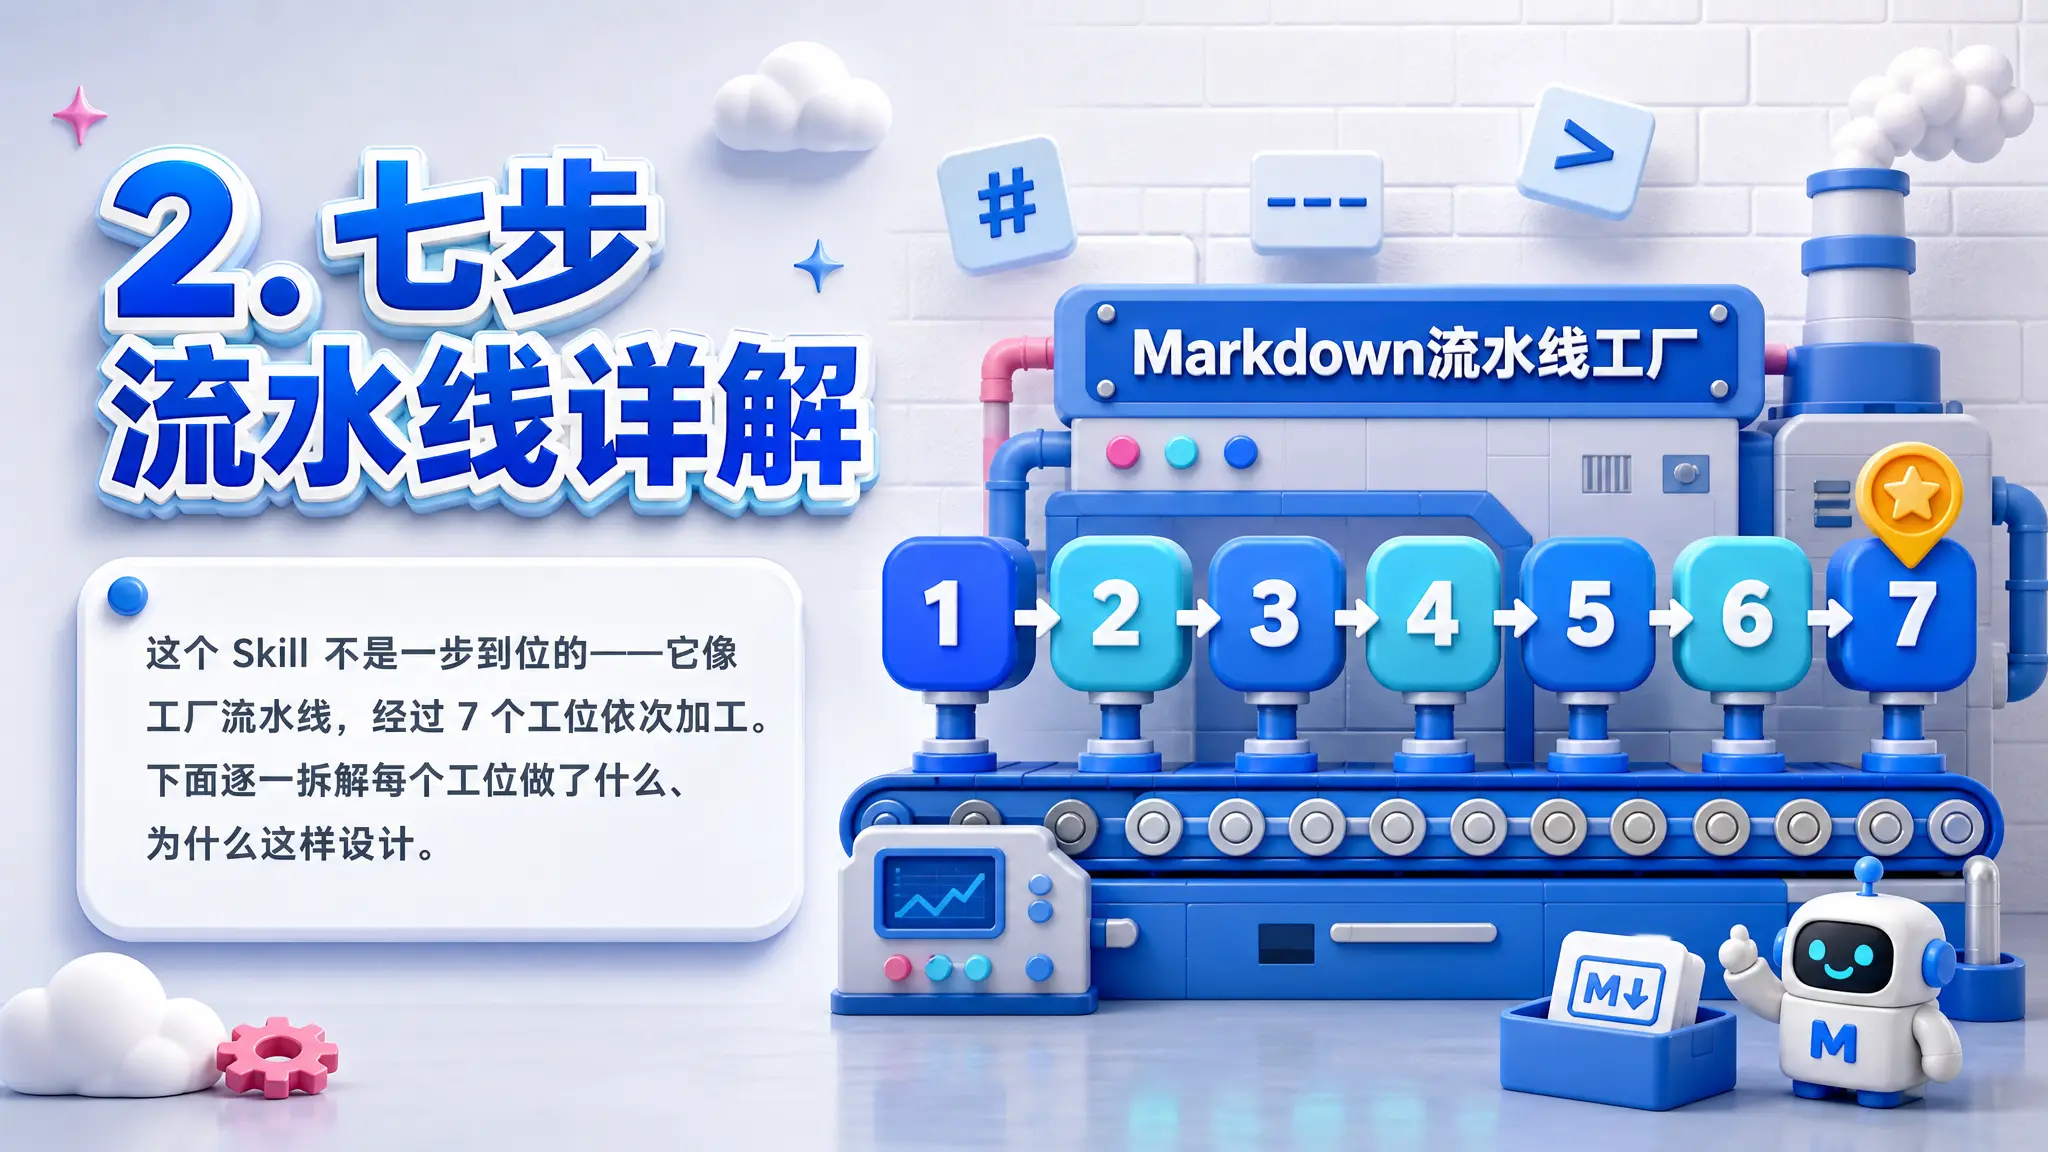
这个 Skill 不是一步到位的——它像工厂流水线,经过 7 个工位依次加工。下面逐一拆解每个工位做了什么、为什么这样设计。
Step 1:读取文件 & 检测内容类型
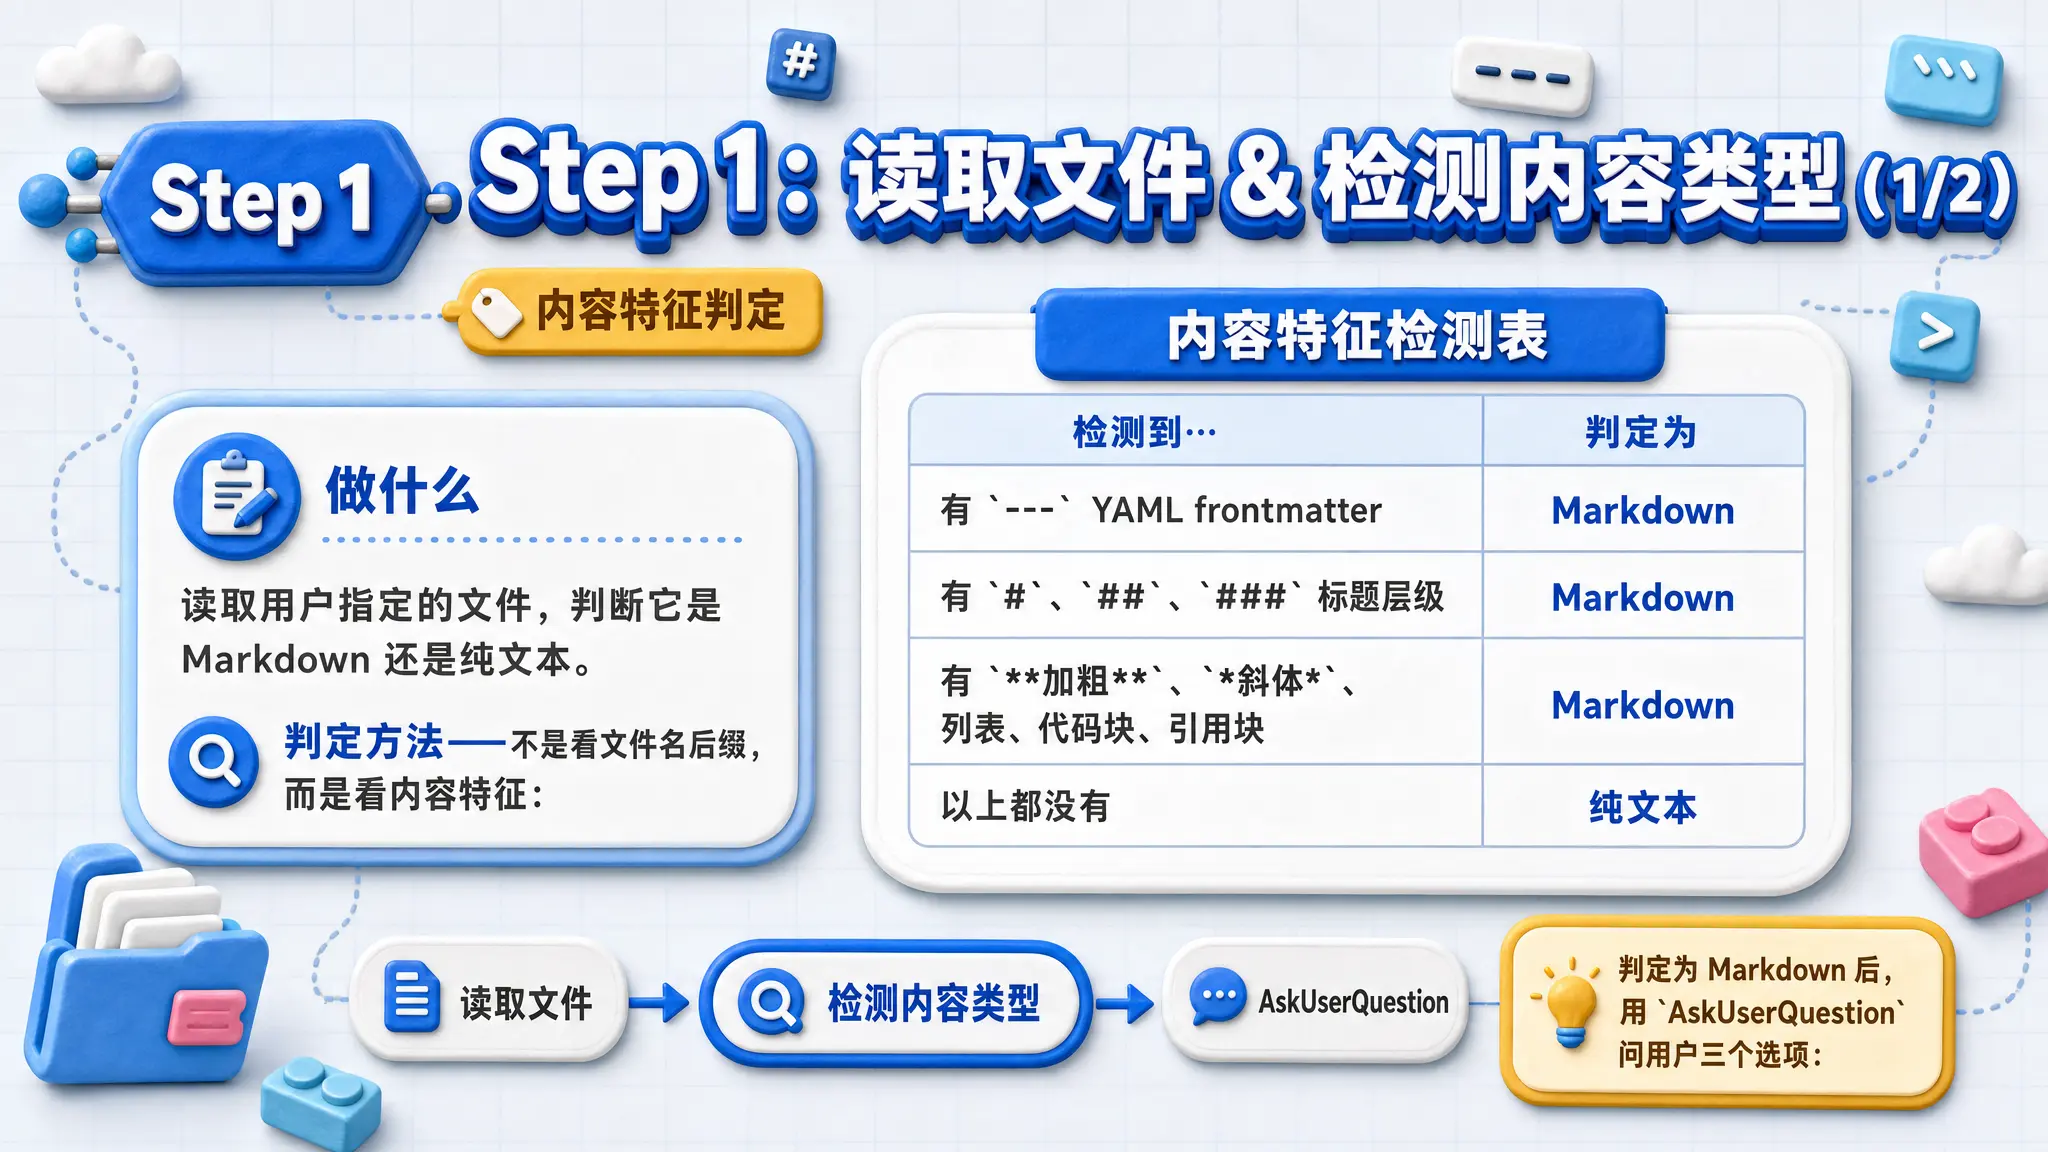
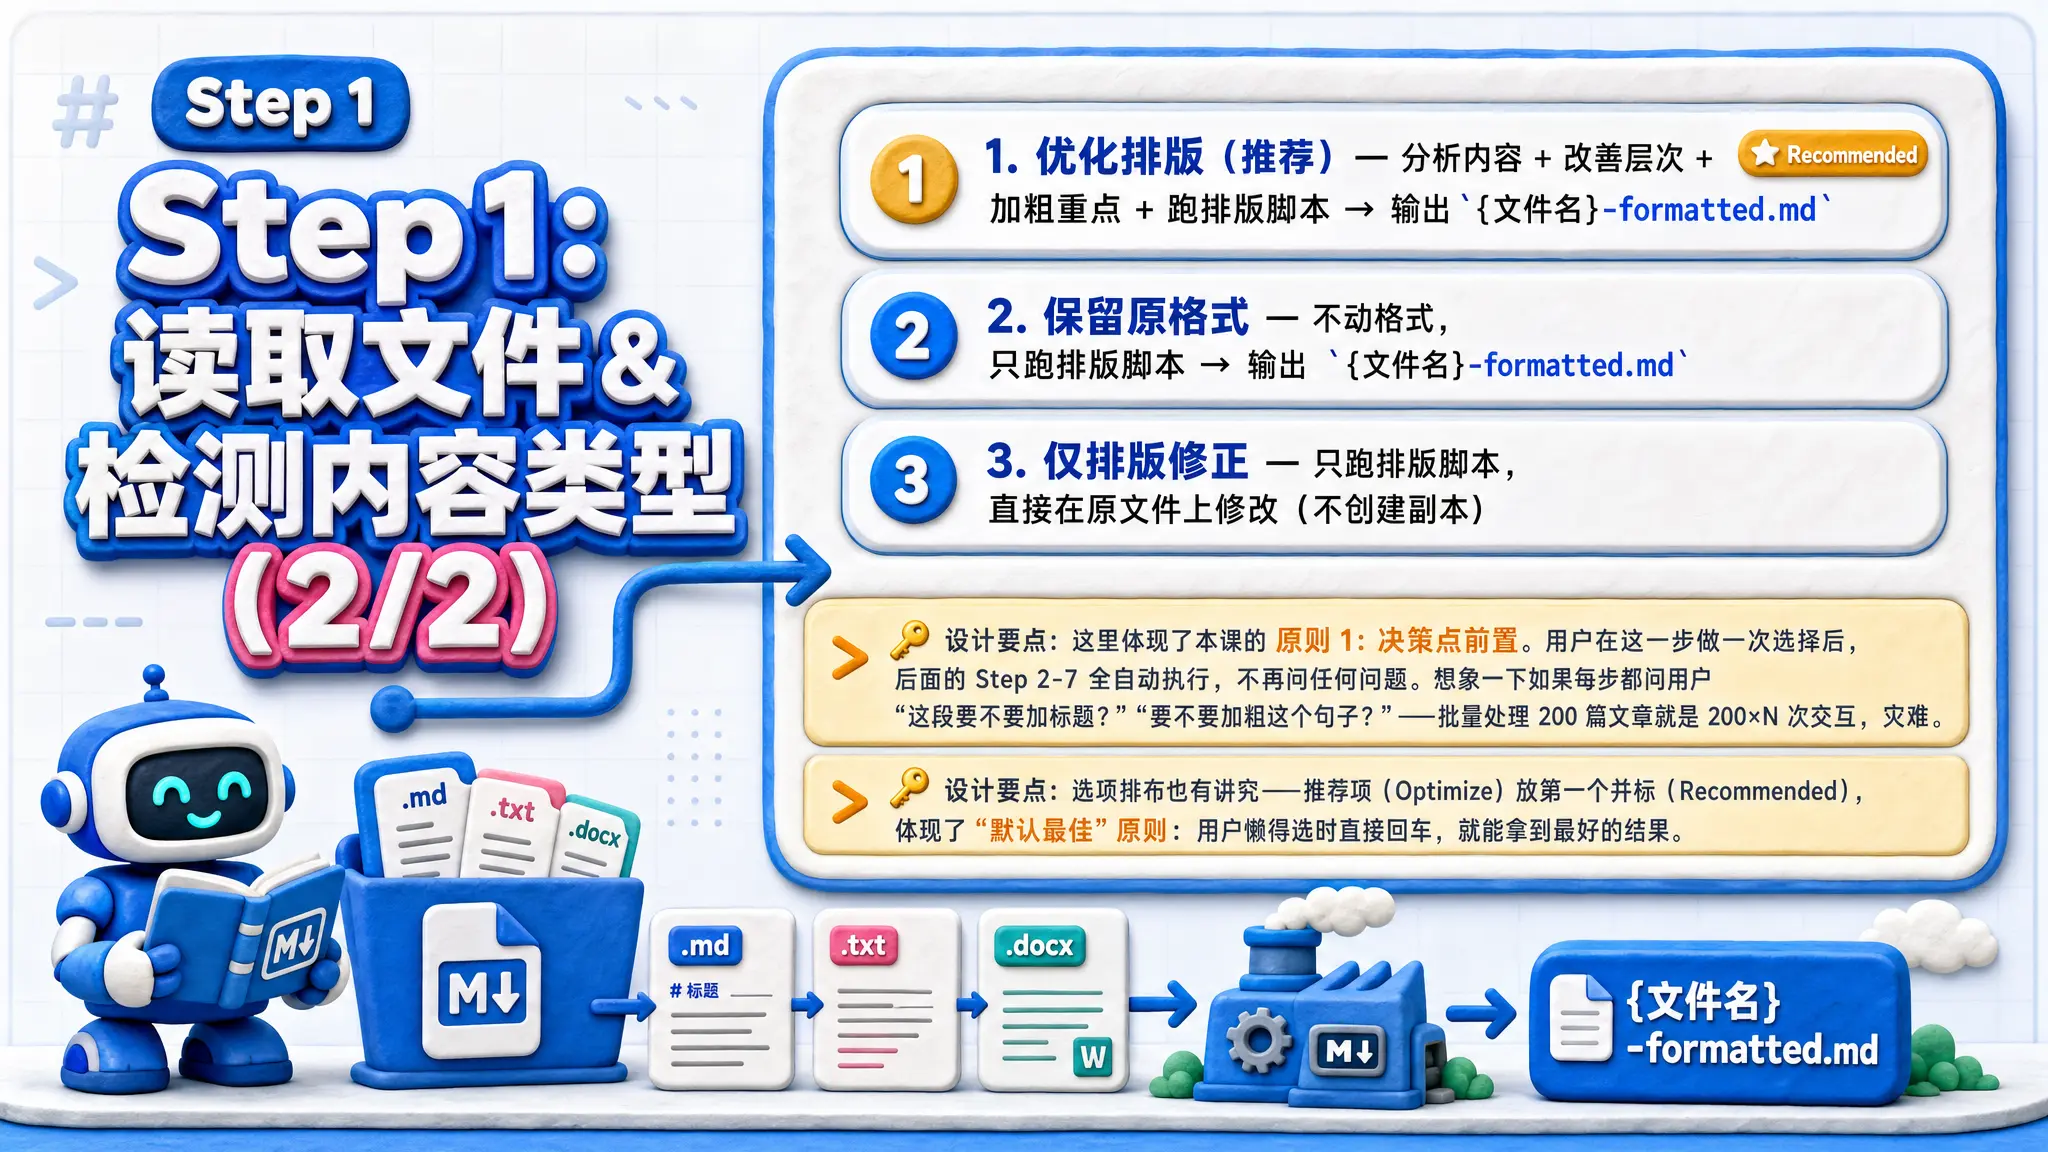
做什么:读取用户指定的文件,判断它是 Markdown 还是纯文本。
判定方法——不是看文件名后缀,而是看内容特征:
| 检测到… | 判定为 |
|---|---|
有 --- YAML frontmatter | Markdown |
有 #、##、### 标题层级 | Markdown |
有 **加粗**、*斜体*、列表、代码块、引用块 | Markdown |
| 以上都没有 | 纯文本 |
判定为 Markdown 后,用 AskUserQuestion 问用户三个选项:
- 优化排版(推荐) — 分析内容 + 改善层次 + 加粗重点 + 跑排版脚本 → 输出
{文件名}-formatted.md - 保留原格式 — 不动格式,只跑排版脚本 → 输出
{文件名}-formatted.md - 仅排版修正 — 只跑排版脚本,直接在原文件上修改(不创建副本)
🔑 设计要点:这里体现了本课的 原则 1:决策点前置。用户在这一步做一次选择后,后面的 Step 2-7 全自动执行,不再问任何问题。想象一下如果每步都问用户"这段要不要加标题?""要不要加粗这个句子?"——批量处理 200 篇文章就是 200×N 次交互,灾难。
🔑 设计要点:选项排布也有讲究——推荐项(Optimize)放第一个并标
(Recommended),体现了"默认最佳"原则:用户懒得选时直接回车,就能拿到最好的结果。
Step 2:读者视角分析
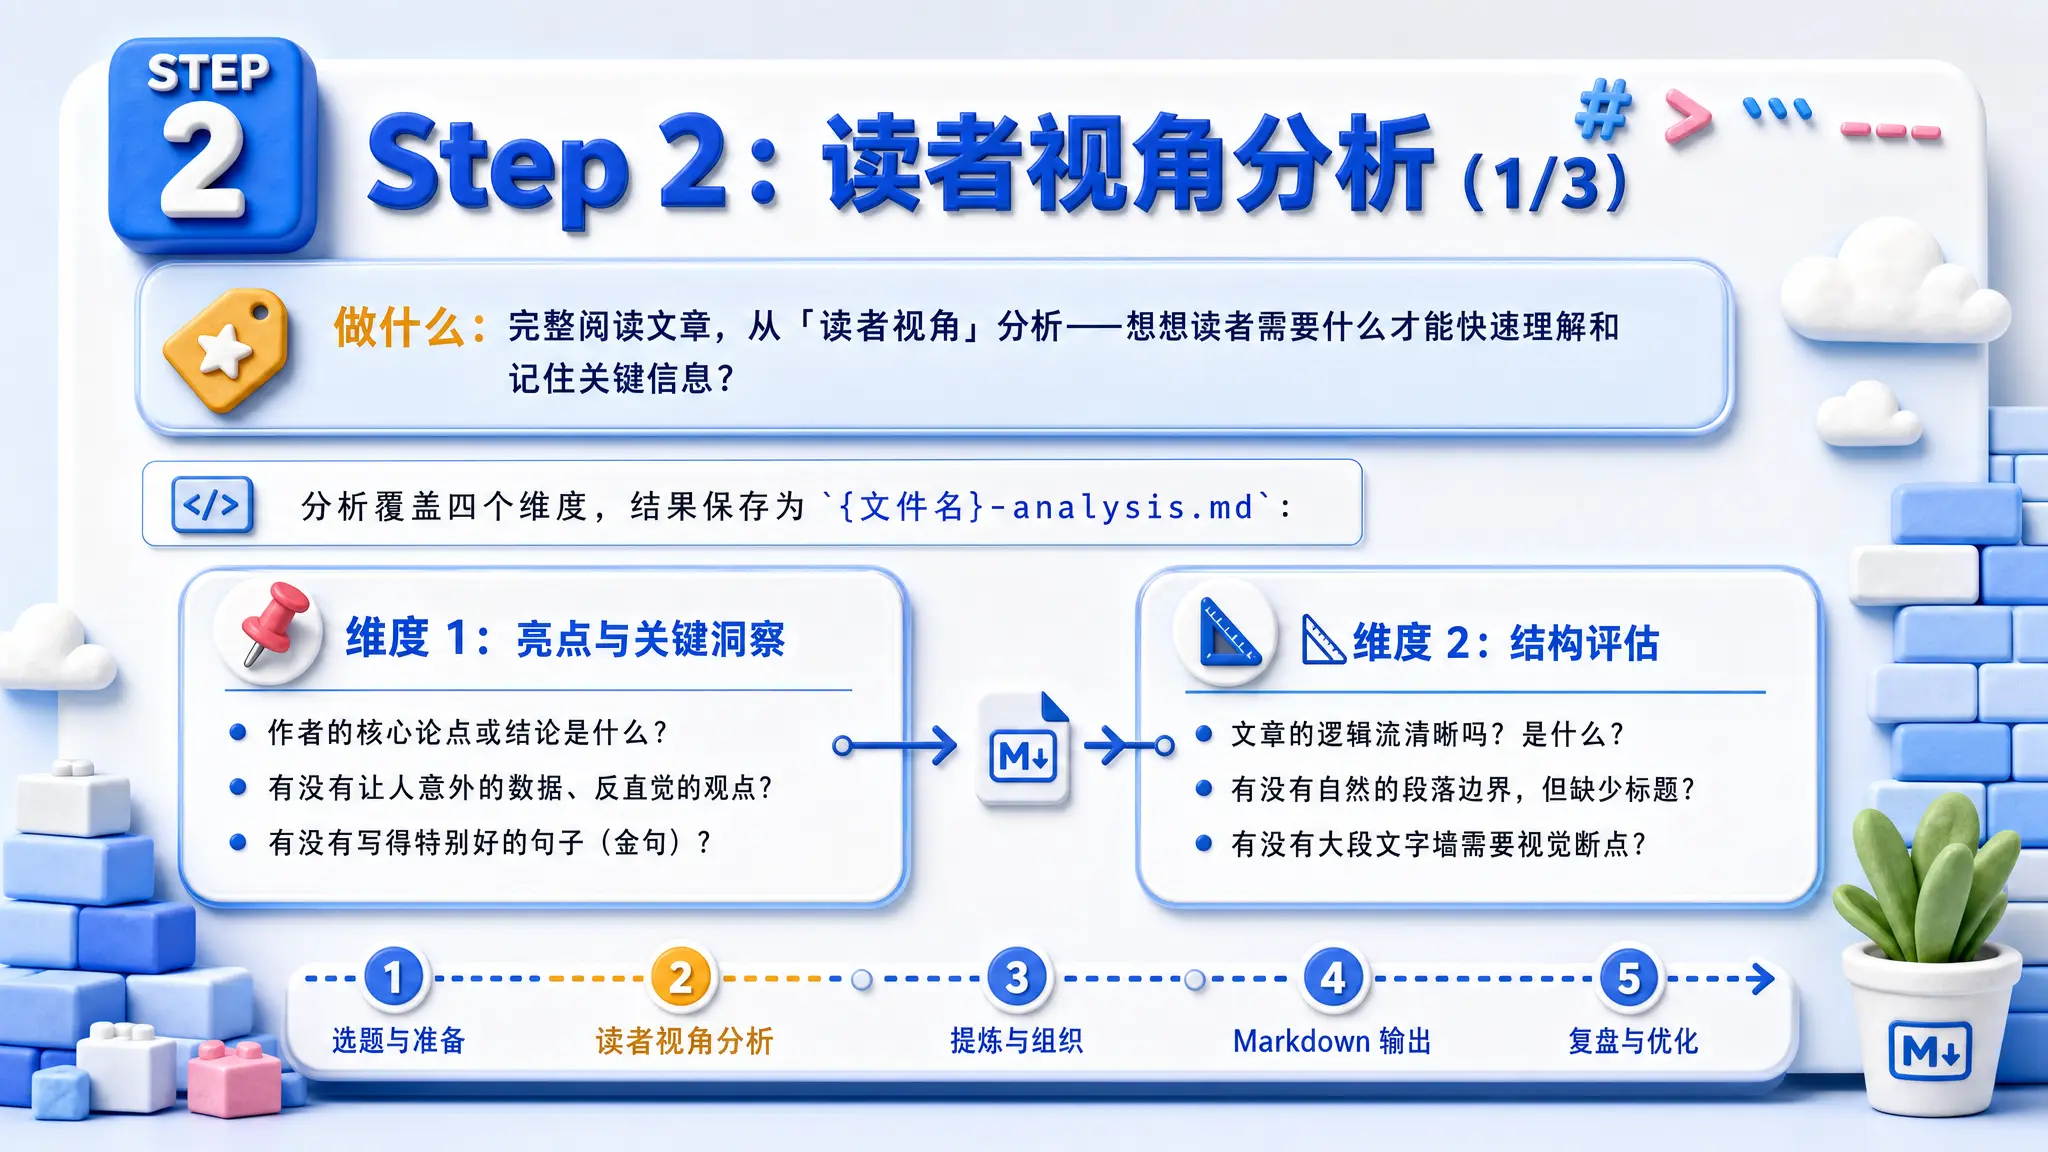
做什么:完整阅读文章,从「读者视角」分析——想想读者需要什么才能快速理解和记住关键信息?
分析覆盖四个维度,结果保存为 {文件名}-analysis.md:
📌 维度 1:亮点与关键洞察
- 作者的核心论点或结论是什么?
- 有没有让人意外的数据、反直觉的观点?
- 有没有写得特别好的句子(金句)?
📐 维度 2:结构评估
- 文章的逻辑流清晰吗?是什么?
- 有没有自然的段落边界,但缺少标题?
- 有没有大段文字墙需要视觉断点?
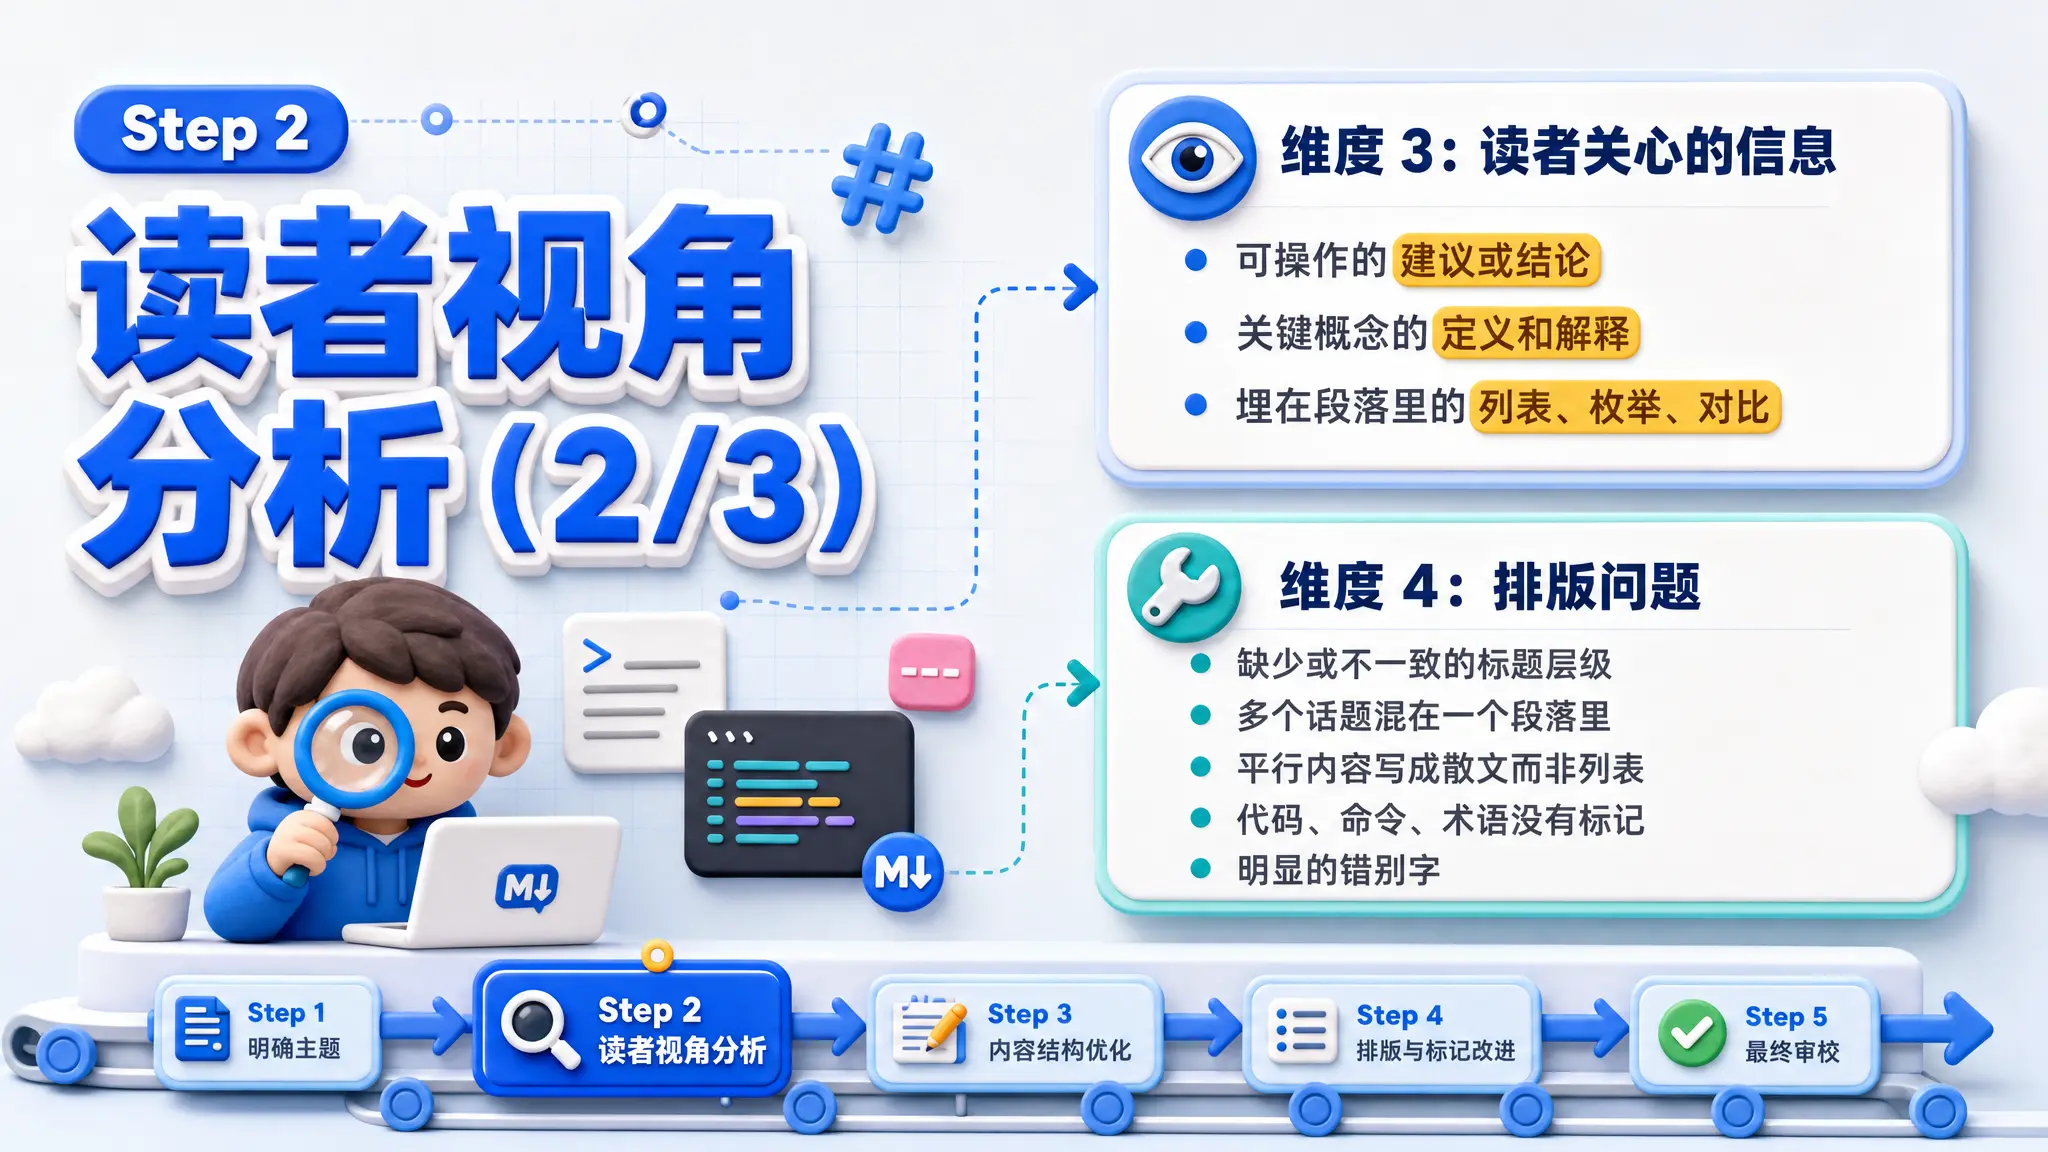
👁️ 维度 3:读者关心的信息
- 可操作的建议或结论
- 关键概念的定义和解释
- 埋在段落里的列表、枚举、对比
🔧 维度 4:排版问题
- 缺少或不一致的标题层级
- 多个话题混在一个段落里
- 平行内容写成散文而非列表
- 代码、命令、术语没有标记
- 明显的错别字
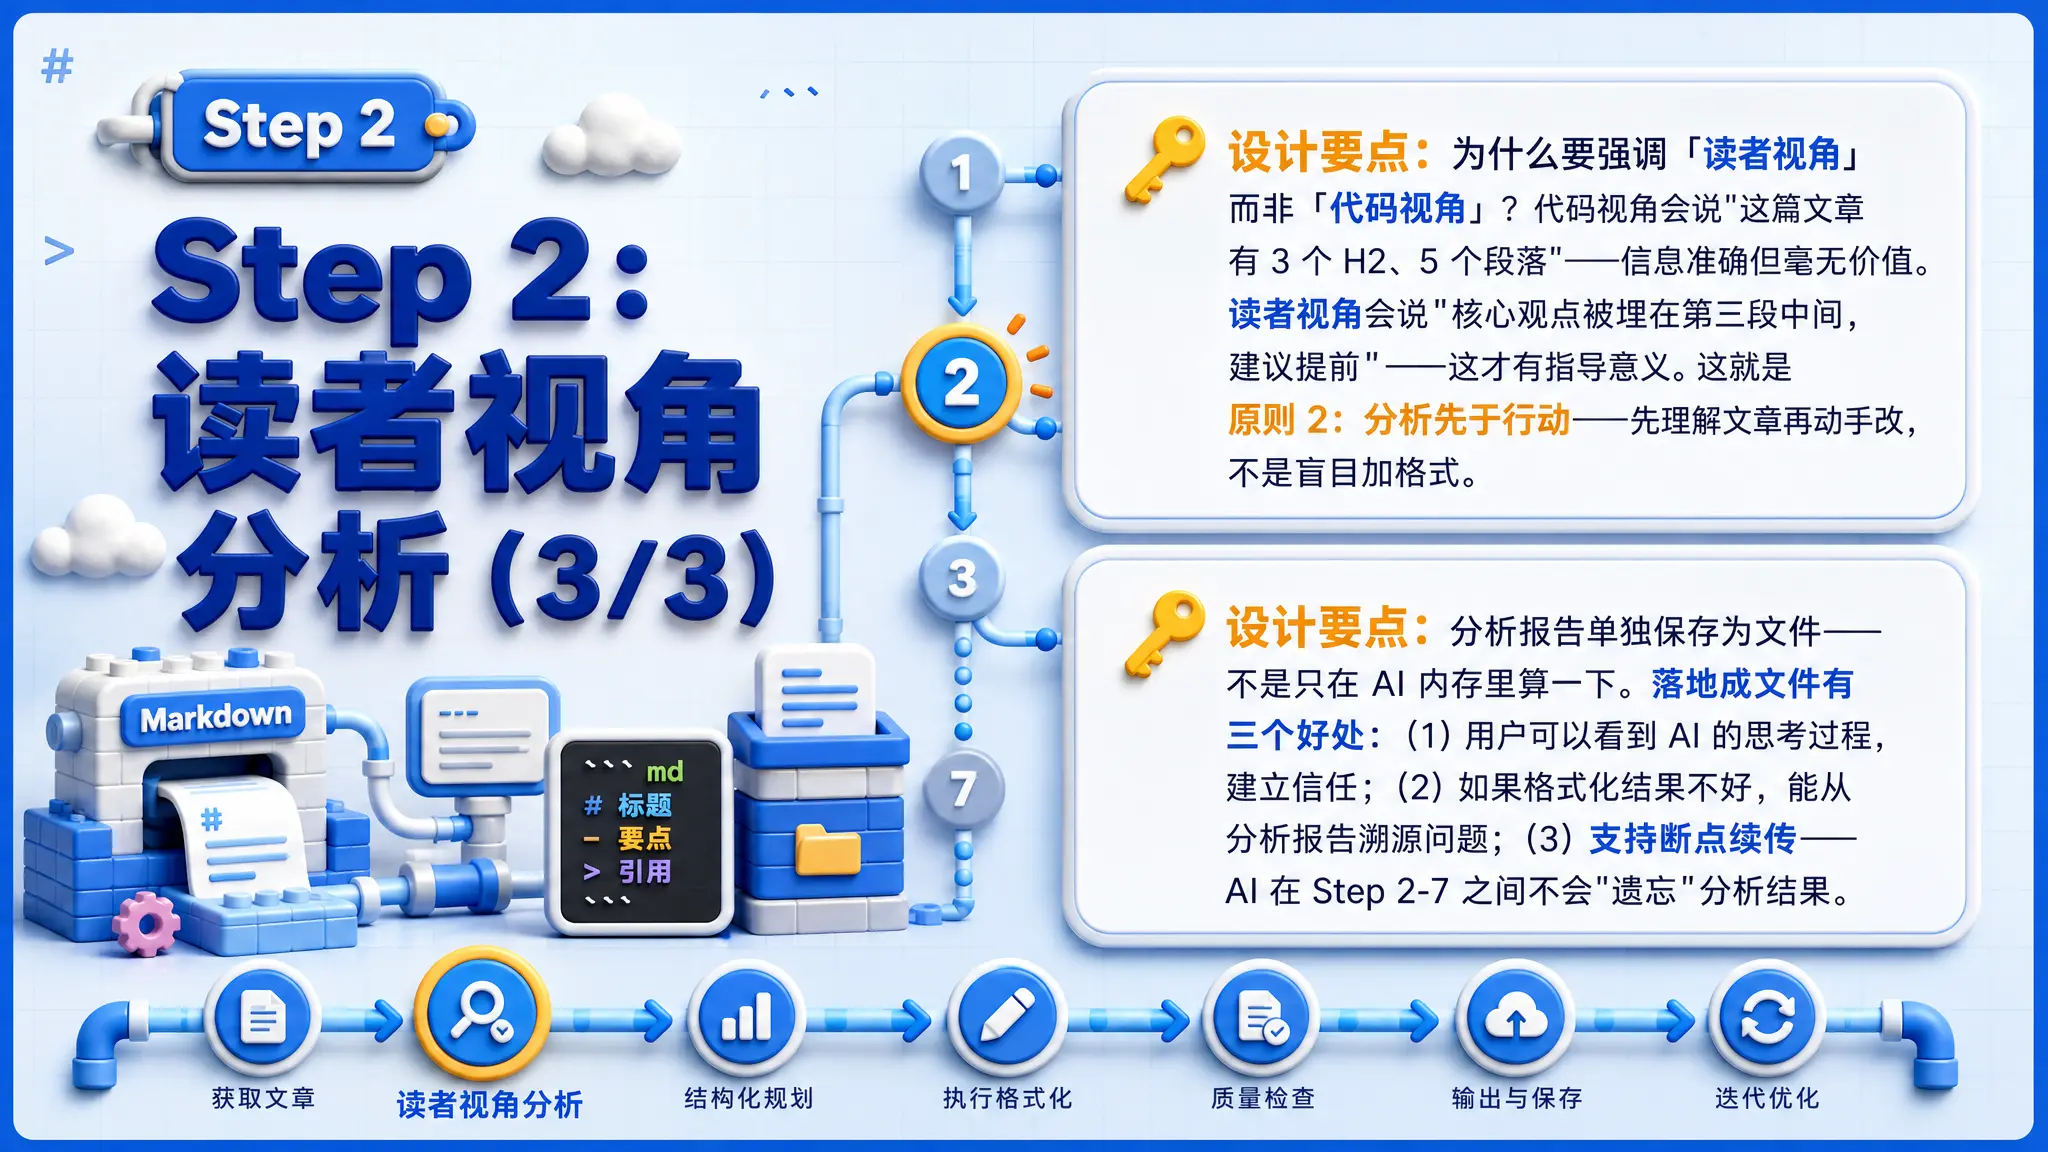
🔑 设计要点:为什么要强调「读者视角」而非「代码视角」?代码视角会说"这篇文章有 3 个 H2、5 个段落"——信息准确但毫无价值。读者视角会说"核心观点被埋在第三段中间,建议提前"——这才有指导意义。这就是 原则 2:分析先于行动——先理解文章再动手改,不是盲目加格式。
🔑 设计要点:分析报告单独保存为文件——不是只在 AI 内存里算一下。落地成文件有三个好处:(1) 用户可以看到 AI 的思考过程,建立信任;(2) 如果格式化结果不好,能从分析报告溯源问题;(3) 支持断点续传——AI 在 Step 2-7 之间不会"遗忘"分析结果。
Step 3:生成/优化前置元数据、标题与摘要
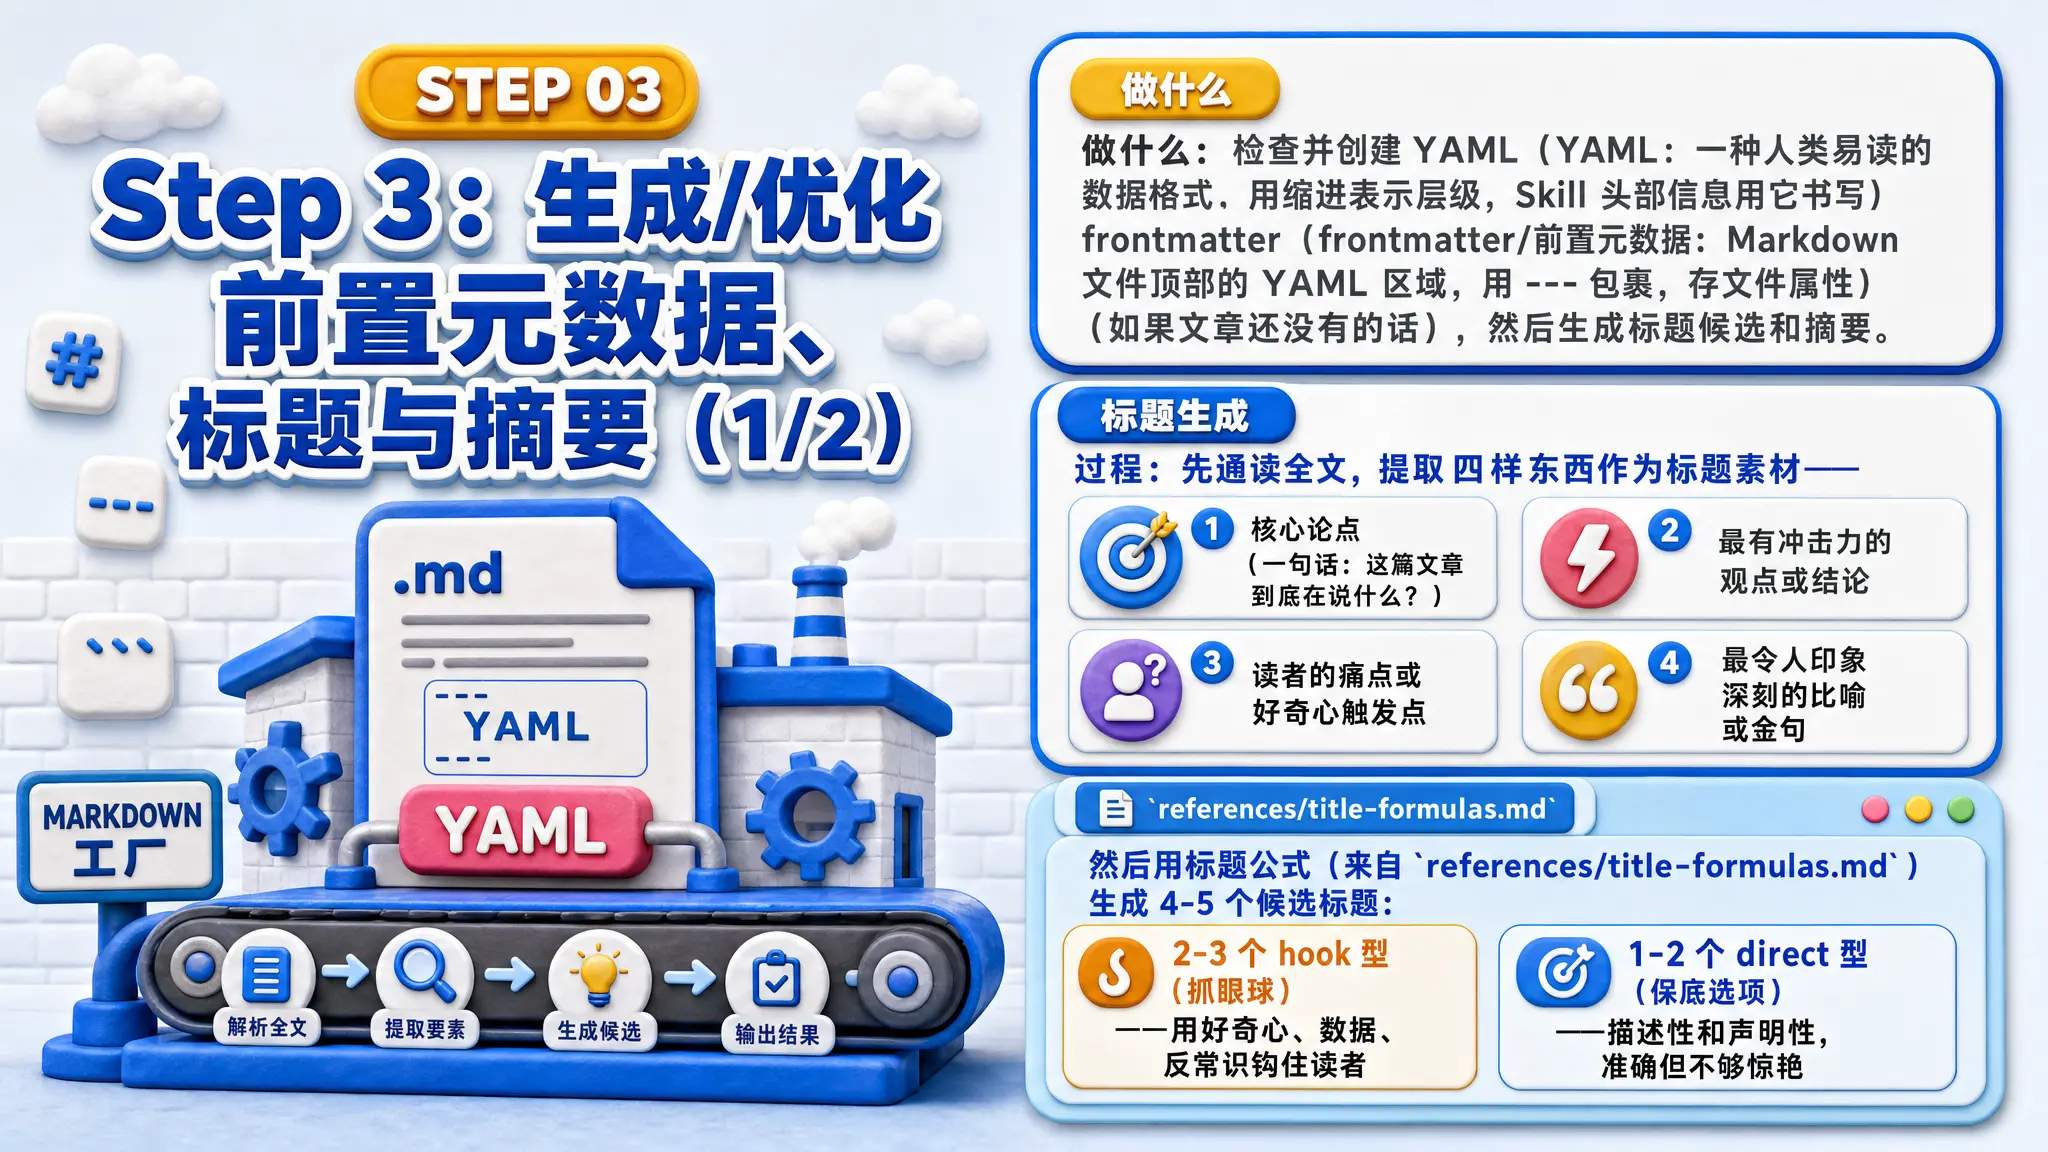
做什么:检查并创建 YAML(YAML:一种人类易读的数据格式,用缩进表示层级,Skill 头部信息用它书写) frontmatter(frontmatter/前置元数据:Markdown 文件顶部的 YAML 区域,用 --- 包裹,存文件属性)(如果文章还没有的话),然后生成标题候选和摘要。
标题生成
过程:先通读全文,提取四样东西作为标题素材——
- 核心论点(一句话:这篇文章到底在说什么?)
- 最有冲击力的观点或结论
- 读者的痛点或好奇心触发点
- 最令人印象深刻的比喻或金句
然后用标题公式(来自 references/title-formulas.md)生成 4-5 个候选标题:
- 2-3 个 hook 型(抓眼球)——用好奇心、数据、反常识钩住读者
- 1-2 个 direct 型(保底选项)——描述性和声明性,准确但不够惊艳
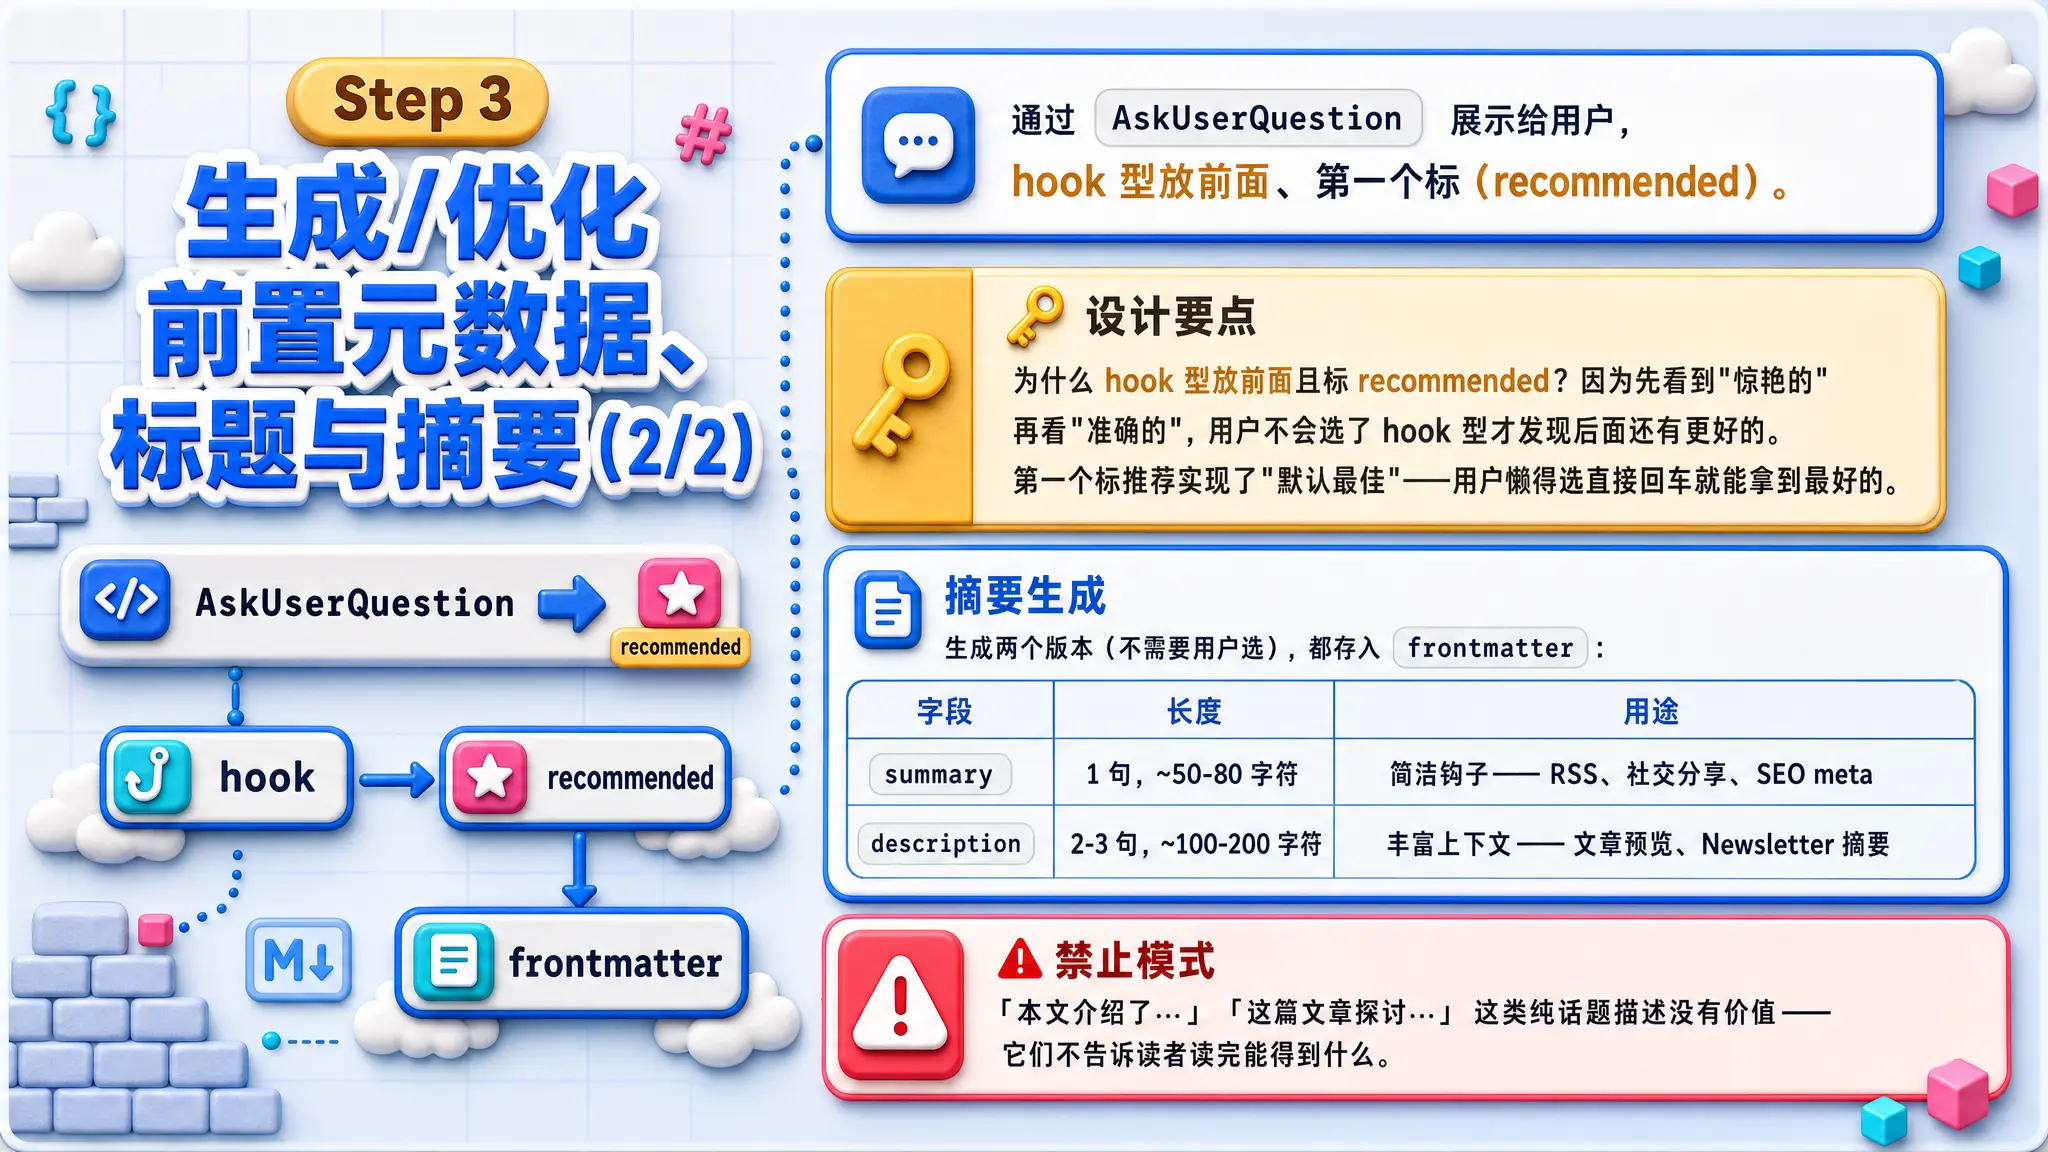
通过 AskUserQuestion 展示给用户,hook 型放前面、第一个标 (recommended)。
🔑 设计要点:为什么 hook 型放前面且标 recommended?因为先看到"惊艳的"再看"准确的",用户不会选了 hook 型才发现后面还有更好的。第一个标推荐实现了"默认最佳"——用户懒得选直接回车就能拿到最好的。
摘要生成
生成两个版本(不需要用户选),都存入 frontmatter:
| 字段 | 长度 | 用途 |
|---|---|---|
summary | 1 句,~50-80 字符 | 简洁钩子——RSS、社交分享、SEO meta |
description | 2-3 句,~100-200 字符 | 丰富上下文——文章预览、Newsletter 摘要 |
⚠️ 禁止模式:「本文介绍了…」「这篇文章探讨…」这类纯话题描述没有价值——它们不告诉读者读完能得到什么。
Step 4:格式化正文
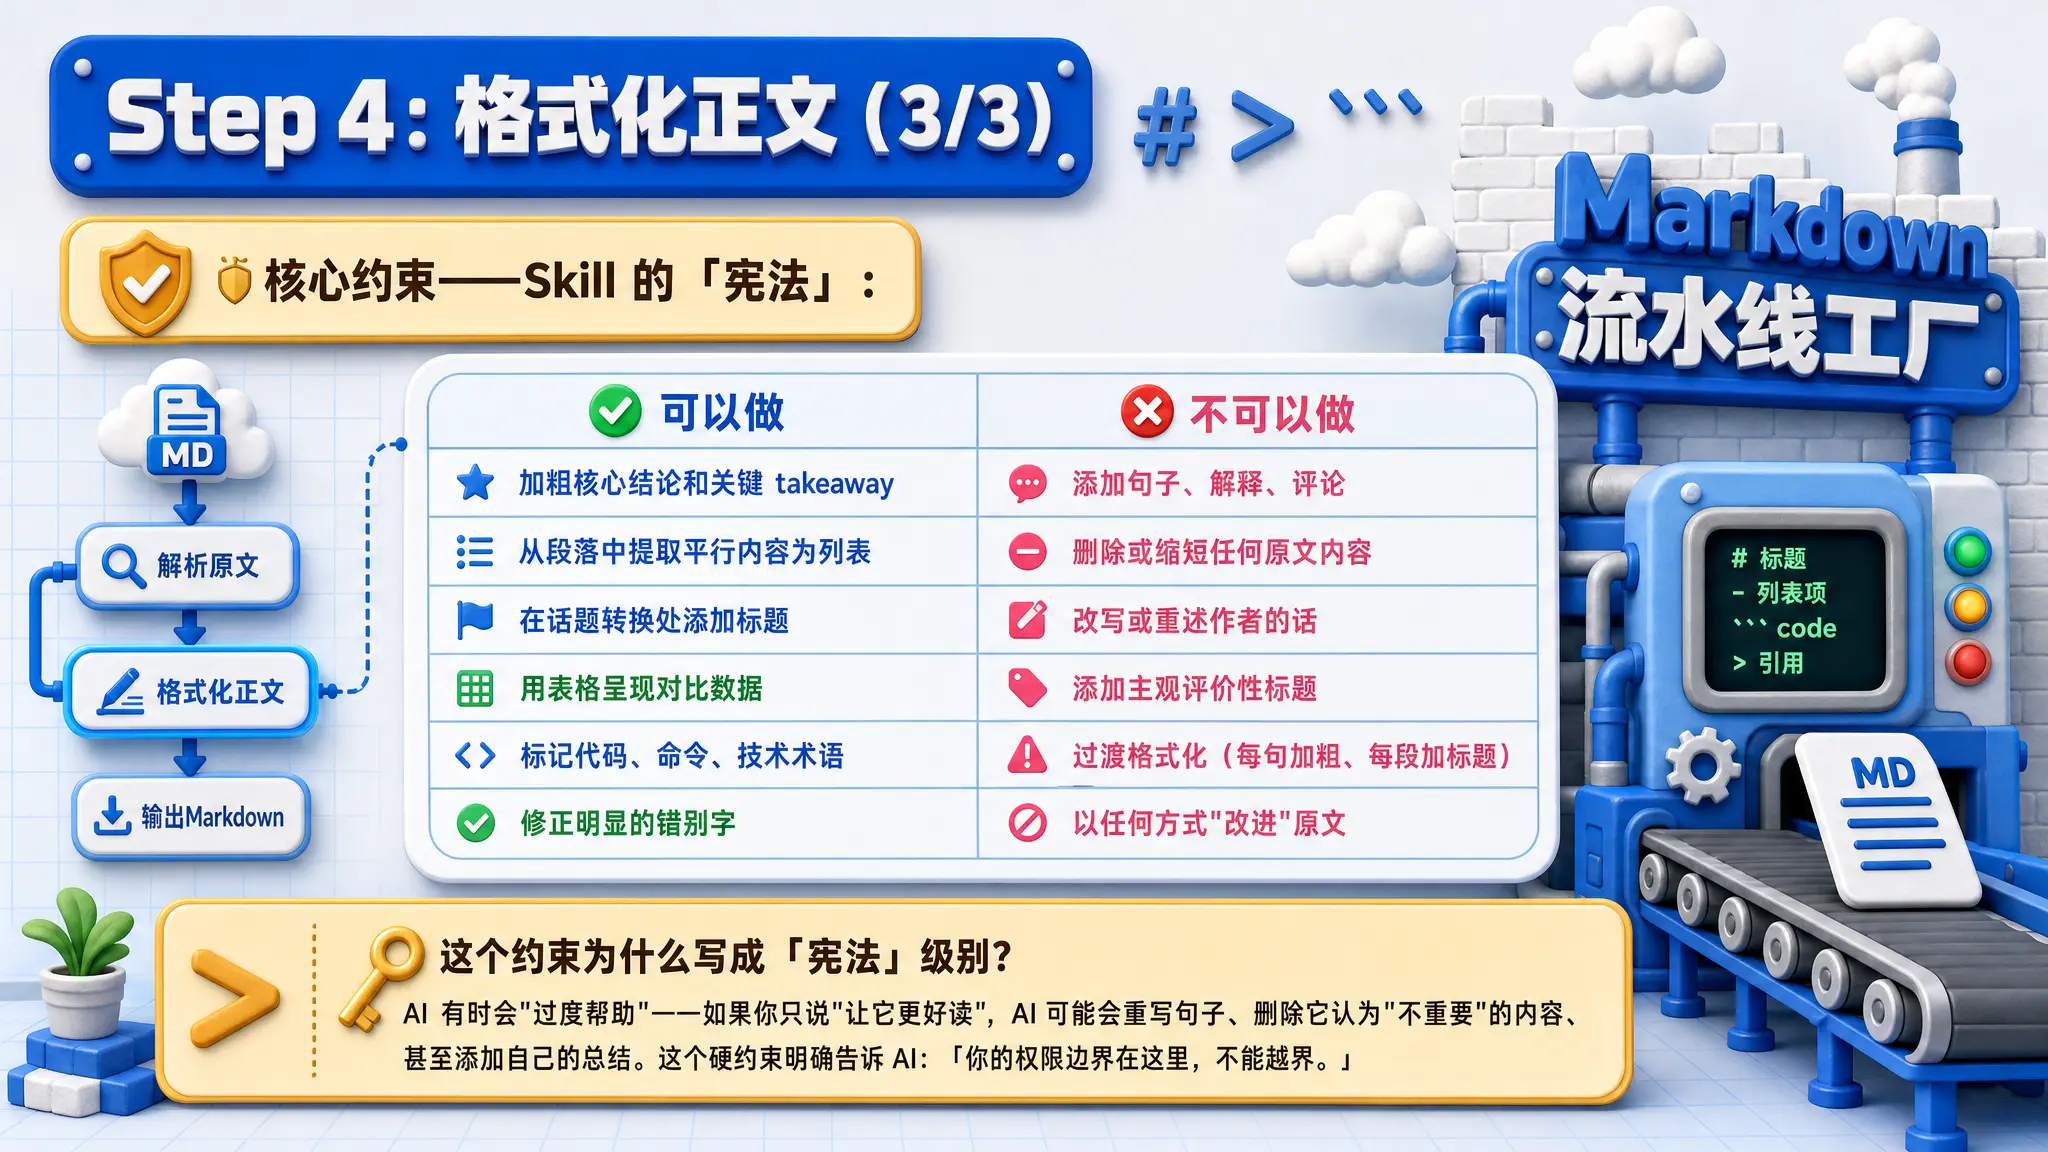
做什么:基于 Step 2 的分析结果,对正文进行格式化——这是流水线的核心工位。
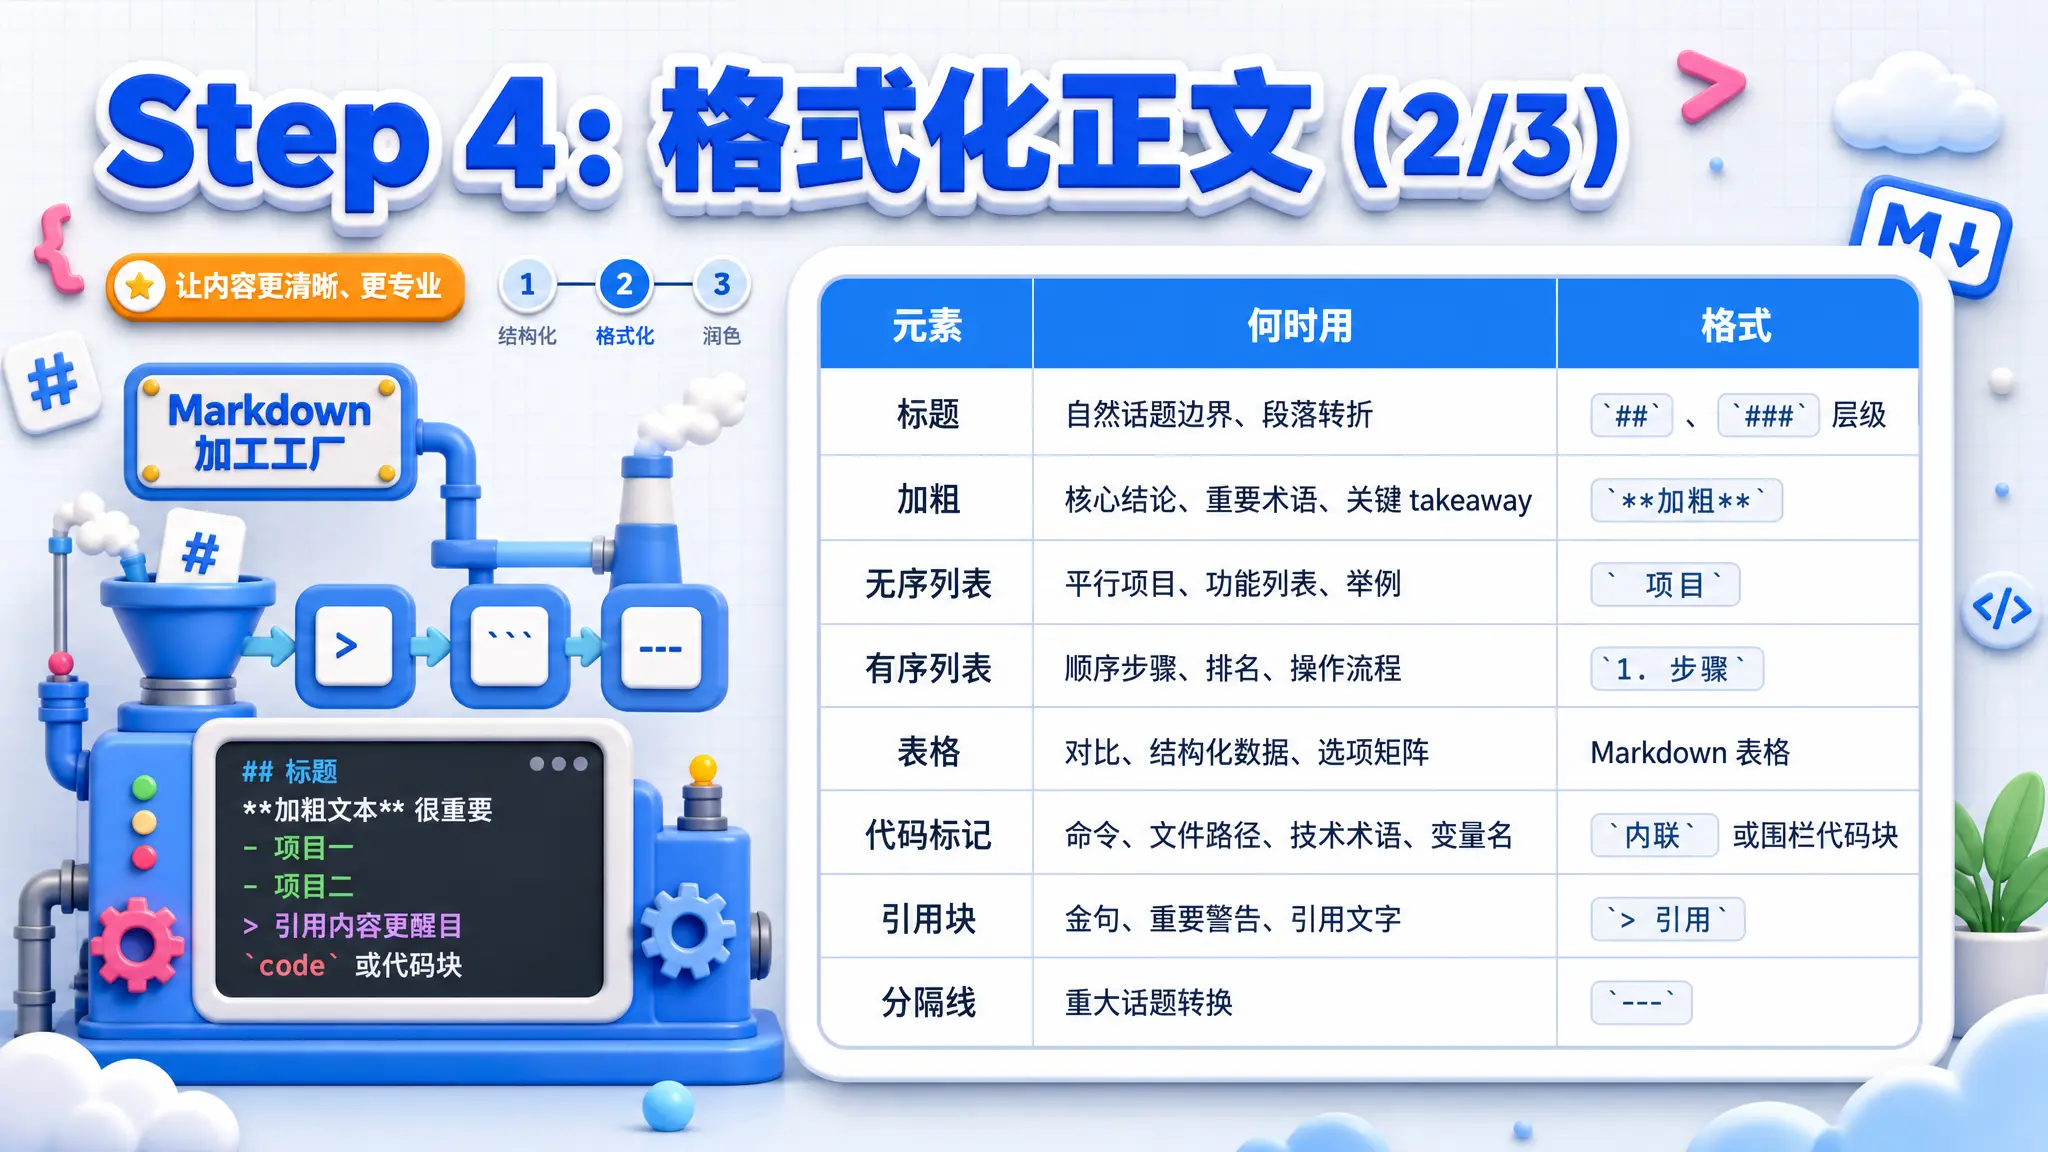
格式化工具箱:
| 元素 | 何时用 | 格式 |
|---|---|---|
| 标题 | 自然话题边界、段落转折 | ##、### 层级 |
| 加粗 | 核心结论、重要术语、关键 takeaway | **加粗** |
| 无序列表 | 平行项目、功能列表、举例 | - 项目 |
| 有序列表 | 顺序步骤、排名、操作流程 | 1. 步骤 |
| 表格 | 对比、结构化数据、选项矩阵 | Markdown 表格 |
| 代码标记 | 命令、文件路径、技术术语、变量名 | `内联` 或围栏代码块 |
| 引用块 | 金句、重要警告、引用文字 | > 引用 |
| 分隔线 | 重大话题转换 | --- |
🛡️ 核心约束——Skill 的「宪法」:
| ✅ 可以做 | ❌ 不可以做 |
|---|---|
| 加粗核心结论和关键 takeaway | 添加句子、解释、评论 |
| 从段落中提取平行内容为列表 | 删除或缩短任何原文内容 |
| 在话题转换处添加标题 | 改写或重述作者的话 |
| 用表格呈现对比数据 | 添加主观评价性标题 |
| 标记代码、命令、技术术语 | 过渡格式化(每句加粗、每段加标题) |
| 修正明显的错别字 | 以任何方式"改进"原文 |
🔑 这个约束为什么写成「宪法」级别? AI 有时会"过度帮助"——如果你只说"让它更好读",AI 可能会重写句子、删除它认为"不重要"的内容、甚至添加自己的总结。这个硬约束明确告诉 AI:「你的权限边界在这里,不能越界。」
Step 5:保存格式化文件
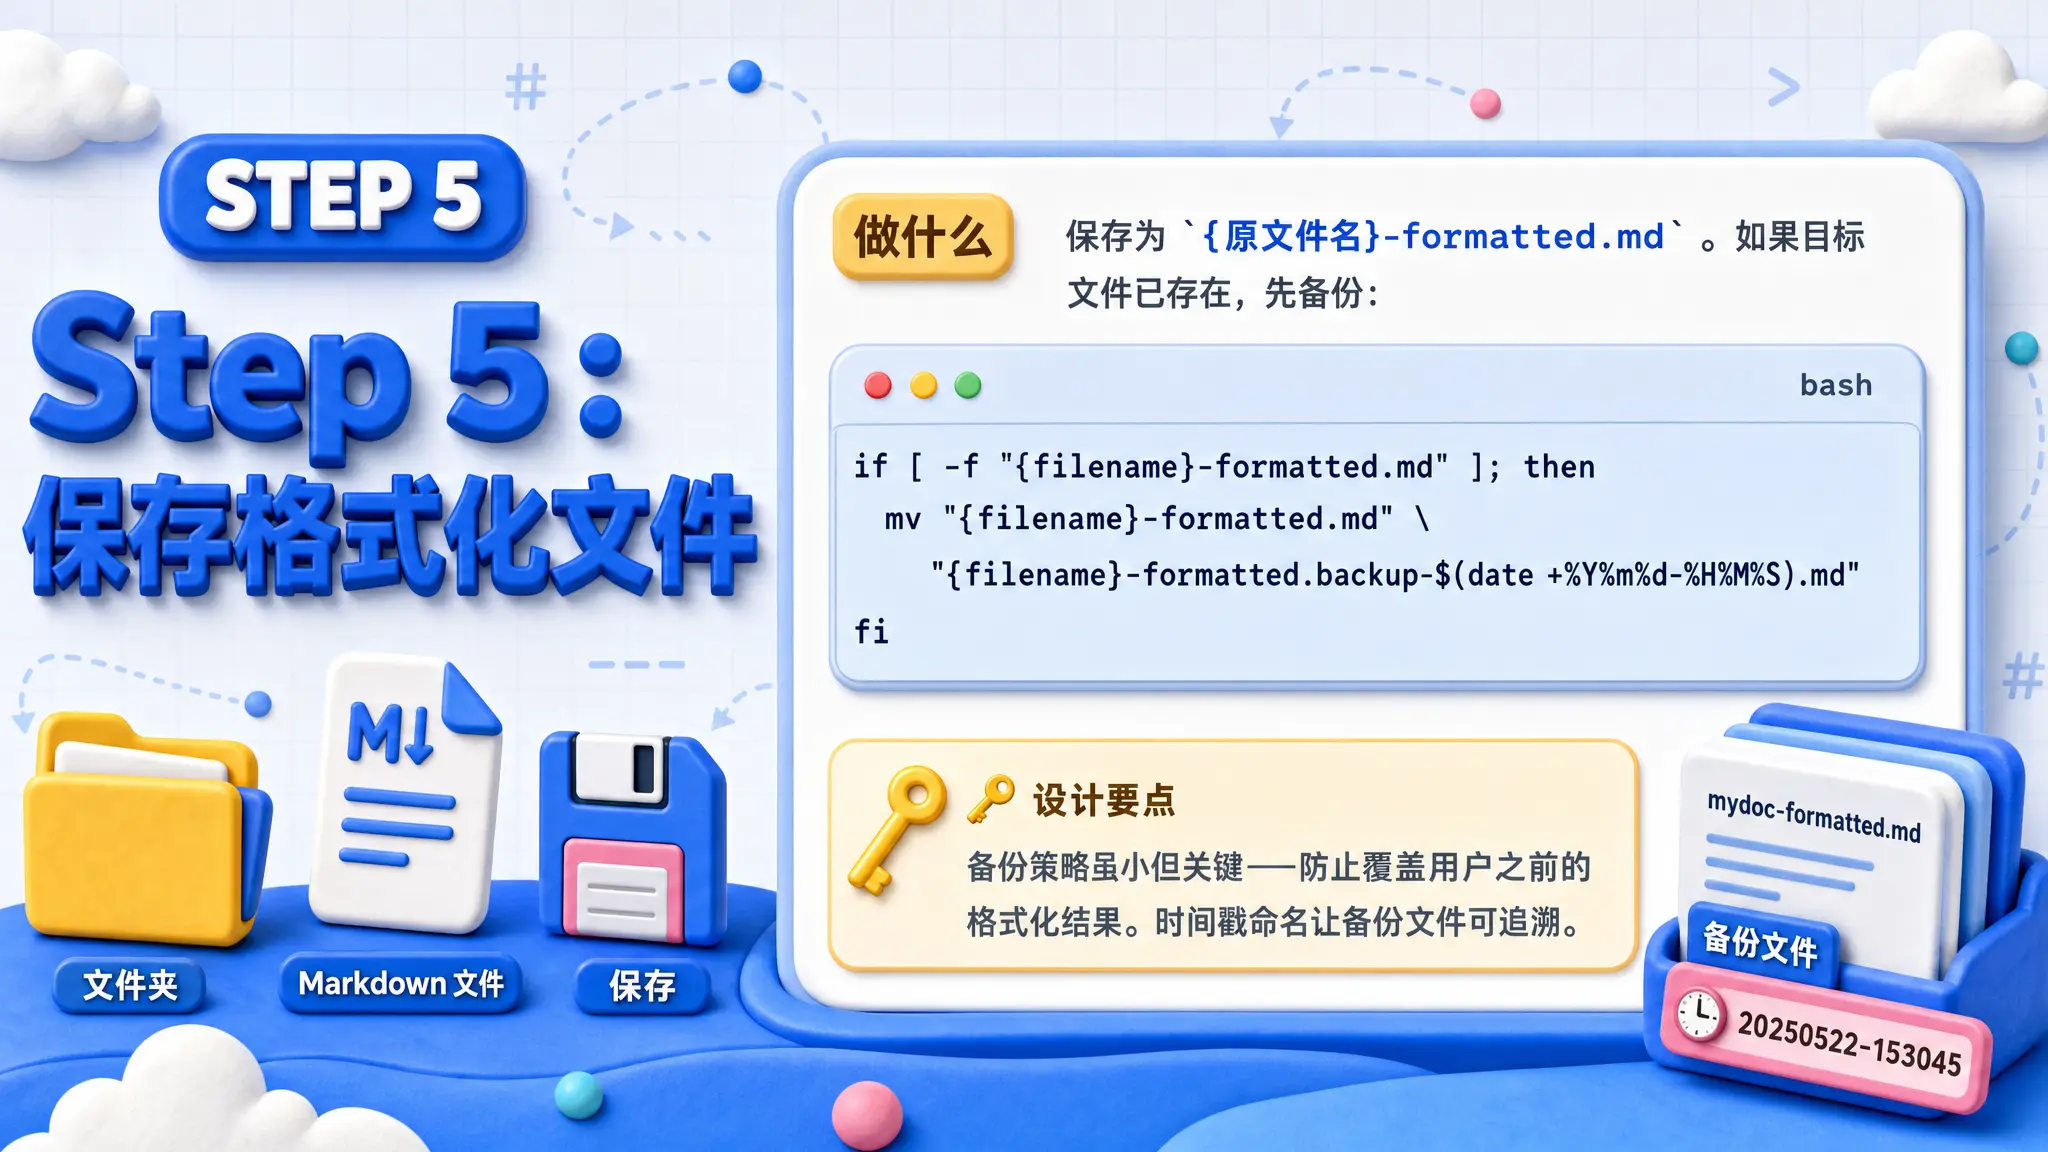
做什么:保存为 {原文件名}-formatted.md。如果目标文件已存在,先备份:
if [ -f "{filename}-formatted.md" ]; then
  mv "{filename}-formatted.md" "{filename}-formatted.backup-$(date +%Y%m%d-%H%M%S).md"
fi
🔑 设计要点:备份策略虽小但关键——防止覆盖用户之前的格式化结果。时间戳命名让备份文件可追溯。
Step 6:排版脚本修正
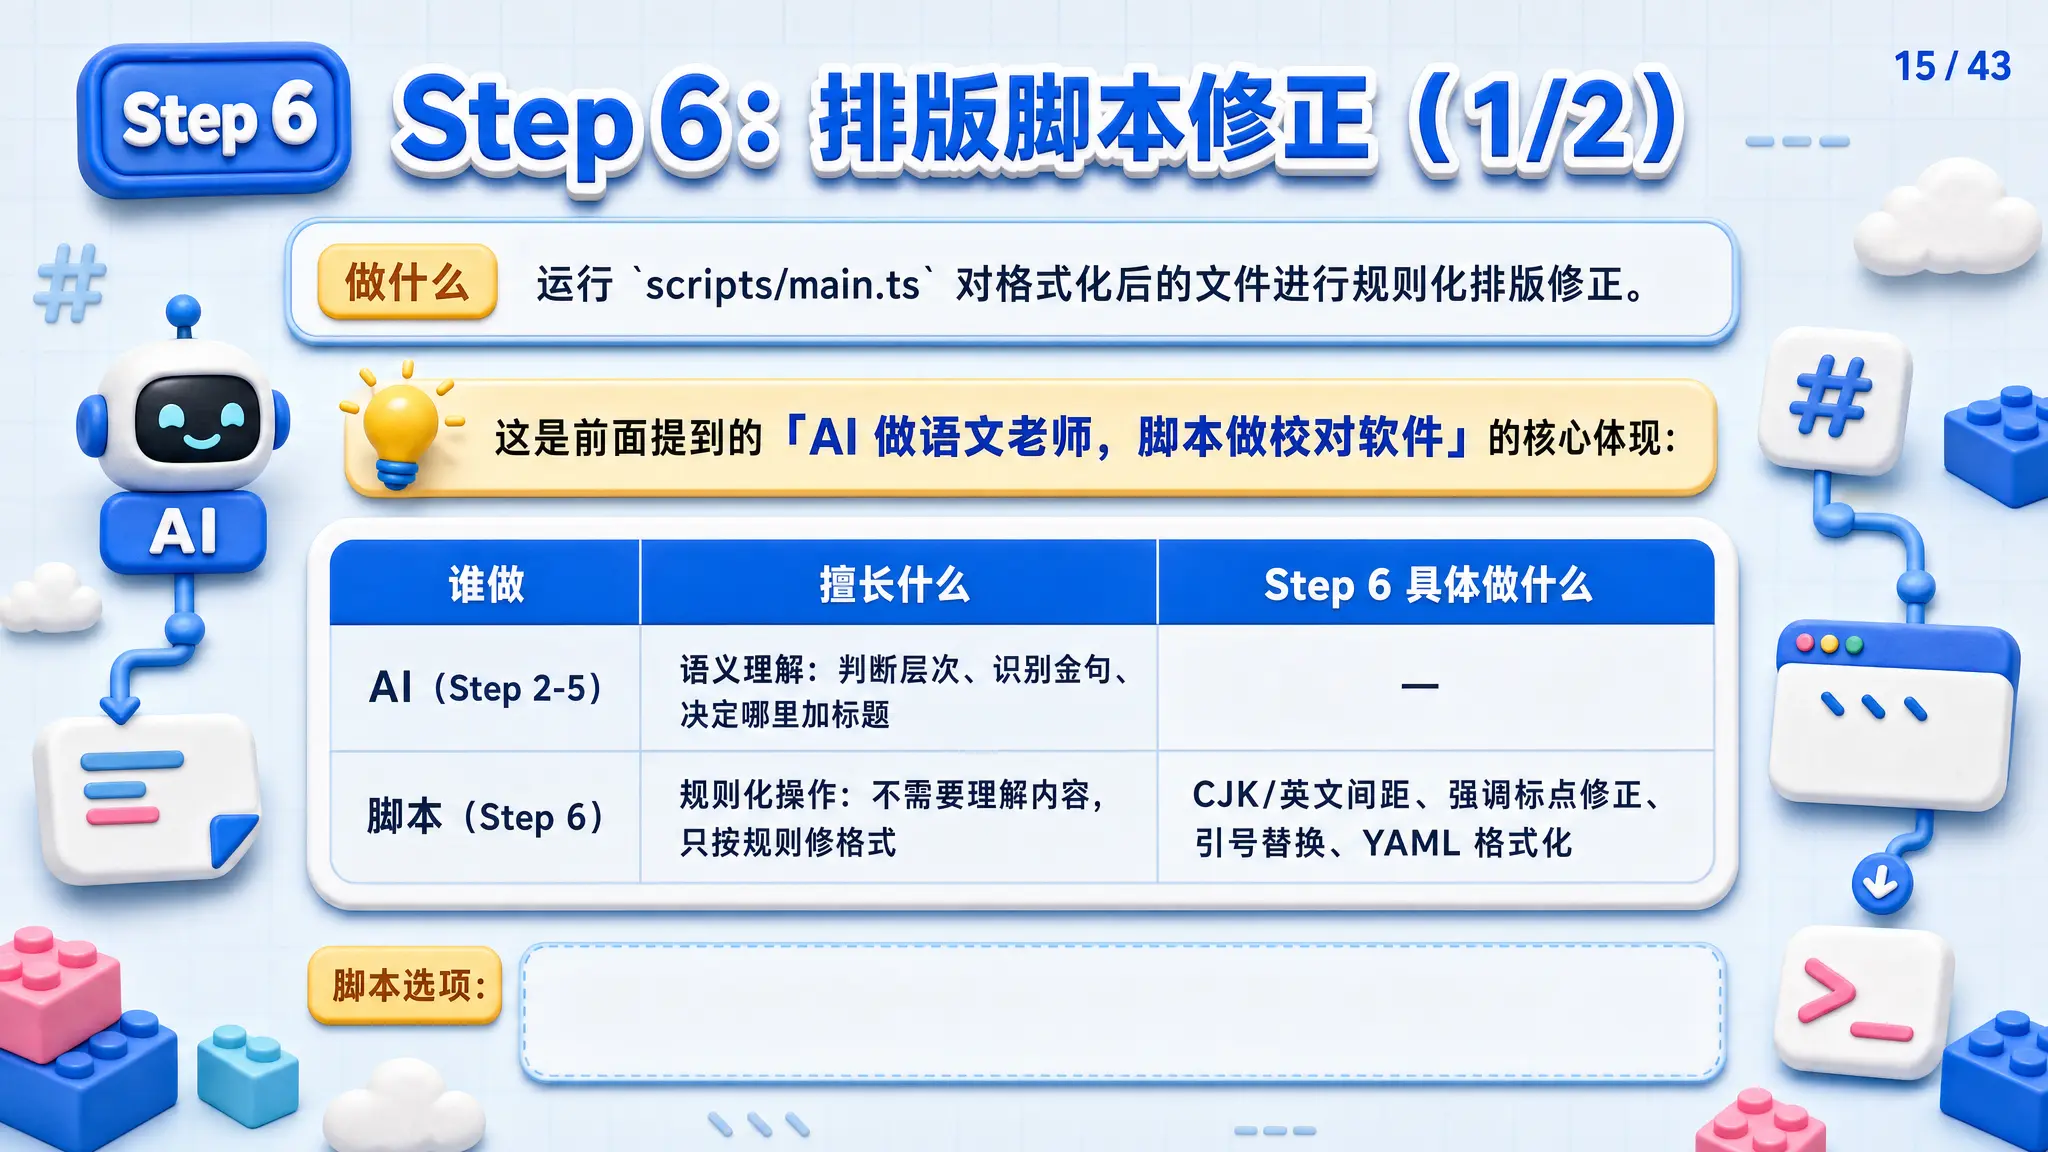
做什么:运行 scripts/main.ts 对格式化后的文件进行规则化排版修正。
这是前面提到的「AI 做语文老师,脚本做校对软件」的核心体现:
| 谁做 | 擅长什么 | Step 6 具体做什么 |
|---|---|---|
| AI(Step 2-5) | 语义理解:判断层次、识别金句、决定哪里加标题 | — |
| 脚本(Step 6) | 规则化操作:不需要理解内容,只按规则修格式 | CJK/英文间距、强调标点修正、引号替换、YAML 格式化 |
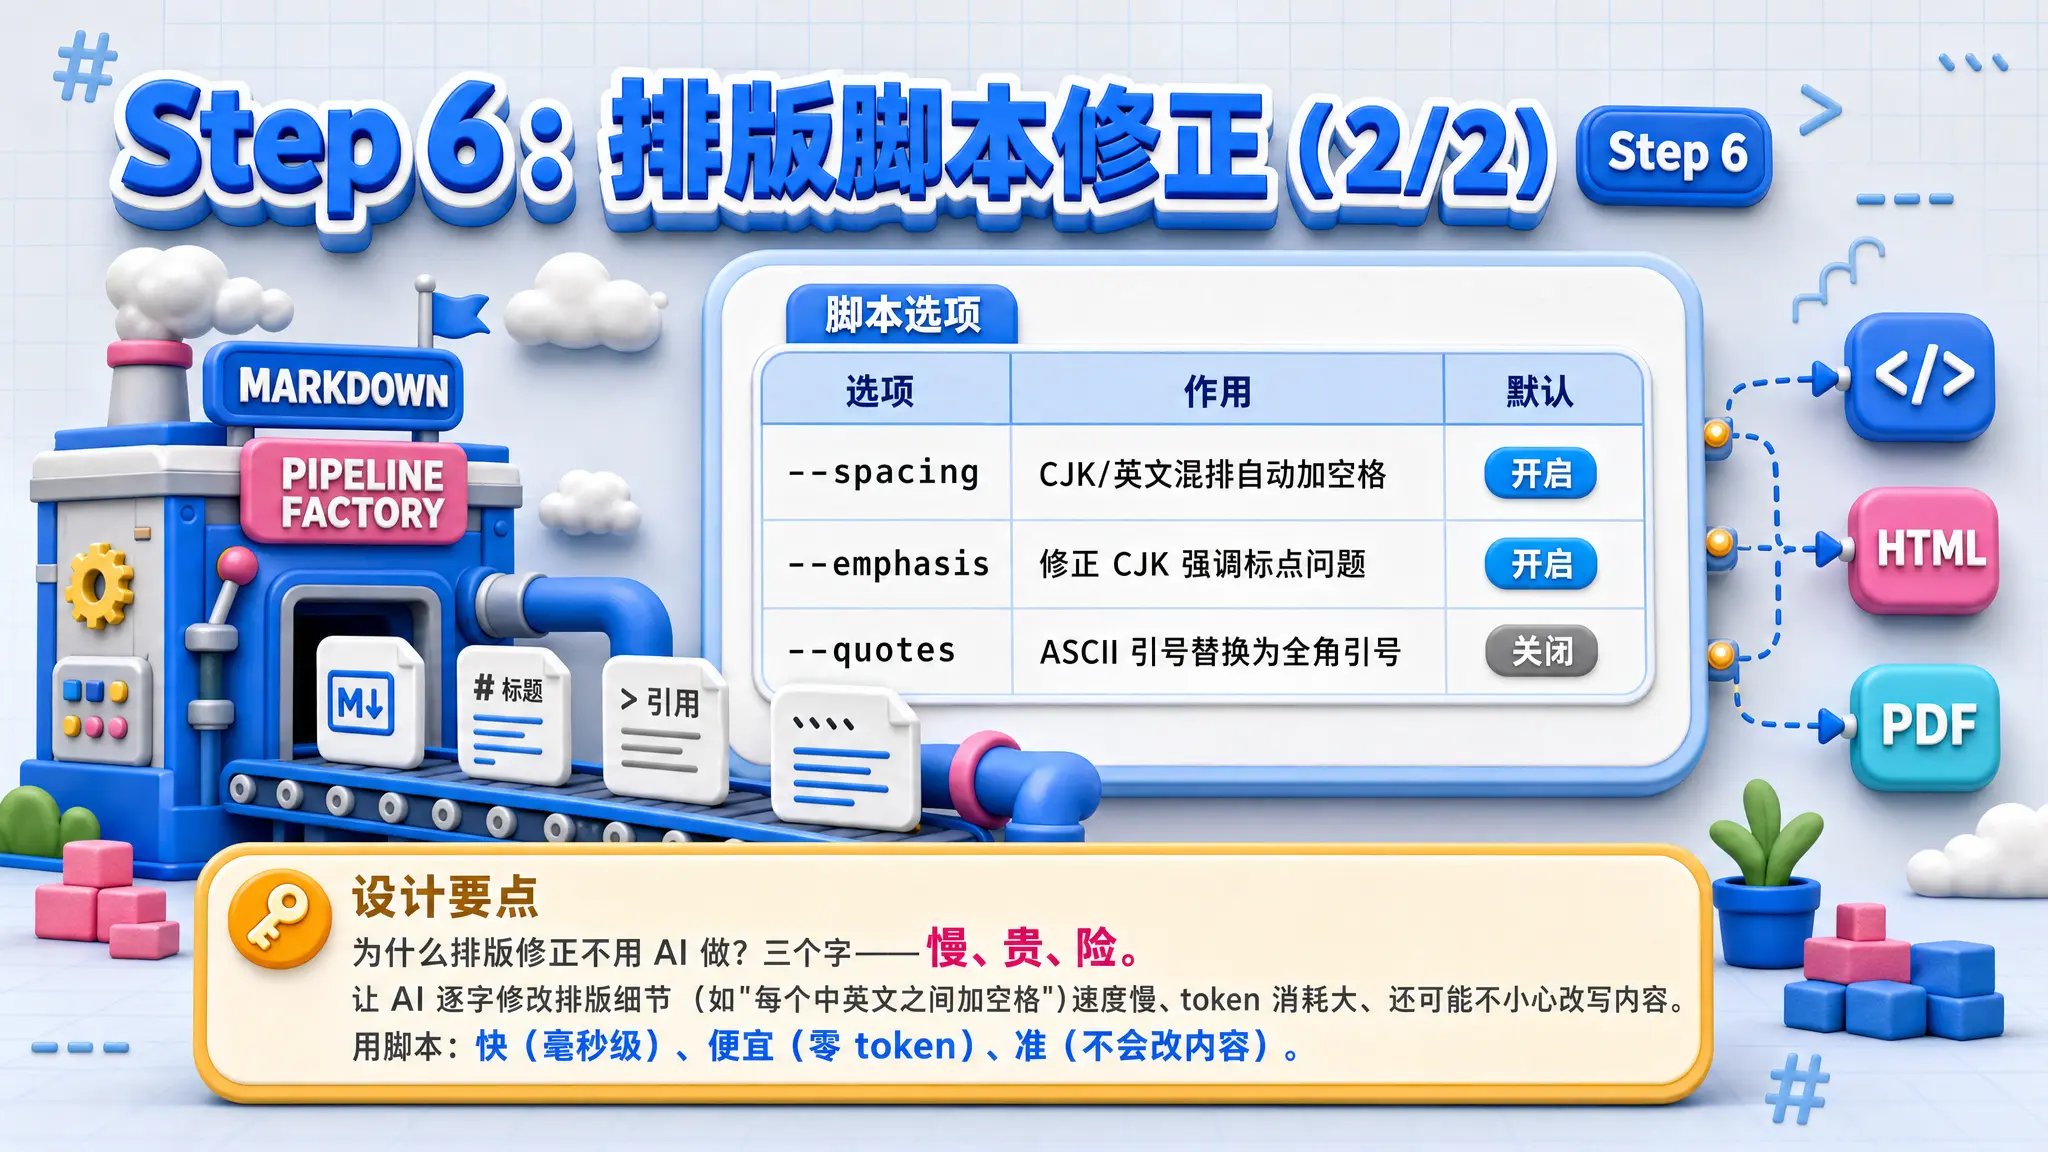
脚本选项:
| 选项 | 作用 | 默认 |
|---|---|---|
--spacing | CJK/英文混排自动加空格 | 开启 |
--emphasis | 修正 CJK 强调标点问题 | 开启 |
--quotes | ASCII 引号替换为全角引号 | 关闭 |
🔑 设计要点:为什么排版修正不用 AI 做?三个字——慢、贵、险。让 AI 逐字修改排版细节(如"每个中英文之间加空格")速度慢、token 消耗大、还可能不小心改写内容。用脚本:快(毫秒级)、便宜(零 token)、准(不会改内容)。
Step 7:输出完成报告
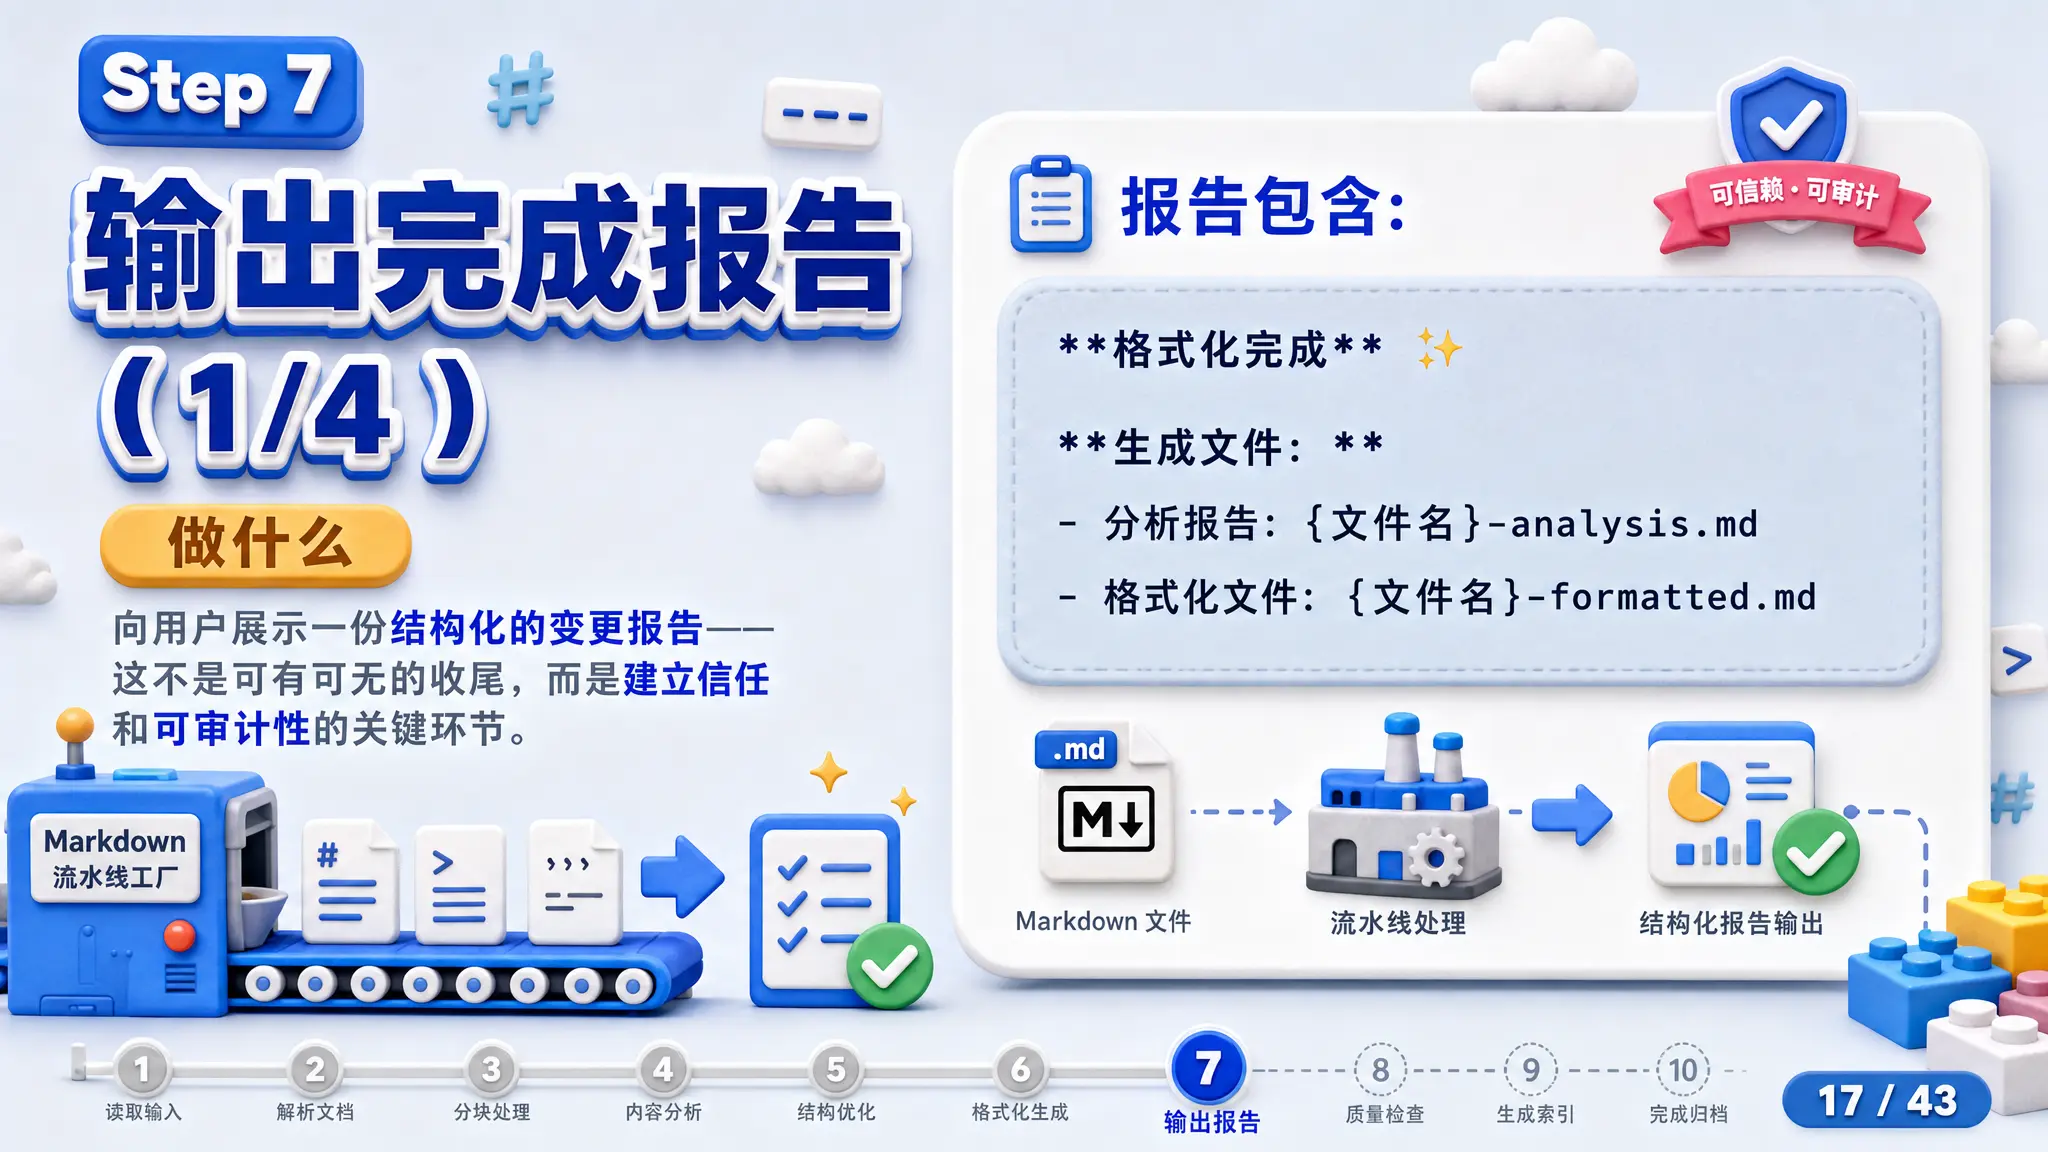
做什么:向用户展示一份结构化的变更报告——这不是可有可无的收尾,而是建立信任和可审计性的关键环节。
报告包含:
**格式化完成** ✨

**生成文件:**
- 分析报告:{文件名}-analysis.md
- 格式化文件:{文件名}-formatted.md

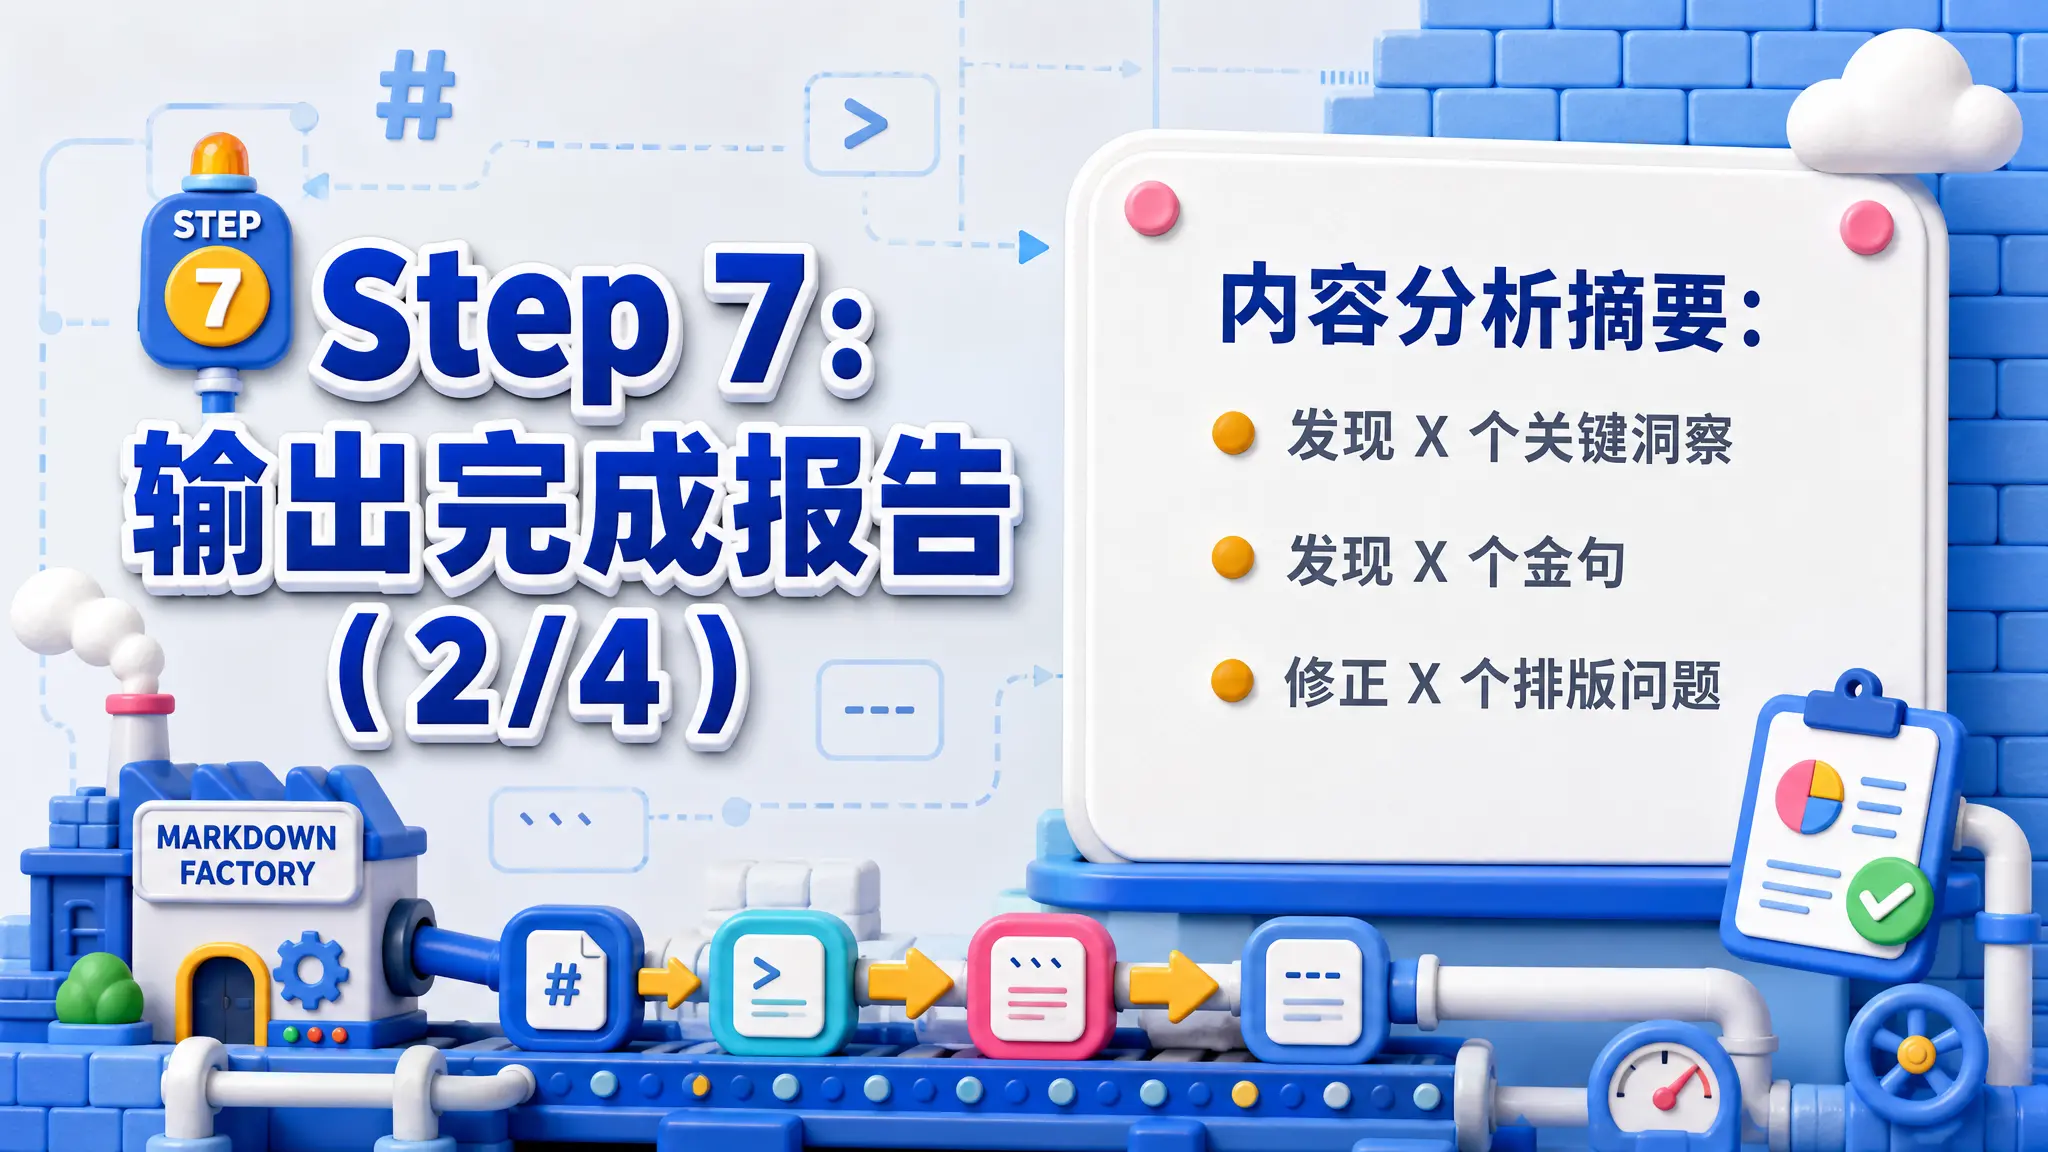
**内容分析摘要:**
- 发现 X 个关键洞察
- 发现 X 个金句
- 修正 X 个排版问题

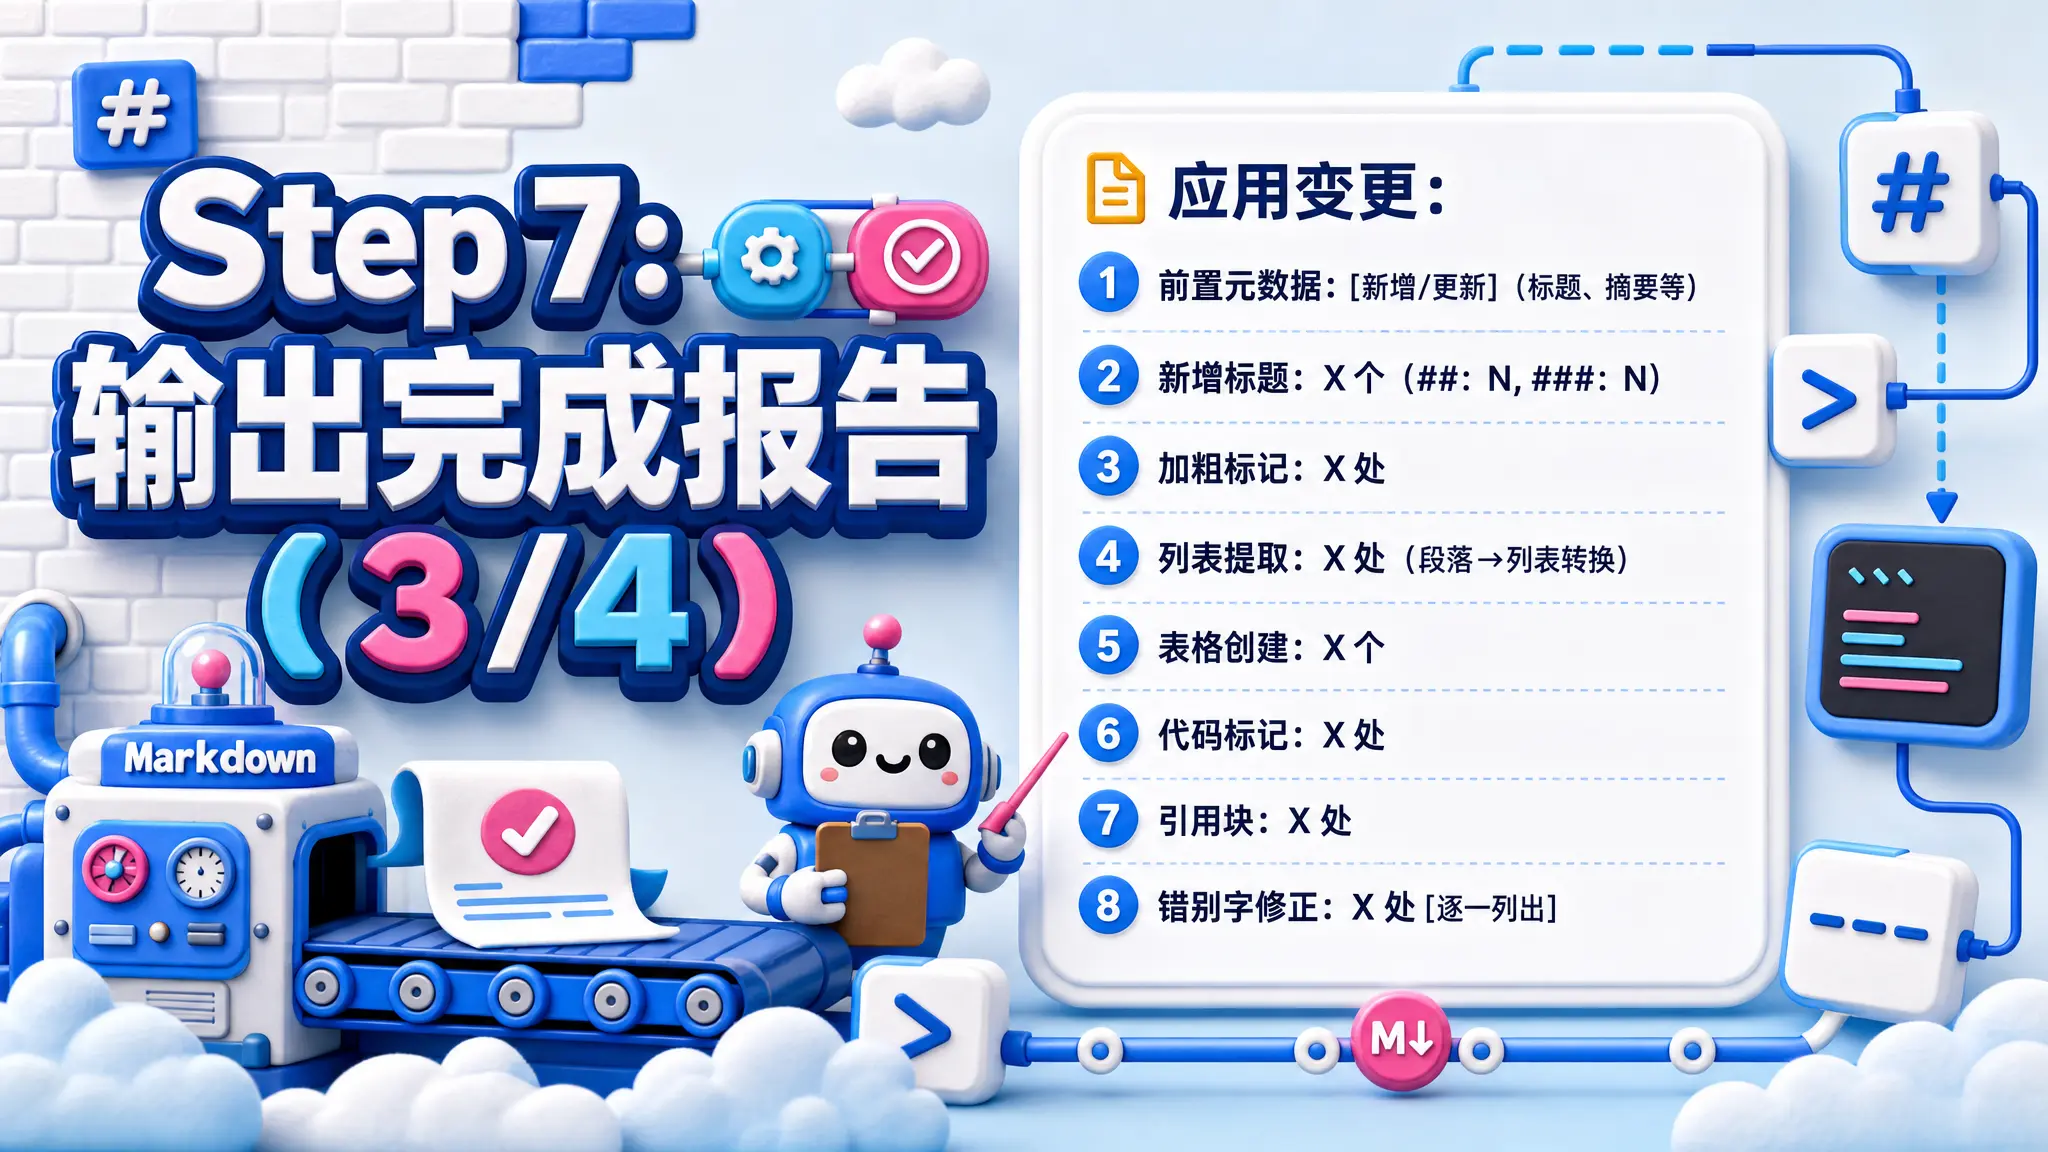
**应用变更:**
- 前置元数据:[新增/更新](标题、摘要等)
- 新增标题:X 个(##:N, ###:N)
- 加粗标记:X 处
- 列表提取:X 处(段落→列表转换)
- 表格创建:X 个
- 代码标记:X 处
- 引用块:X 处
- 错别字修正:X 处 [逐一列出]

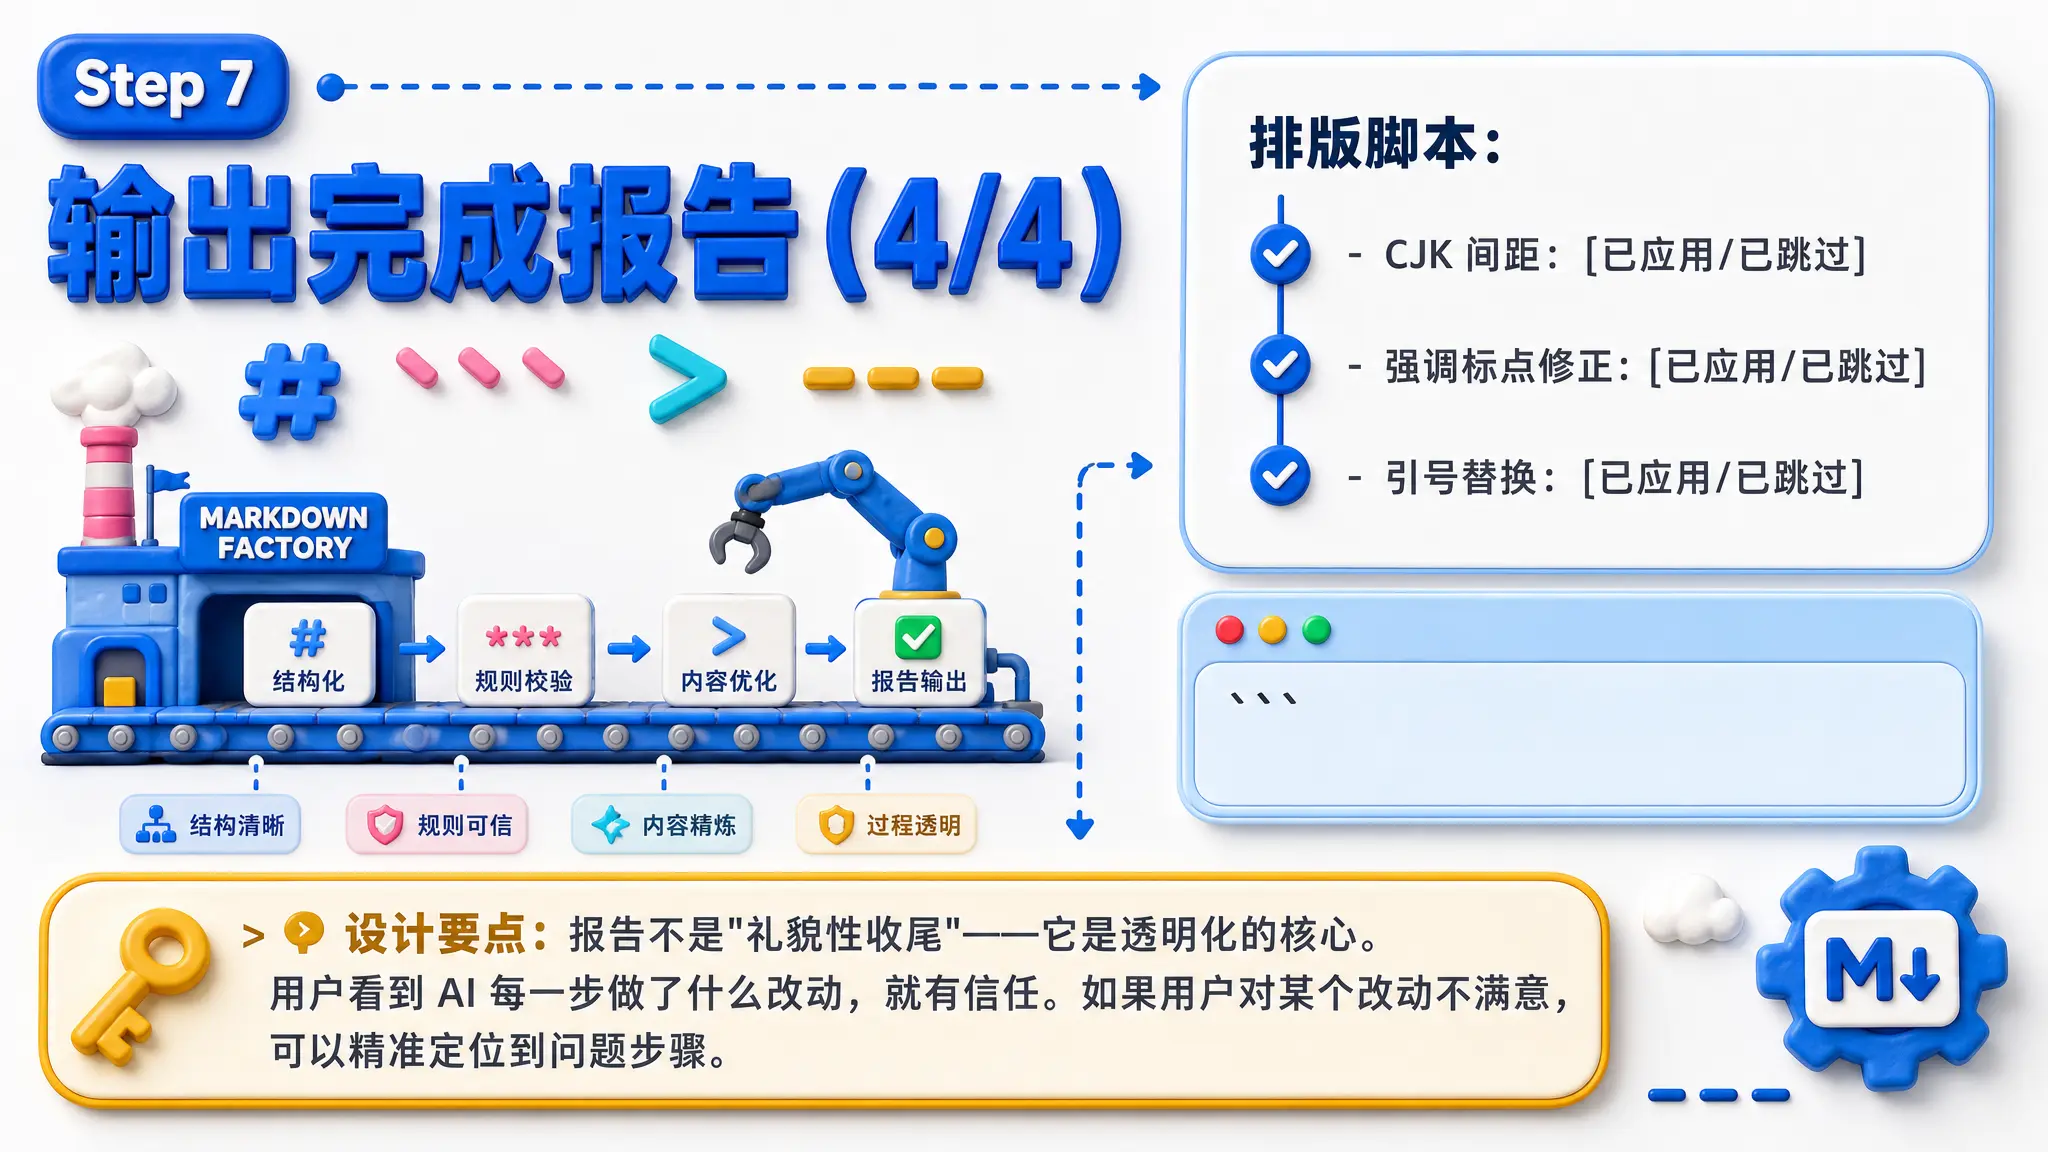
**排版脚本:**
- CJK 间距:[已应用/已跳过]
- 强调标点修正:[已应用/已跳过]
- 引号替换:[已应用/已跳过]
🔑 设计要点:报告不是"礼貌性收尾"——它是透明化的核心。用户看到 AI 每一步做了什么改动,就有信任。如果用户对某个改动不满意,可以精准定位到问题步骤。
七步流水线总览图
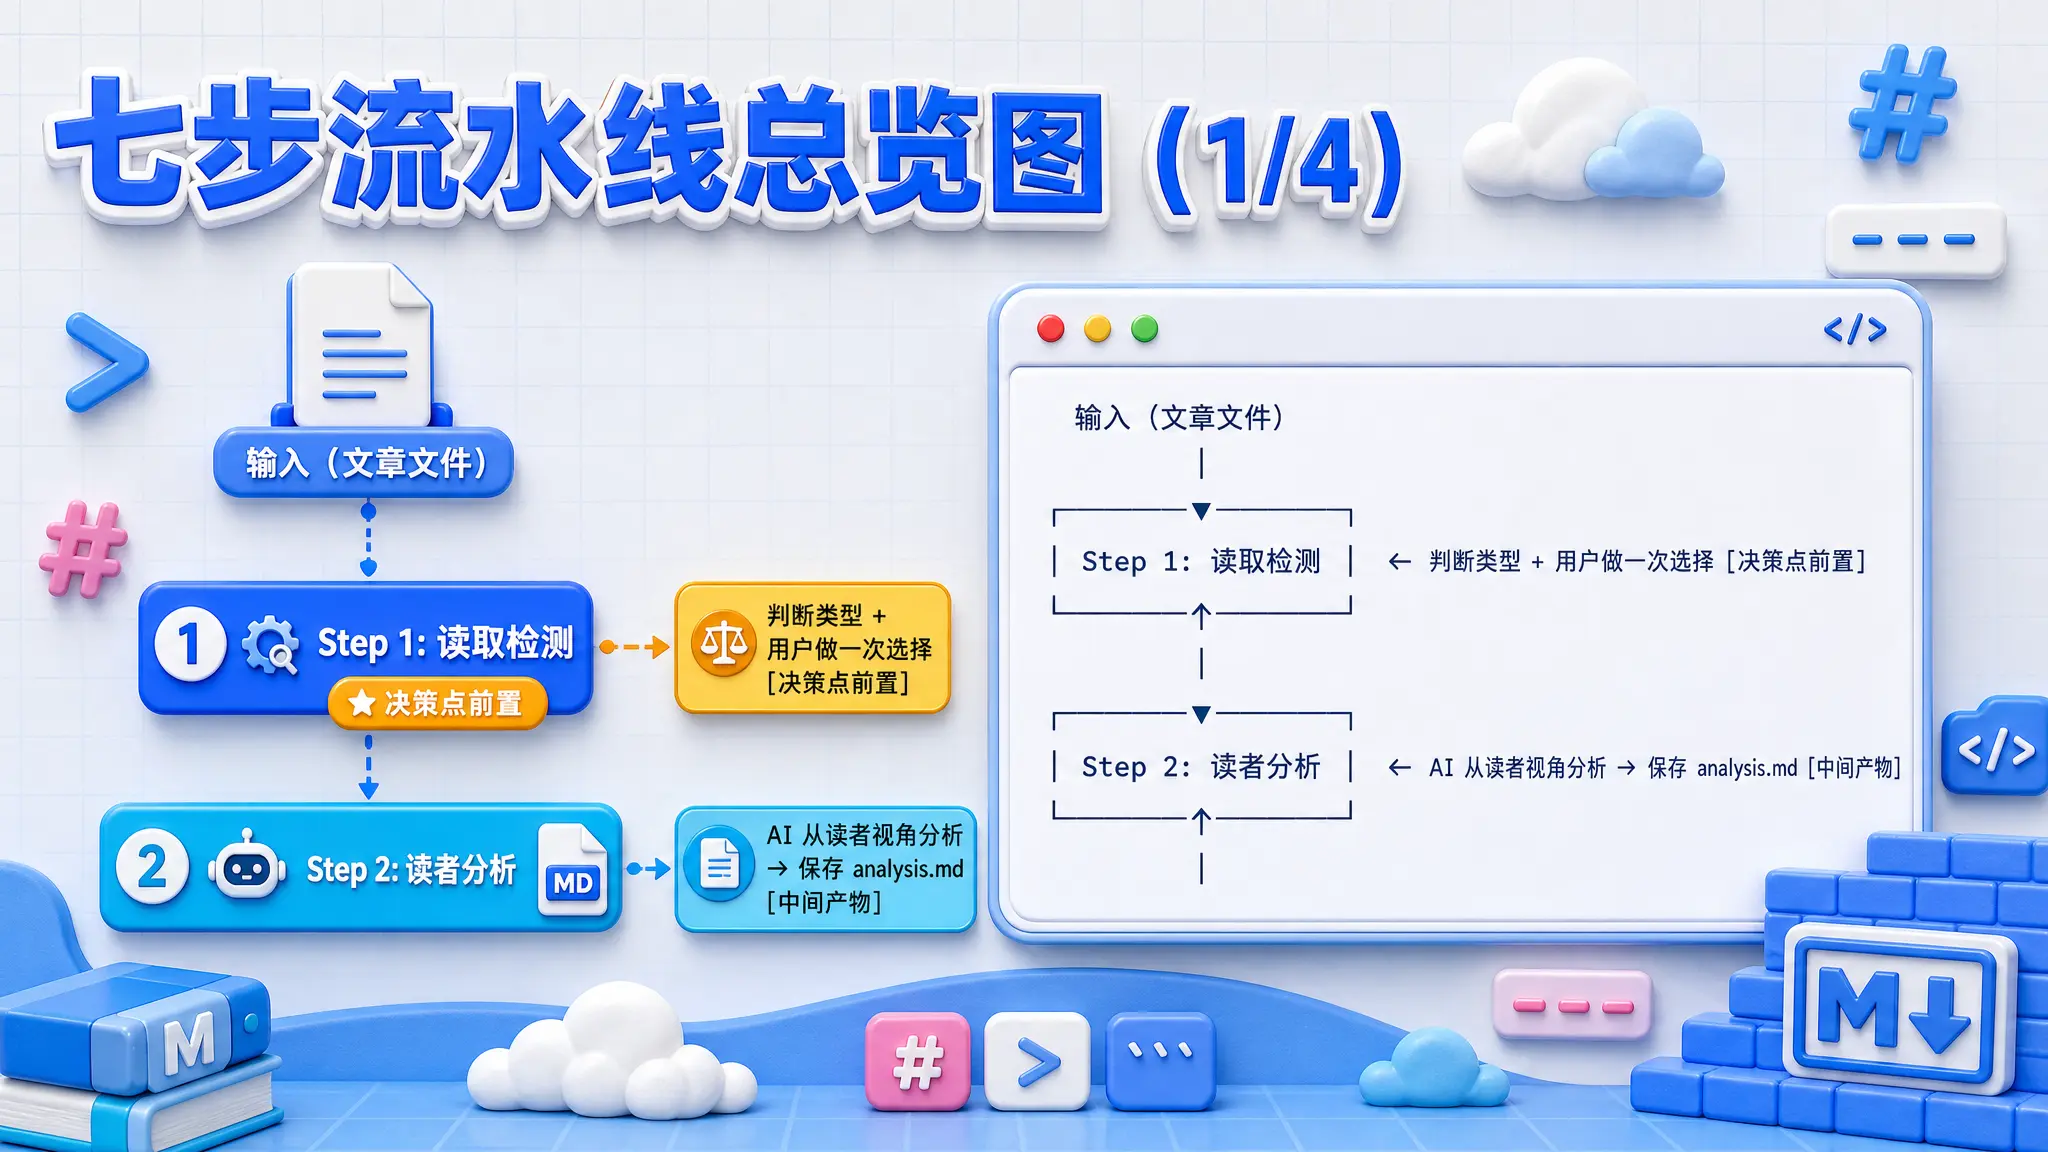
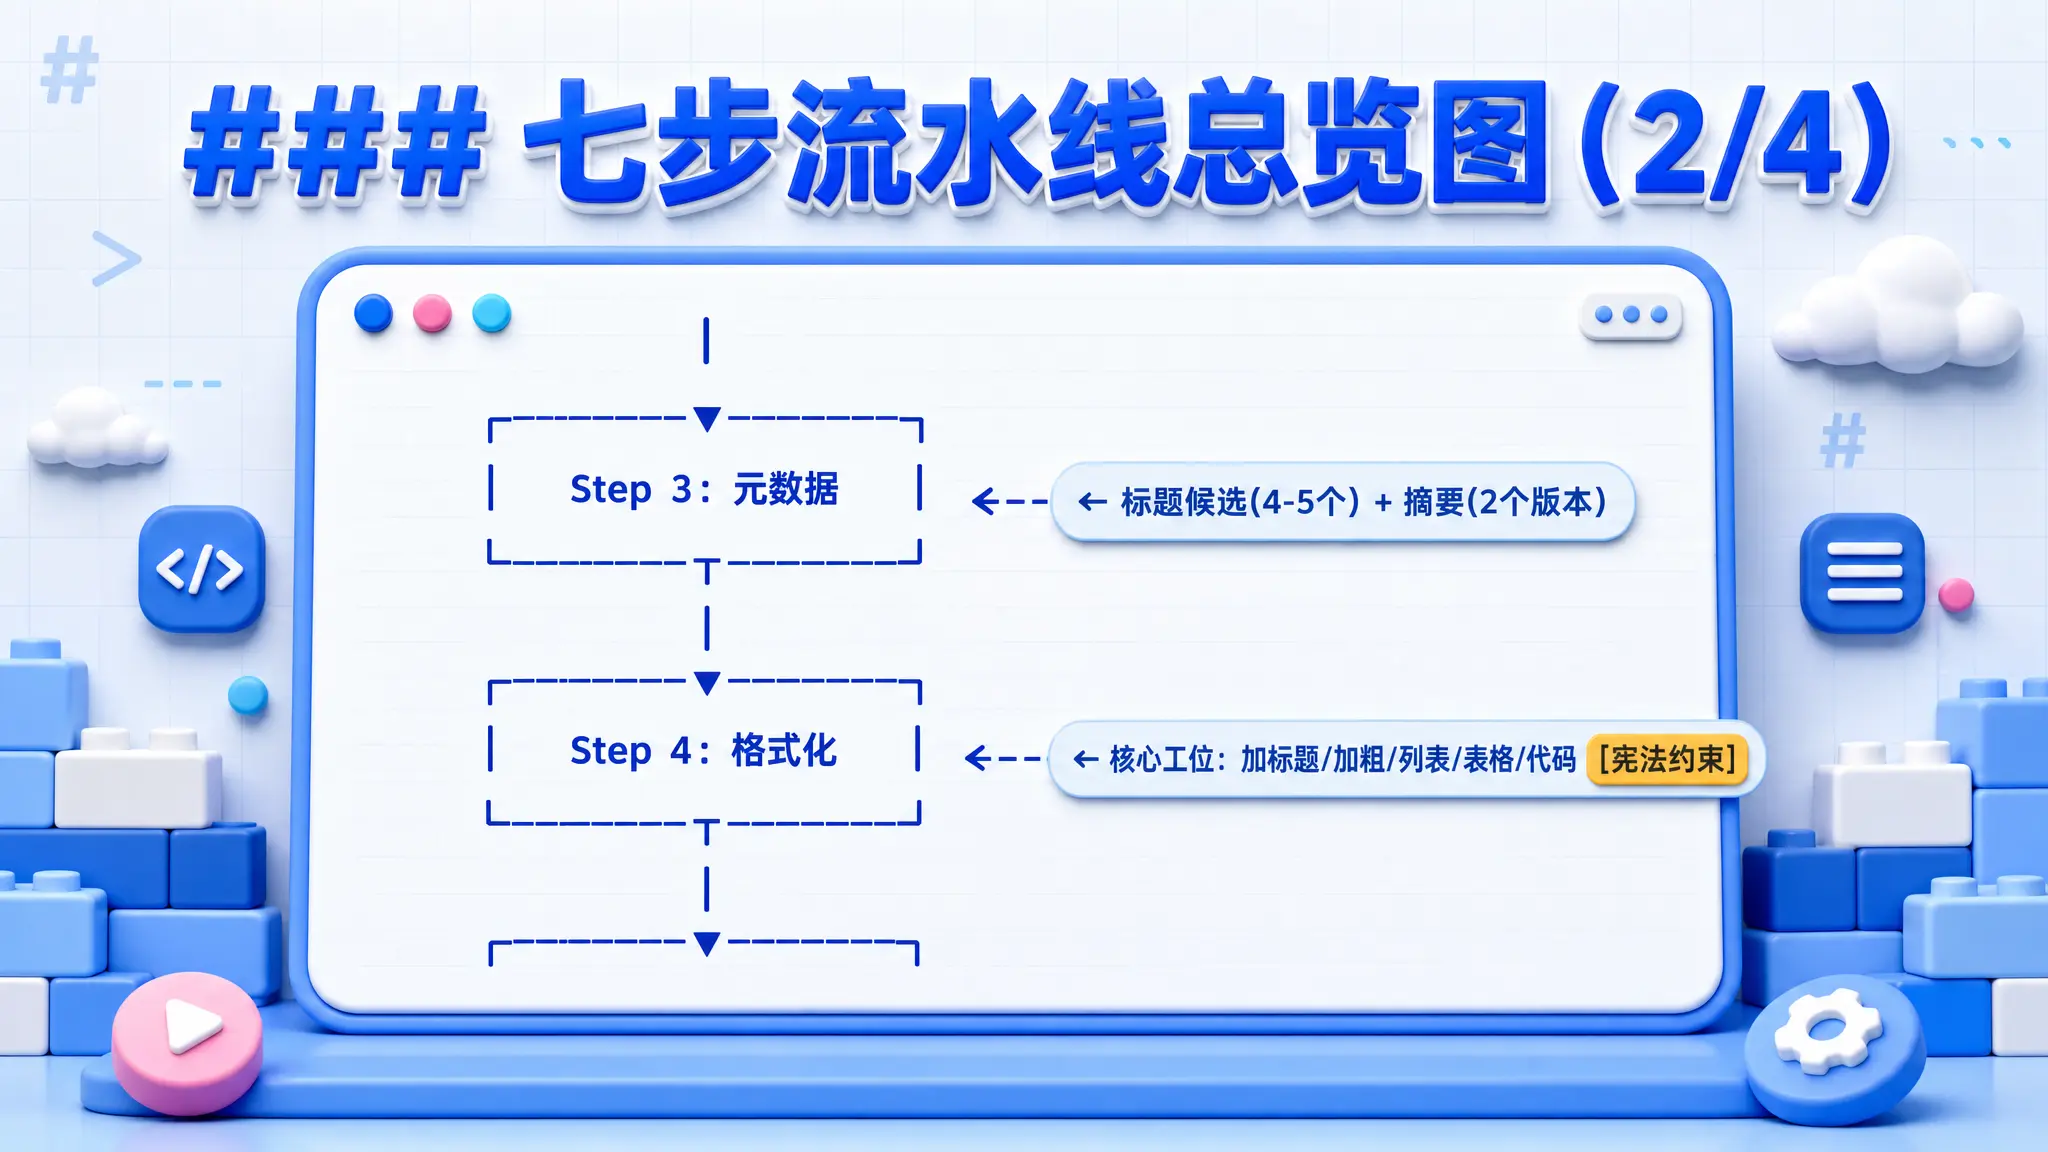
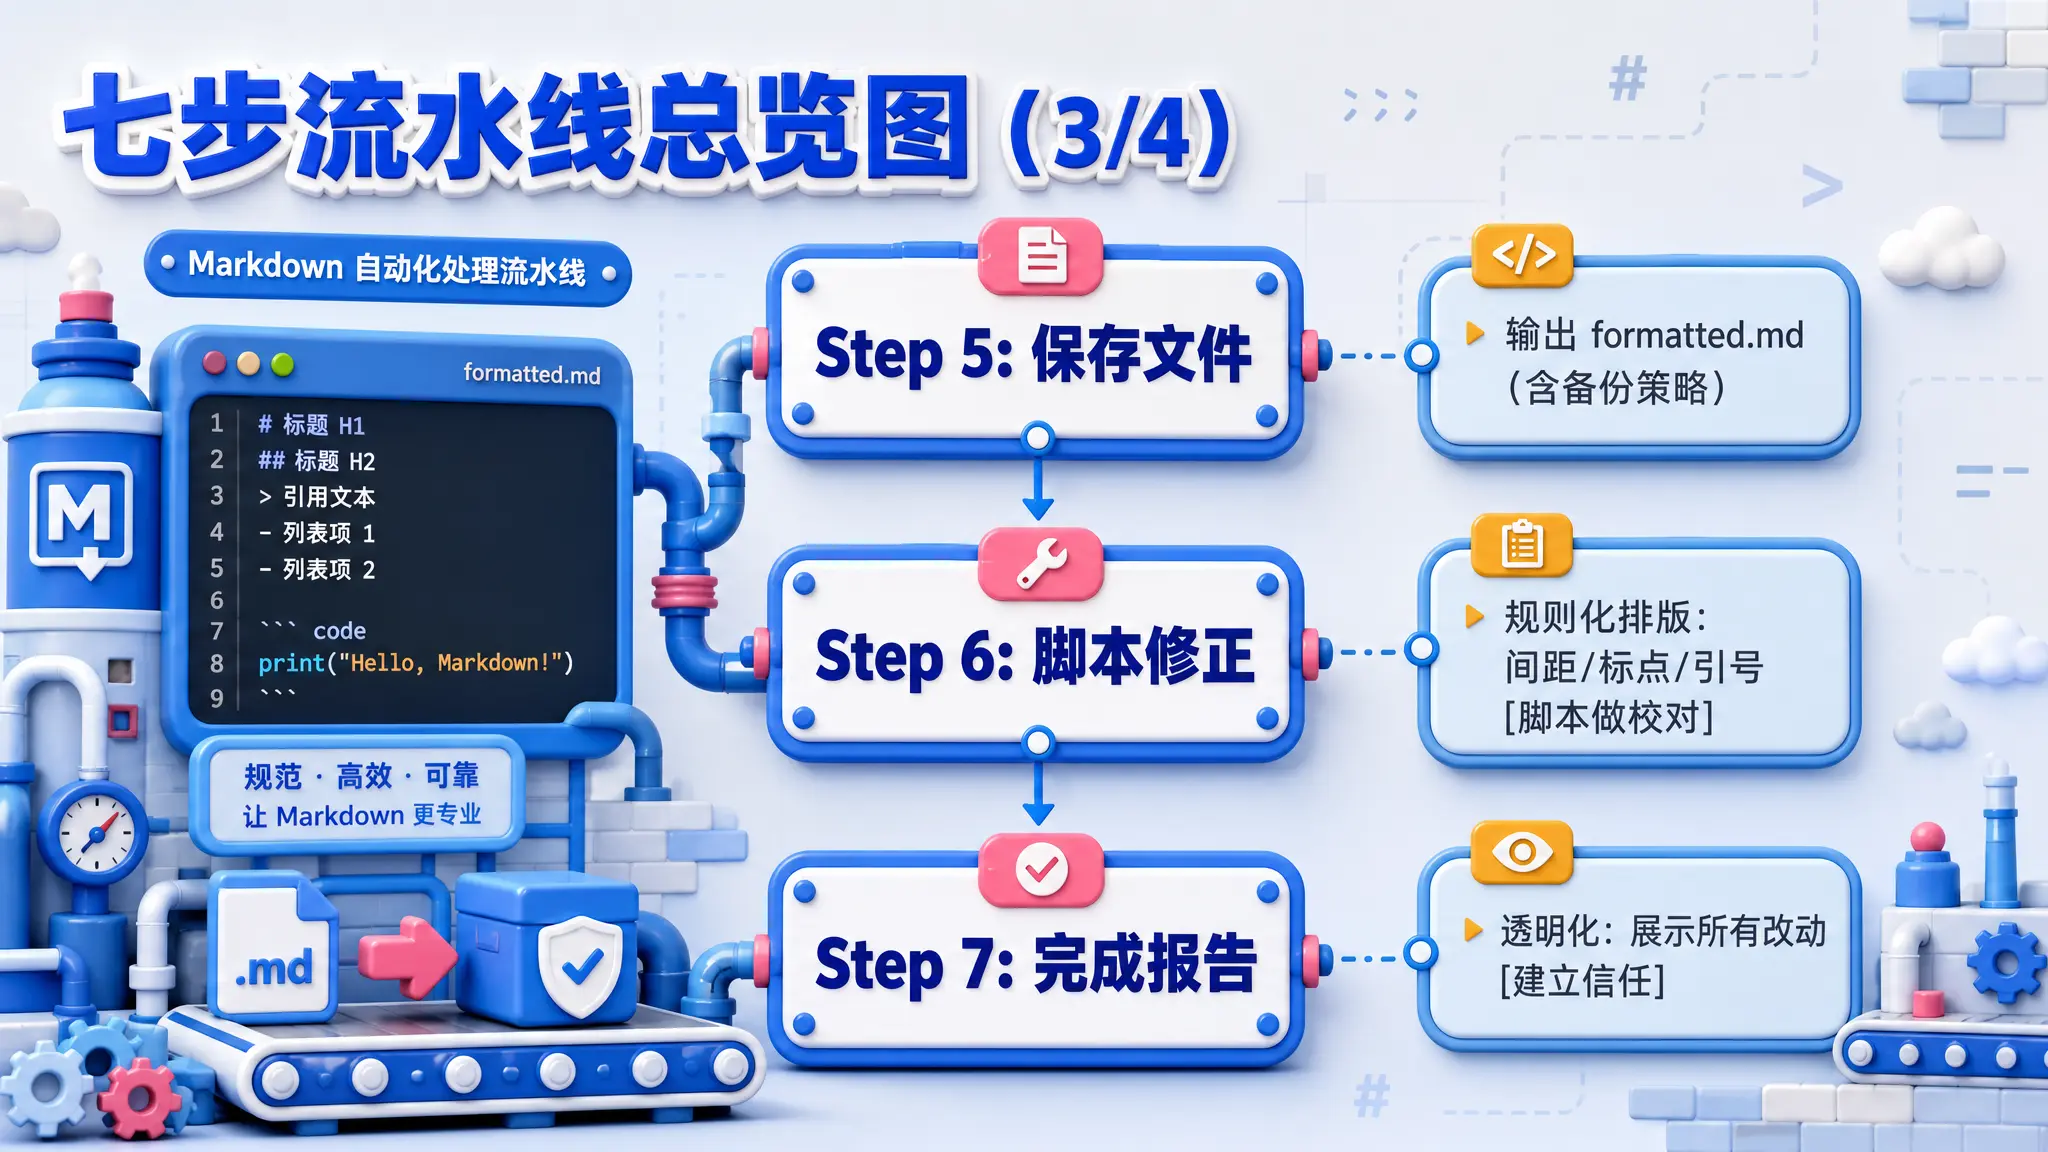
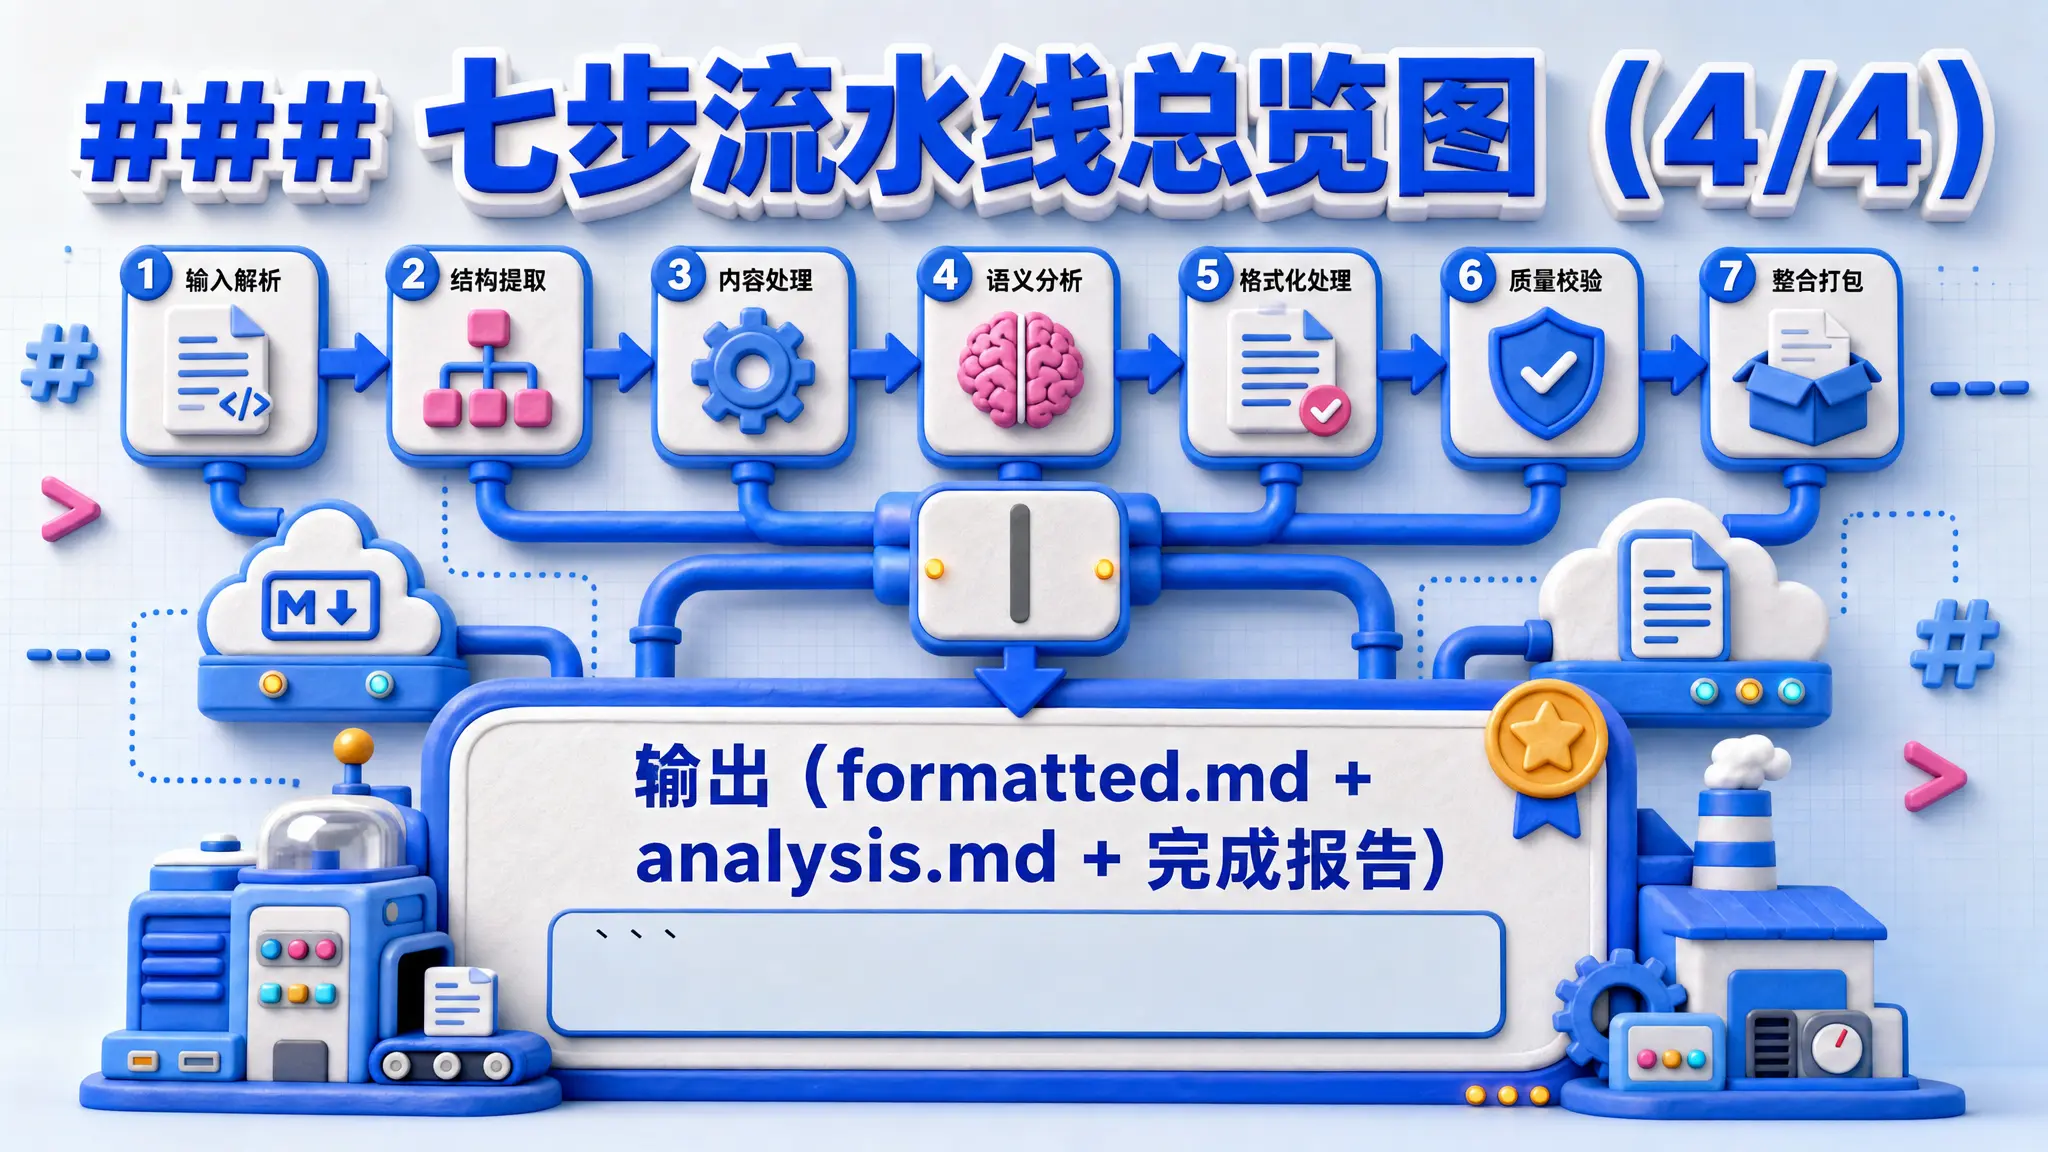
                输入(文章文件)
                     │
            ┌────────▼────────┐
            │ Step 1: 读取检测 │  ← 判断类型 + 用户做一次选择 [决策点前置]
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 2: 读者分析 │  ← AI 从读者视角分析 → 保存 analysis.md [中间产物]
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 3: 元数据   │  ← 标题候选(4-5个) + 摘要(2个版本)
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 4: 格式化   │  ← 核心工位:加标题/加粗/列表/表格/代码 [宪法约束]
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 5: 保存文件 │  ← 输出 formatted.md(含备份策略)
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 6: 脚本修正 │  ← 规则化排版:间距/标点/引号 [脚本做校对]
            └────────┬────────┘
                     │
            ┌────────▼────────┐
            │ Step 7: 完成报告 │  ← 透明化:展示所有改动 [建立信任]
            └────────┬────────┘
                     │
                输出(formatted.md + analysis.md + 完成报告)
本课学到的 4 大流水线设计原则
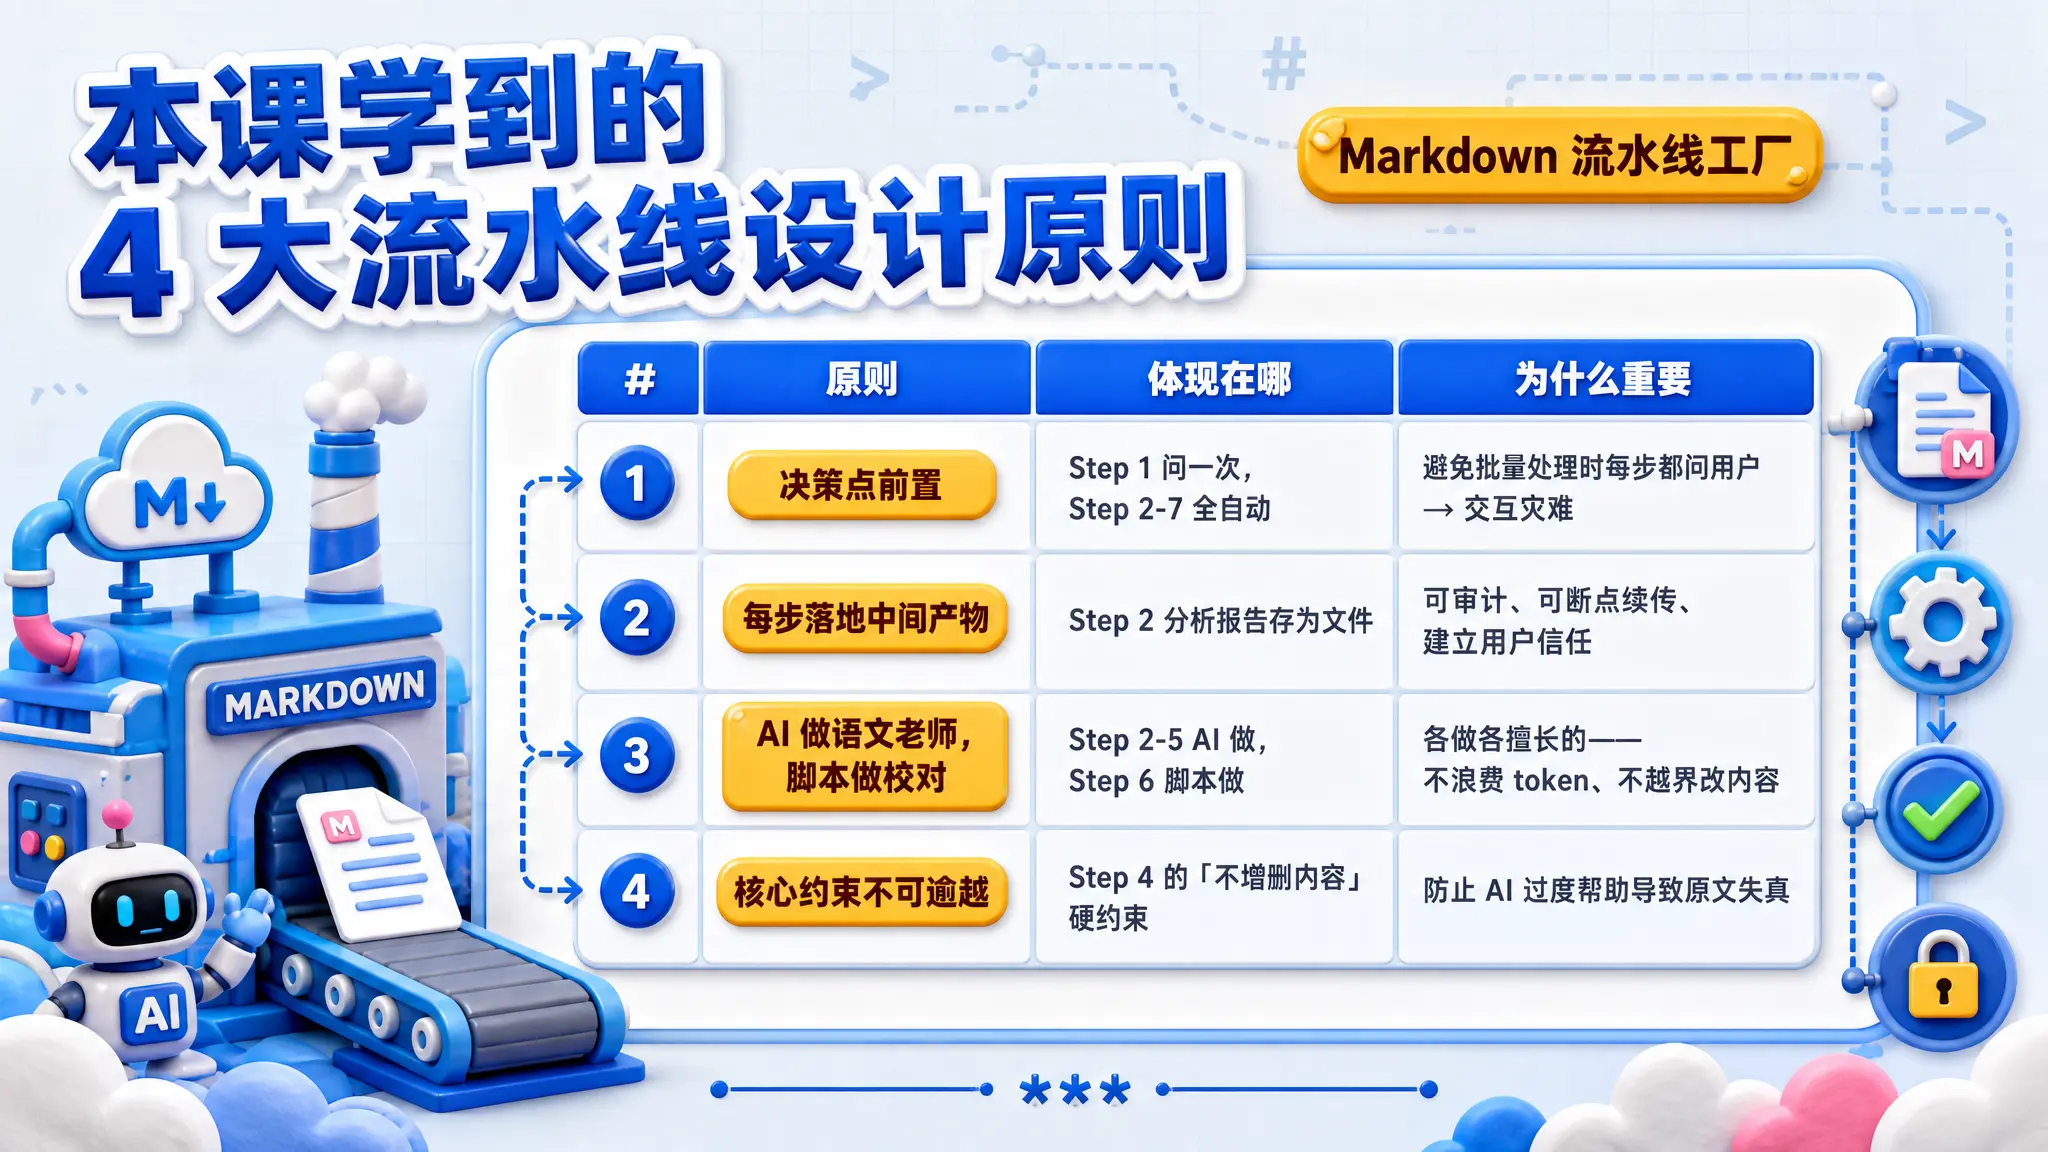
| # | 原则 | 体现在哪 | 为什么重要 |
|---|---|---|---|
| 1 | 决策点前置 | Step 1 问一次,Step 2-7 全自动 | 避免批量处理时每步都问用户 → 交互灾难 |
| 2 | 每步落地中间产物 | Step 2 分析报告存为文件 | 可审计、可断点续传、建立用户信任 |
| 3 | AI 做语文老师,脚本做校对 | Step 2-5 AI 做,Step 6 脚本做 | 各做各擅长的——不浪费 token、不越界改内容 |
| 4 | 核心约束不可逾越 | Step 4 的「不增删内容」硬约束 | 防止 AI 过度帮助导致原文失真 |
3. 结构拆解:多阶段流水线模板
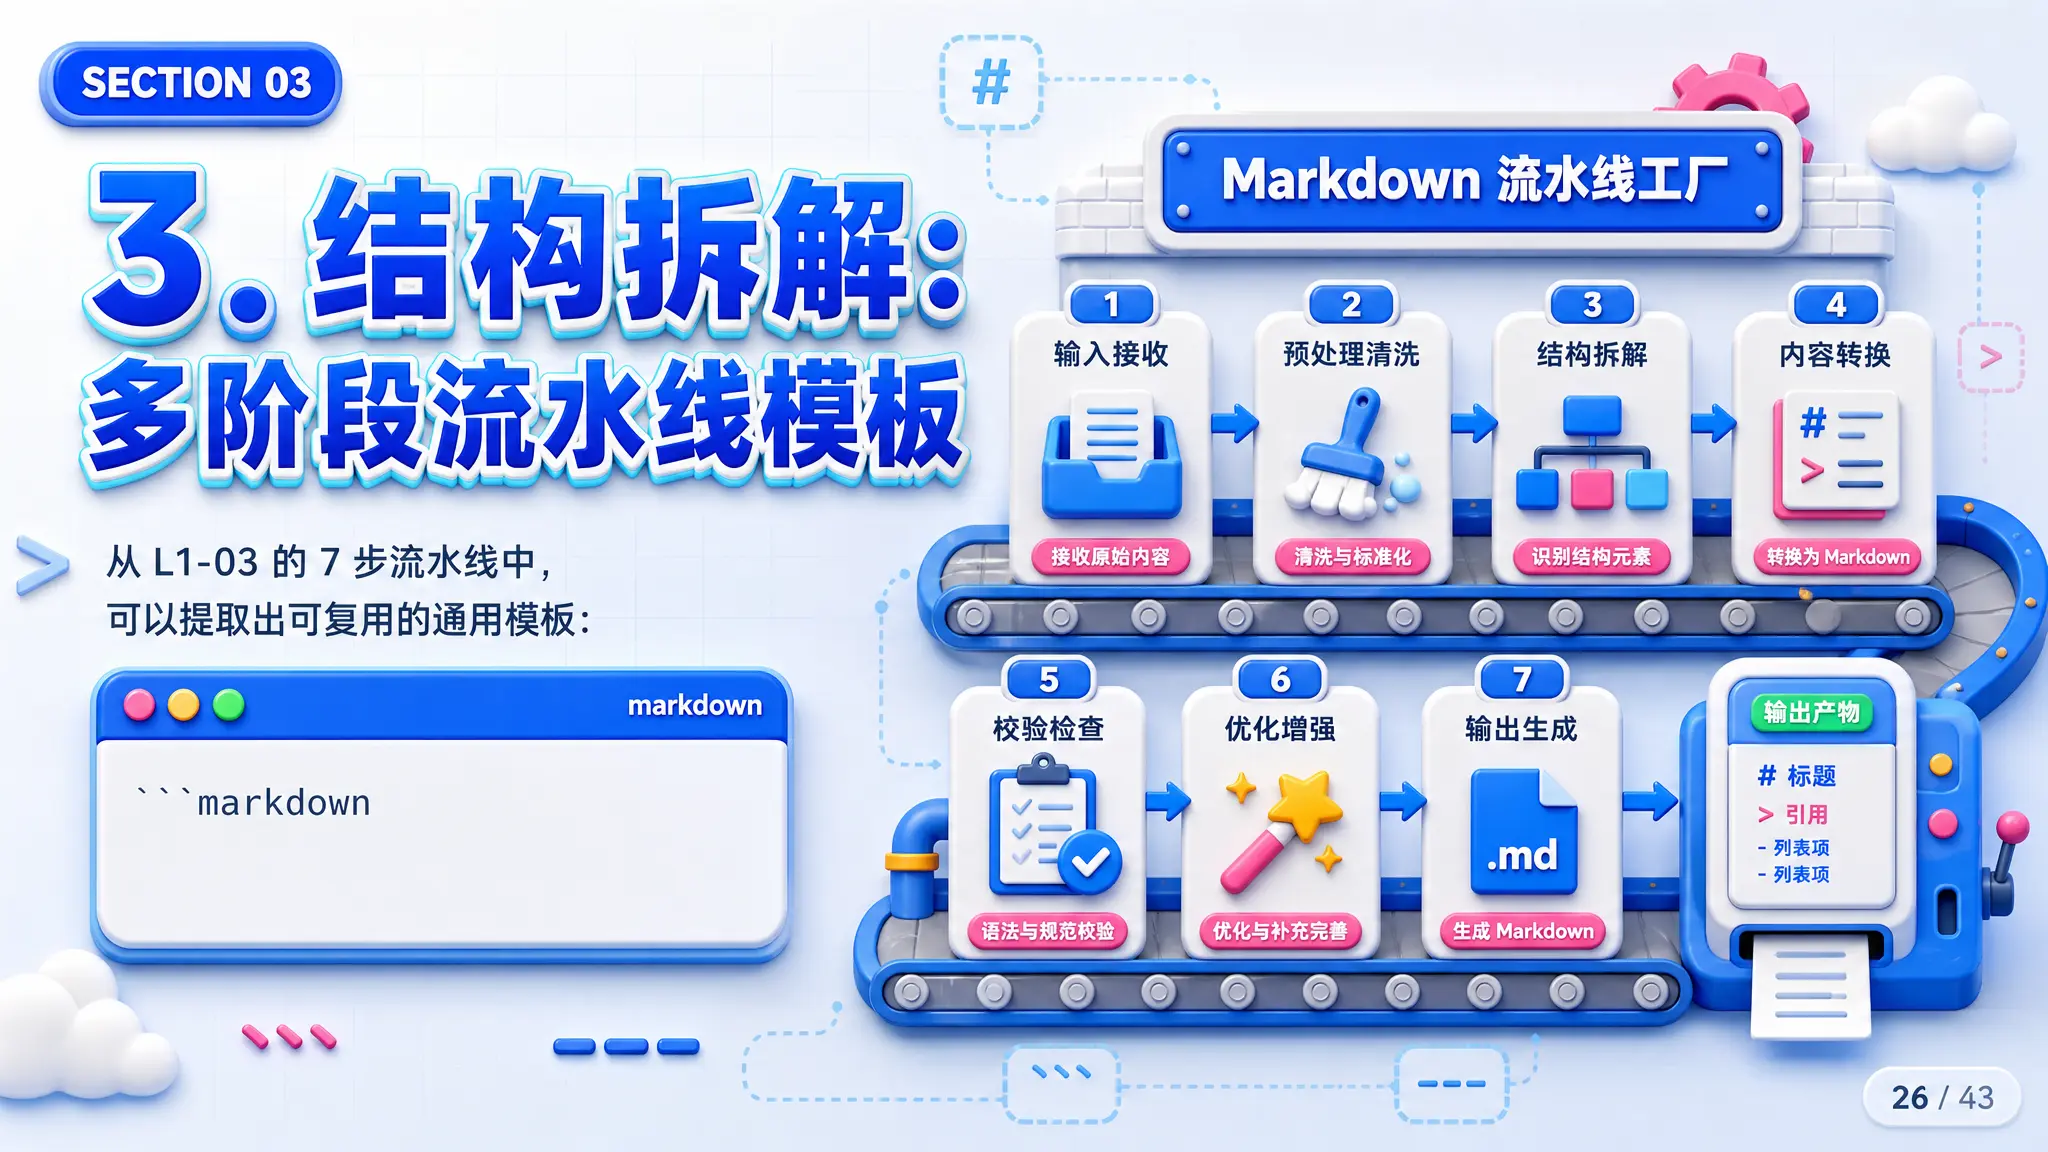
从 L1-03 的 7 步流水线中,可以提取出可复用的通用模板:
Workflow(流水线)
Step 1: 检测 + 决策(Detect & Decide)
[判断输入类型 → 给用户有限选项 → 获取一次决策]
Step 2: 分析(Analyze)
[深入分析输入内容 → 保存分析报告为中间文件]
Step 3: 元数据(Metadata)
[生成/优化标题、摘要、标签等元数据]
Step 4: 处理(Process)
[核心处理逻辑 ← 流水线的「主工位」]
Step 5: 保存(Save)
[输出处理结果,含备份策略]
Step 6: 后处理(Post-process)
[脚本化的规则修正 ← 不浪费 AI token]
Step 7: 报告(Report)
[结构化展示所有变更 ← 建立用户信任]
流水线型 Skill vs 工具型 Skill 的本质区别:
| 特征 | 工具型 Skill(L1-01) | 流水线型 Skill(L1-03) |
|---|---|---|
| 步骤数 | 1 步(调脚本→输出) | 7 步(工位流) |
| AI 的角色 | 传话筒(调脚本) | 核心工人(分析+格式化) |
| 中间产物 | 无 | 分析报告(独立文件) |
| 决策次数 | 0(参数即决策) | 1 次(决策点前置) |
| 适合场景 | 确定性的技术操作 | 需要判断力的写作/编辑/审查 |
什么时候用流水线型模板? → 当任务不能一步完成,需要"先理解再动手"的时候:
- 格式化文章(先分析后排版)
- 代码审查(先理解架构后找 bug)
- 内容策略(先诊断后开方)
- 任何需要"诊断→处理→报告"三阶段的场景
这个模板的变通:不是所有流水线都需要恰好 7 步。核心是保持三个不变:
- 决策点前置(第一或第二步问一次)
- 中间产物落地(分析结果存文件)
- AI+脚本分工(语义理解归 AI,规则操作归脚本)
4. 电商案例:拼多多50个SKU商品描述批量标准化
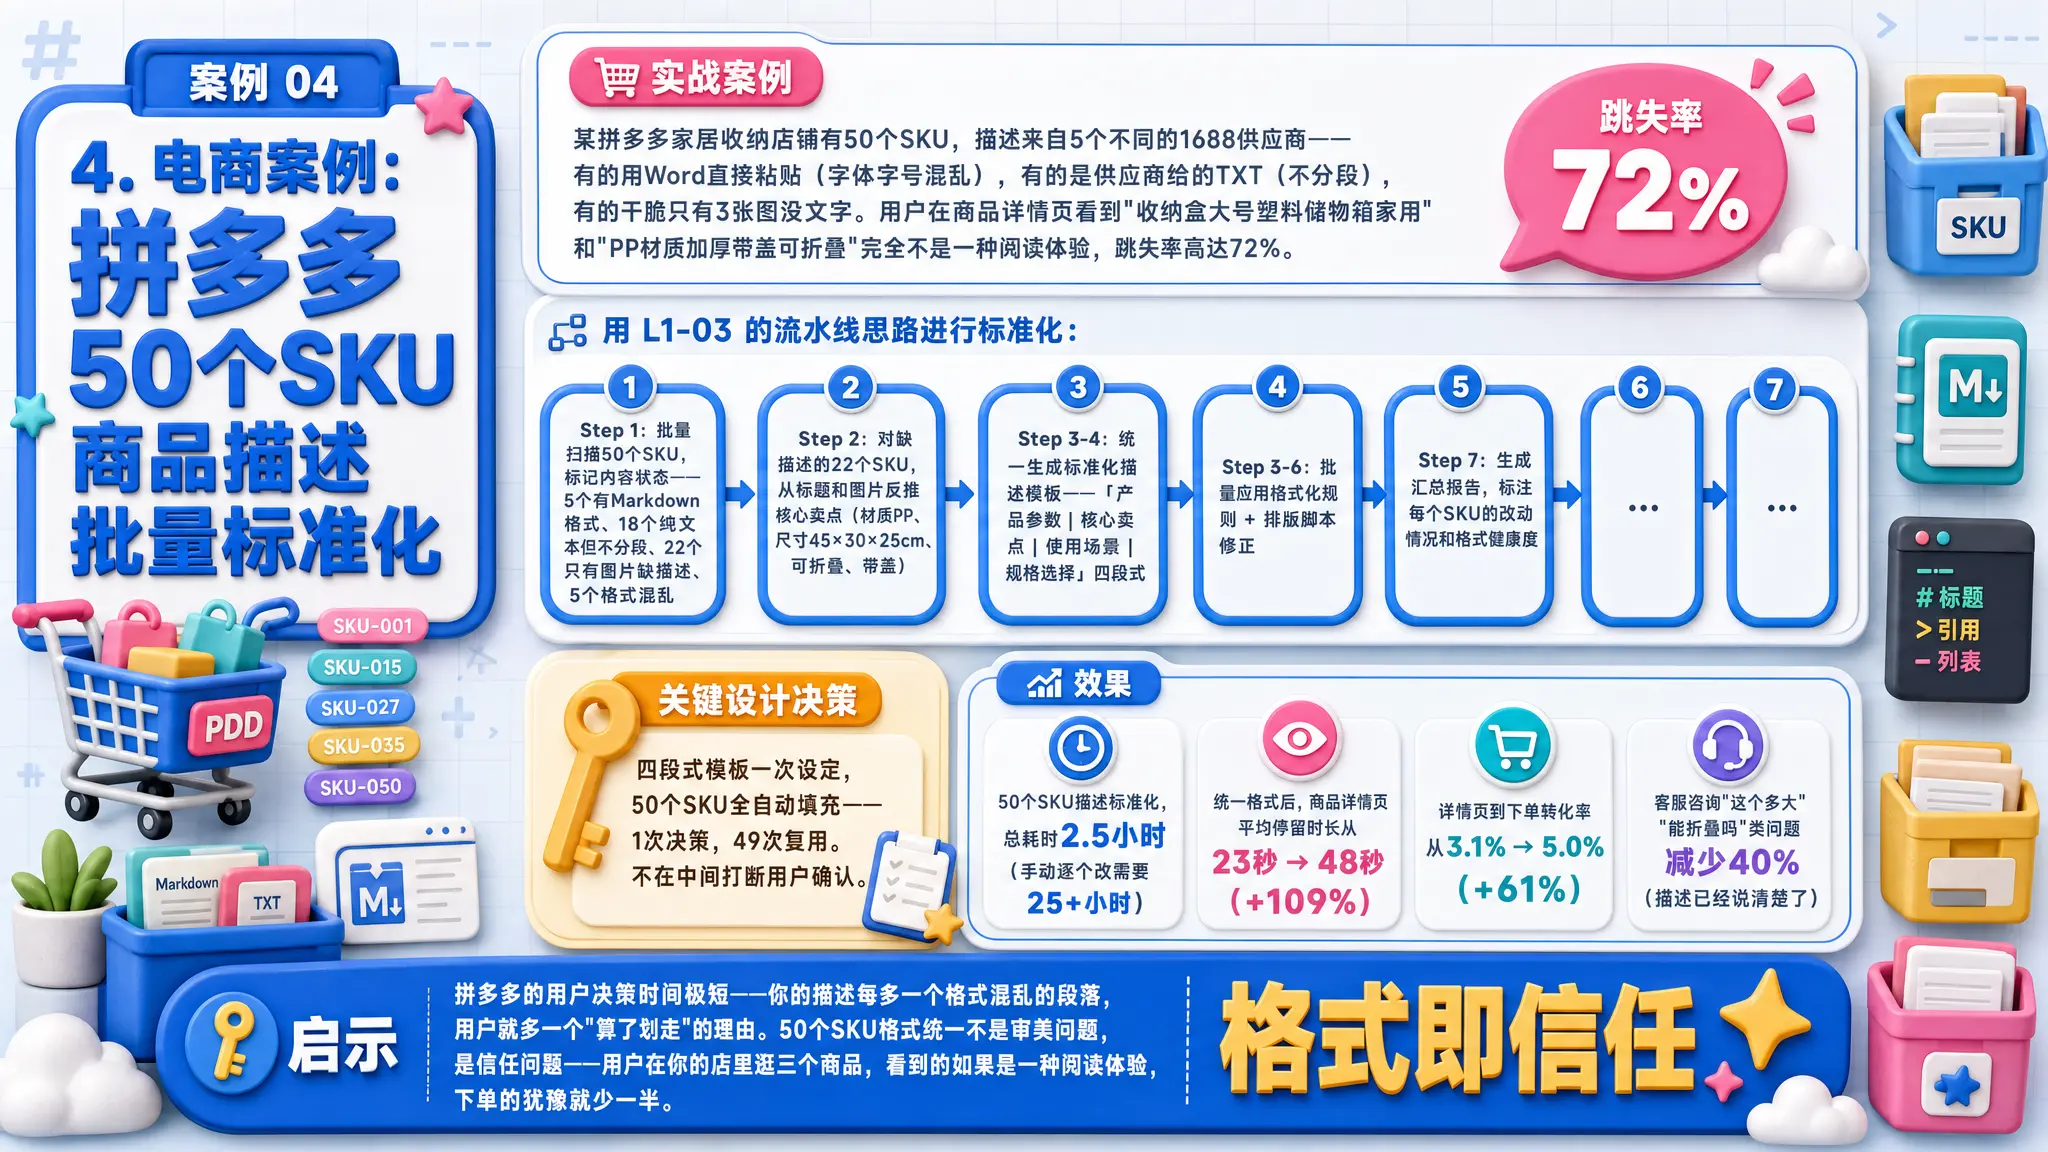
🛒 实战案例:某拼多多家居收纳店铺有50个SKU,描述来自5个不同的1688供应商——有的用Word直接粘贴(字体字号混乱),有的是供应商给的TXT(不分段),有的干脆只有3张图没文字。用户在商品详情页看到"收纳盒大号塑料储物箱家用"和"PP材质加厚带盖可折叠"完全不是一种阅读体验,跳失率高达72%。
用 L1-03 的流水线思路进行标准化:
- Step 1:批量扫描50个SKU,标记内容状态——5个有Markdown格式、18个纯文本但不分段、22个只有图片缺描述、5个格式混乱
- Step 2:对缺描述的22个SKU,从标题和图片反推核心卖点(材质PP、尺寸45×30×25cm、可折叠、带盖)
- Step 3-4:统一生成标准化描述模板——「产品参数 | 核心卖点 | 使用场景 | 规格选择」四段式
- Step 5-6:批量应用格式化规则 + 排版脚本修正
- Step 7:生成汇总报告,标注每个SKU的改动情况和格式健康度
关键设计决策:四段式模板一次设定,50个SKU全自动填充——1次决策,49次复用。不在中间打断用户确认。
效果:
- 50个SKU描述标准化,总耗时2.5小时(手动逐个改需要25+小时)
- 统一格式后,商品详情页平均停留时长从23秒 → 48秒(+109%)
- 详情页到下单转化率从3.1% → 5.0%(+61%)
- 客服咨询"这个多大""能折叠吗"类问题减少40%(描述已经说清楚了)
🔑 启示:拼多多的用户决策时间极短——你的描述每多一个格式混乱的段落,用户就多一个"算了划走"的理由。50个SKU格式统一不是审美问题,是信任问题——用户在你的店里逛三个商品,看到的如果是一种阅读体验,下单的犹豫就少一半。格式即信任。
5. 变体练习
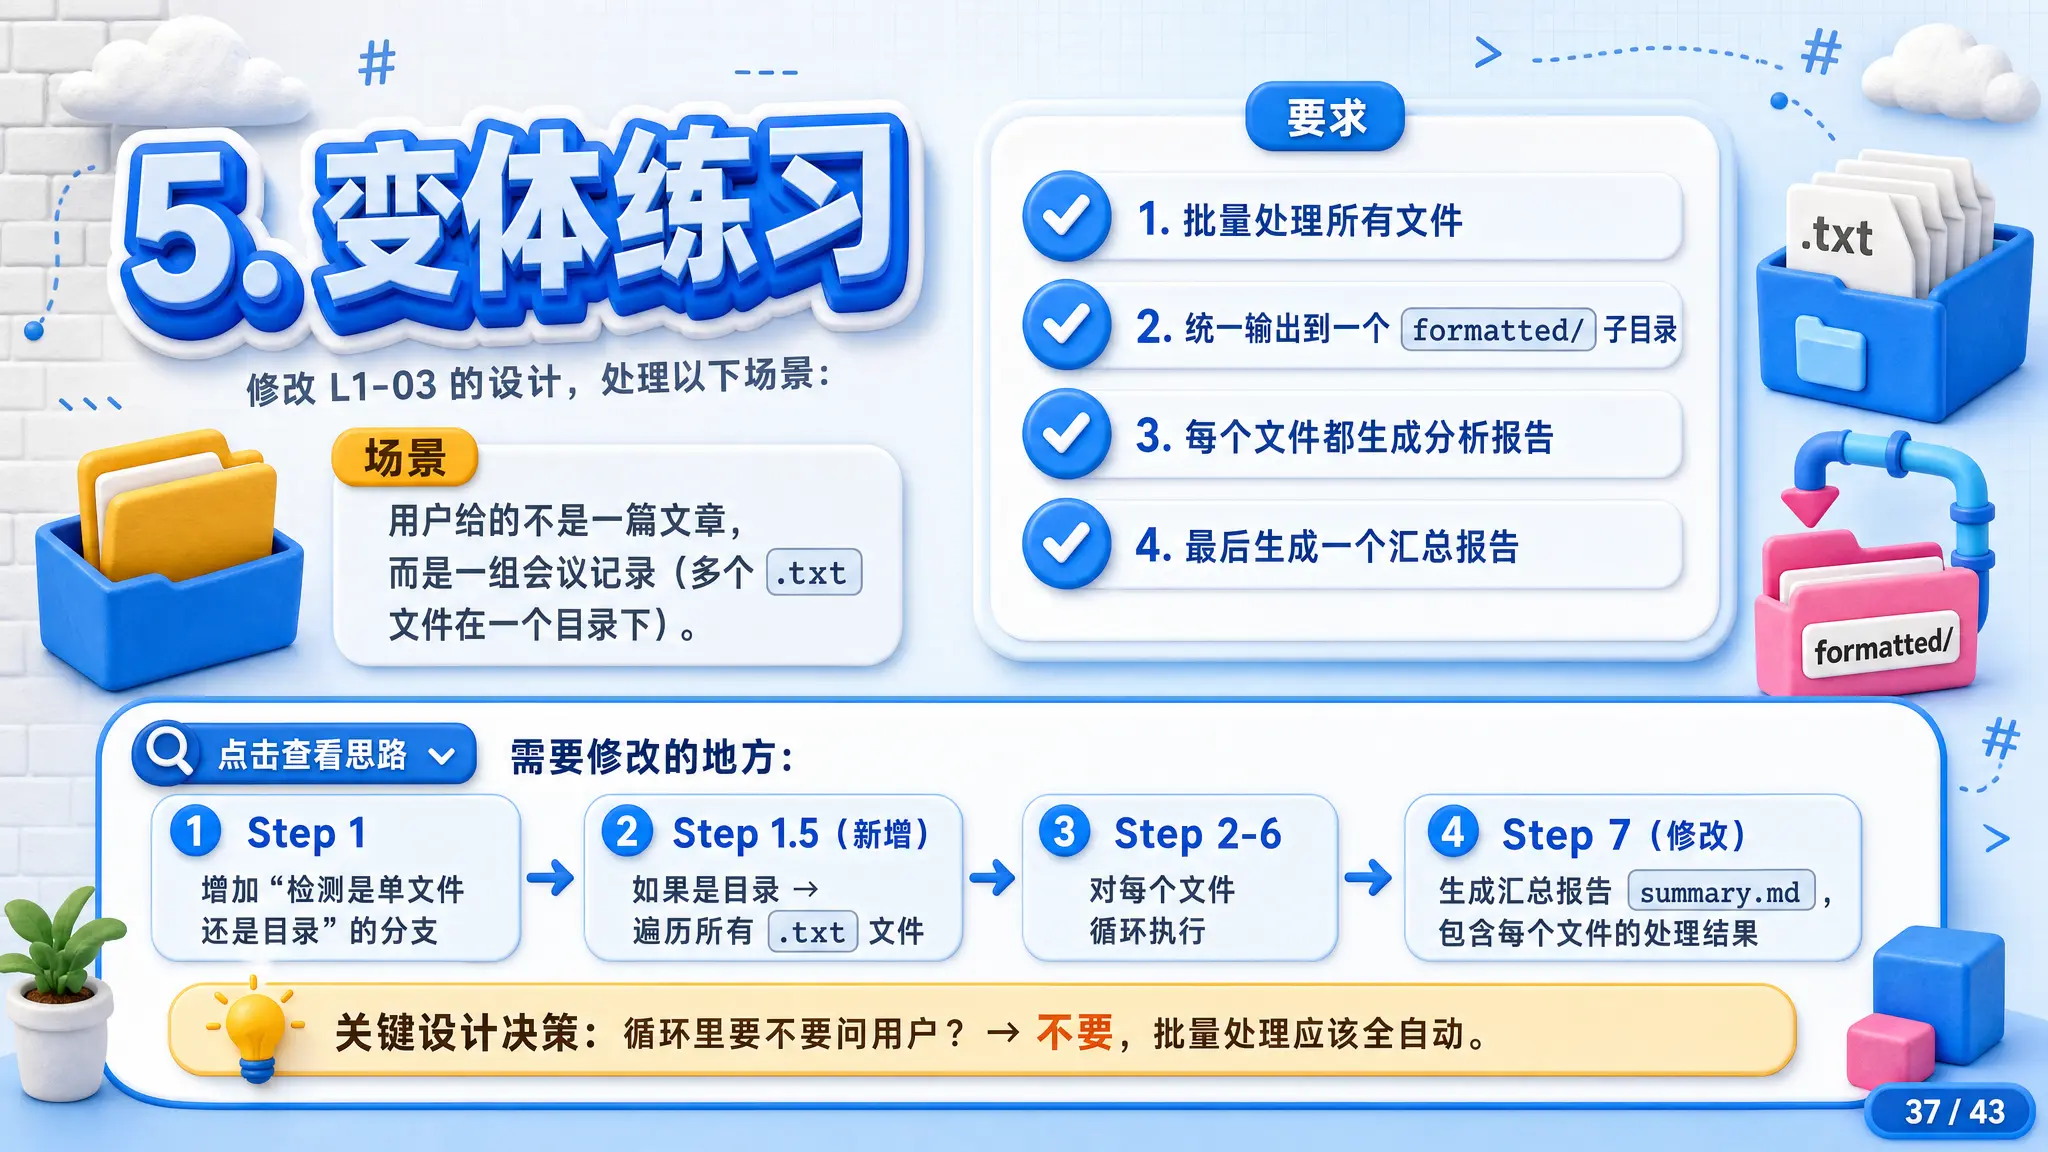
修改 L1-03 的设计,处理以下场景:
场景:用户给的不是一篇文章,而是一组会议记录(多个 .txt 文件在一个目录下)。
要求:
- 批量处理所有文件
- 统一输出到一个
formatted/子目录 - 每个文件都生成分析报告
- 最后生成一个汇总报告
点击查看思路
需要修改的地方:
- Step 1:增加"检测是单文件还是目录"的分支
- Step 1.5(新增):如果是目录 → 遍历所有
.txt文件 - Step 2-6:对每个文件循环执行
- Step 7(修改):生成汇总报告
summary.md,包含每个文件的处理结果
关键设计决策:循环里要不要问用户?→ 不要,批量处理应该全自动。
6. 深度思考
6.1 "不增删内容"的硬约束
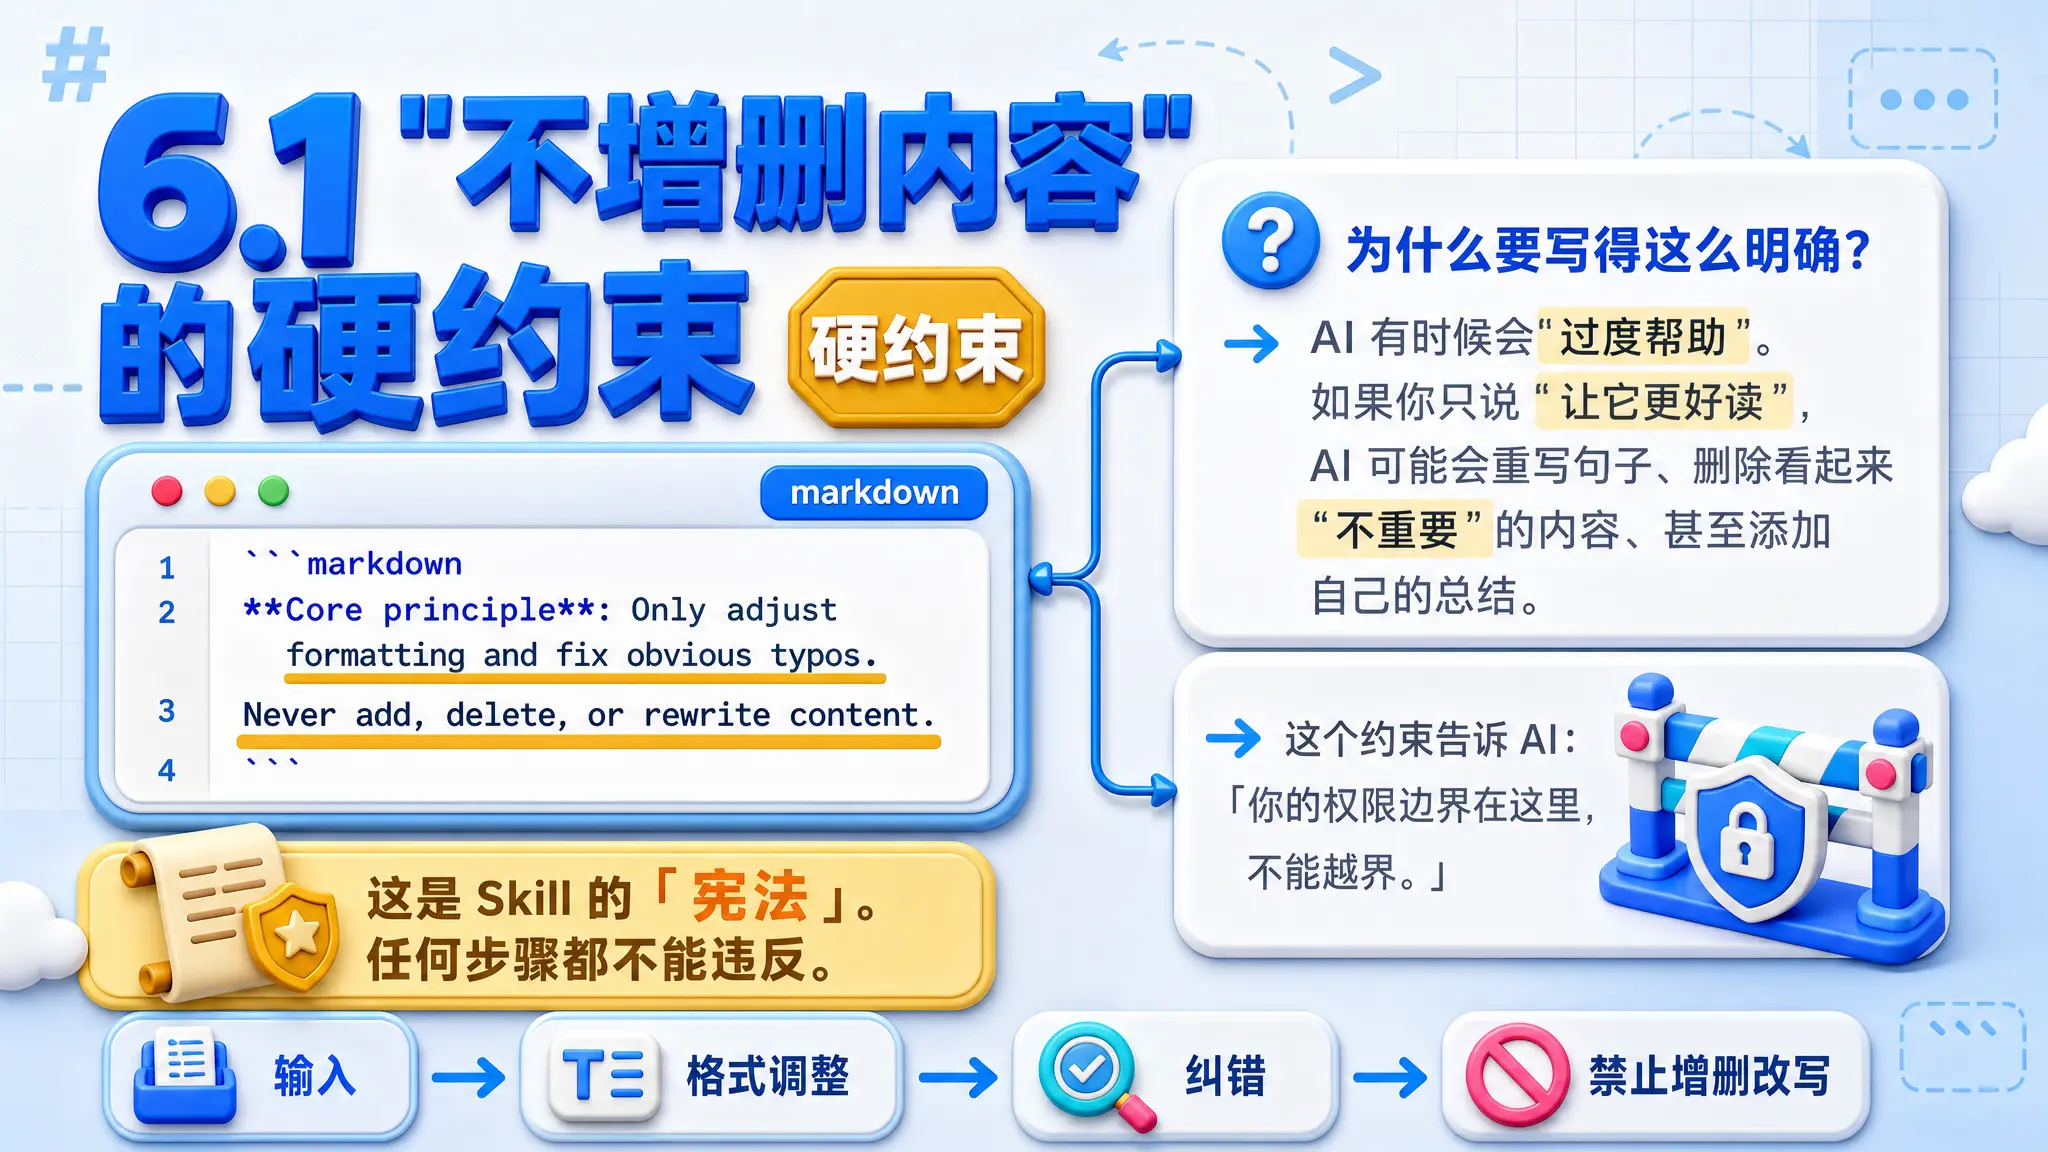
Core principle: Only adjust formatting and fix obvious typos. Never add, delete, or rewrite content.
这是 Skill 的「宪法」。任何步骤都不能违反。
为什么要写得这么明确? → AI 有时候会"过度帮助"。如果你只说"让它更好读",AI 可能会重写句子、删除看起来"不重要"的内容、甚至添加自己的总结。 → 这个约束告诉 AI:「你的权限边界在这里,不能越界。」
6.2 为什么分析报告要单独保存?
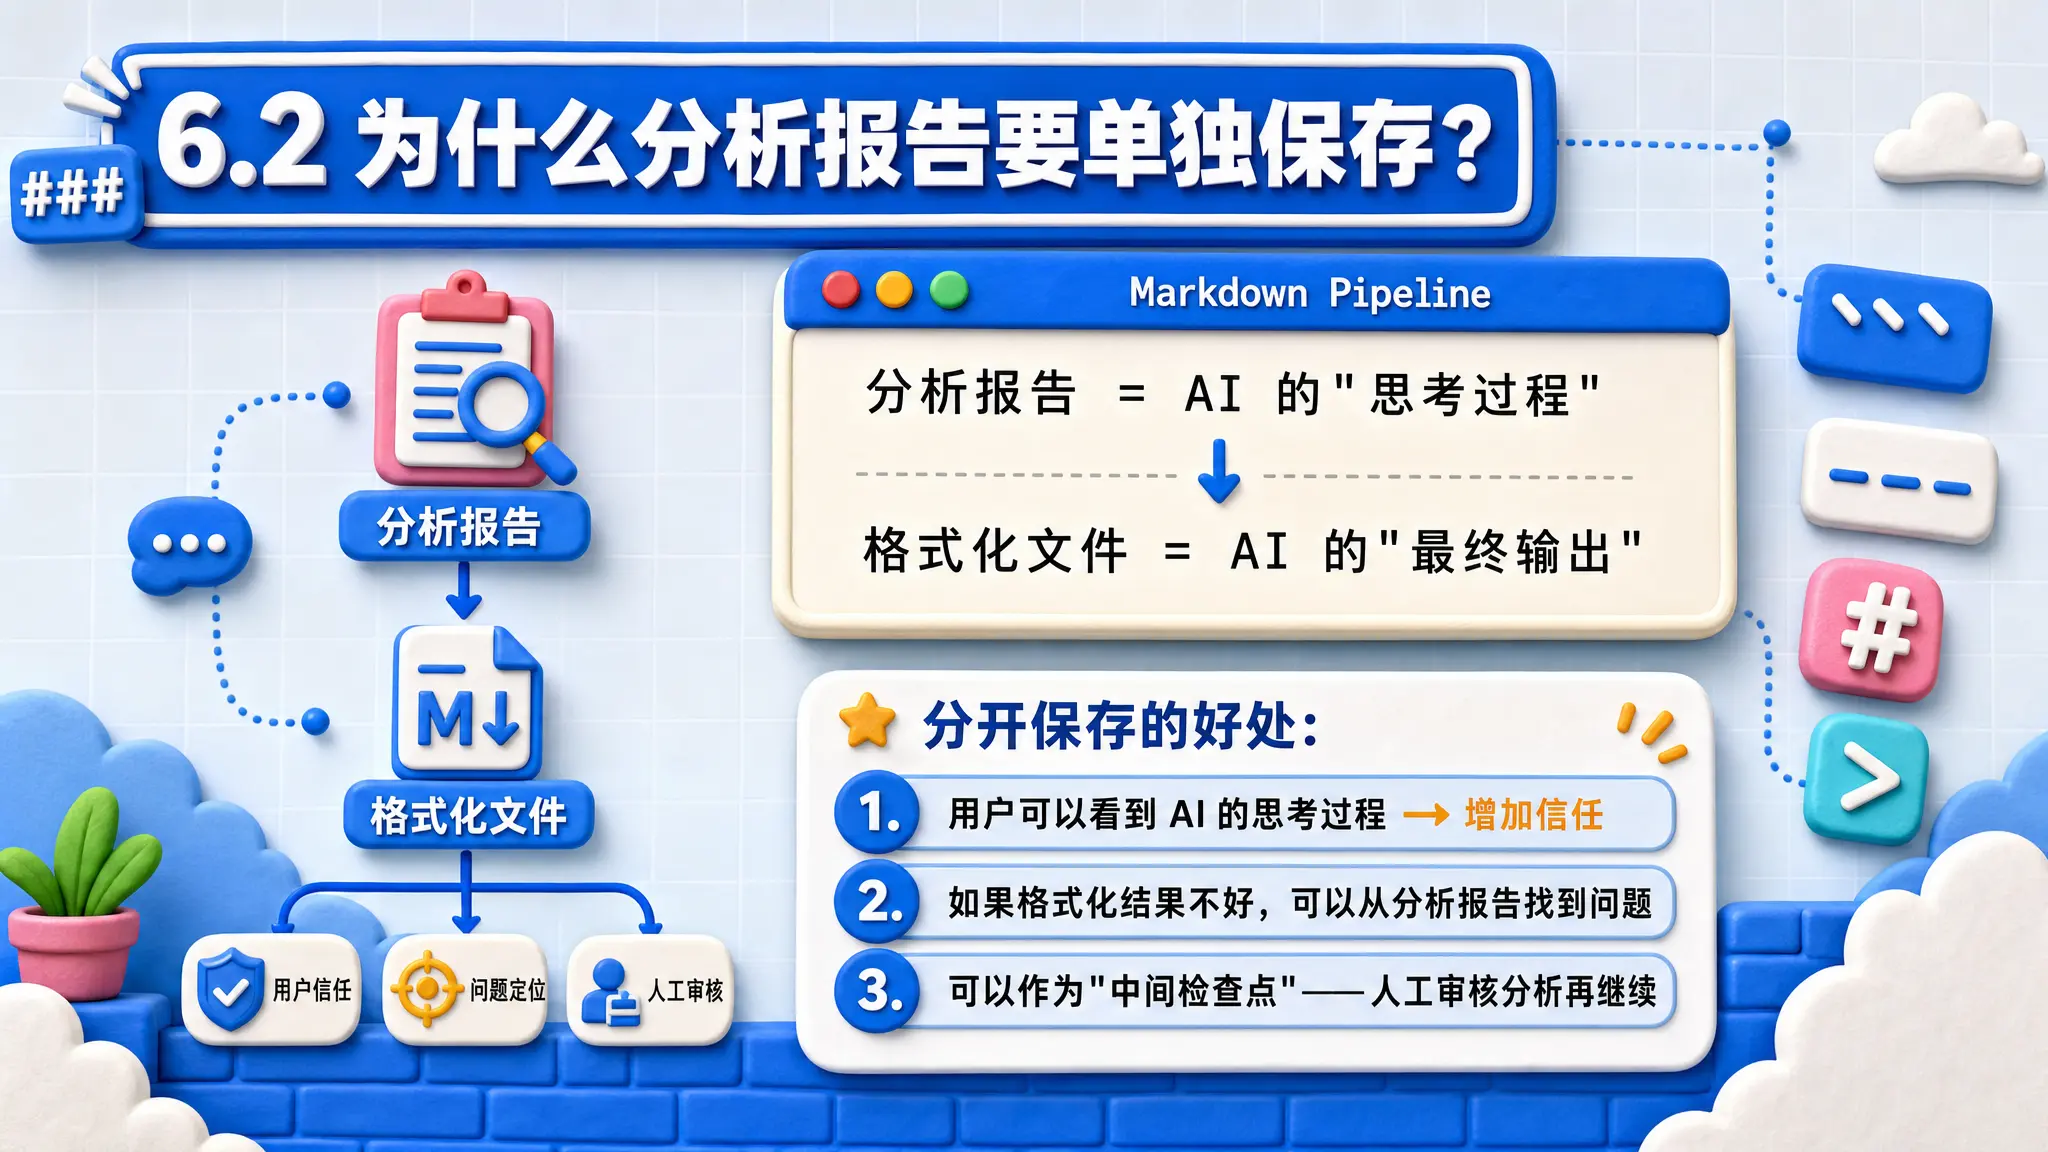
分析报告 = AI 的"思考过程"
格式化文件 = AI 的"最终输出"

分开保存的好处:
1. 用户可以看到 AI 的思考过程 → 增加信任
2. 如果格式化结果不好,可以从分析报告找到问题
3. 可以作为"中间检查点"——人工审核分析再继续
7. 常见错误
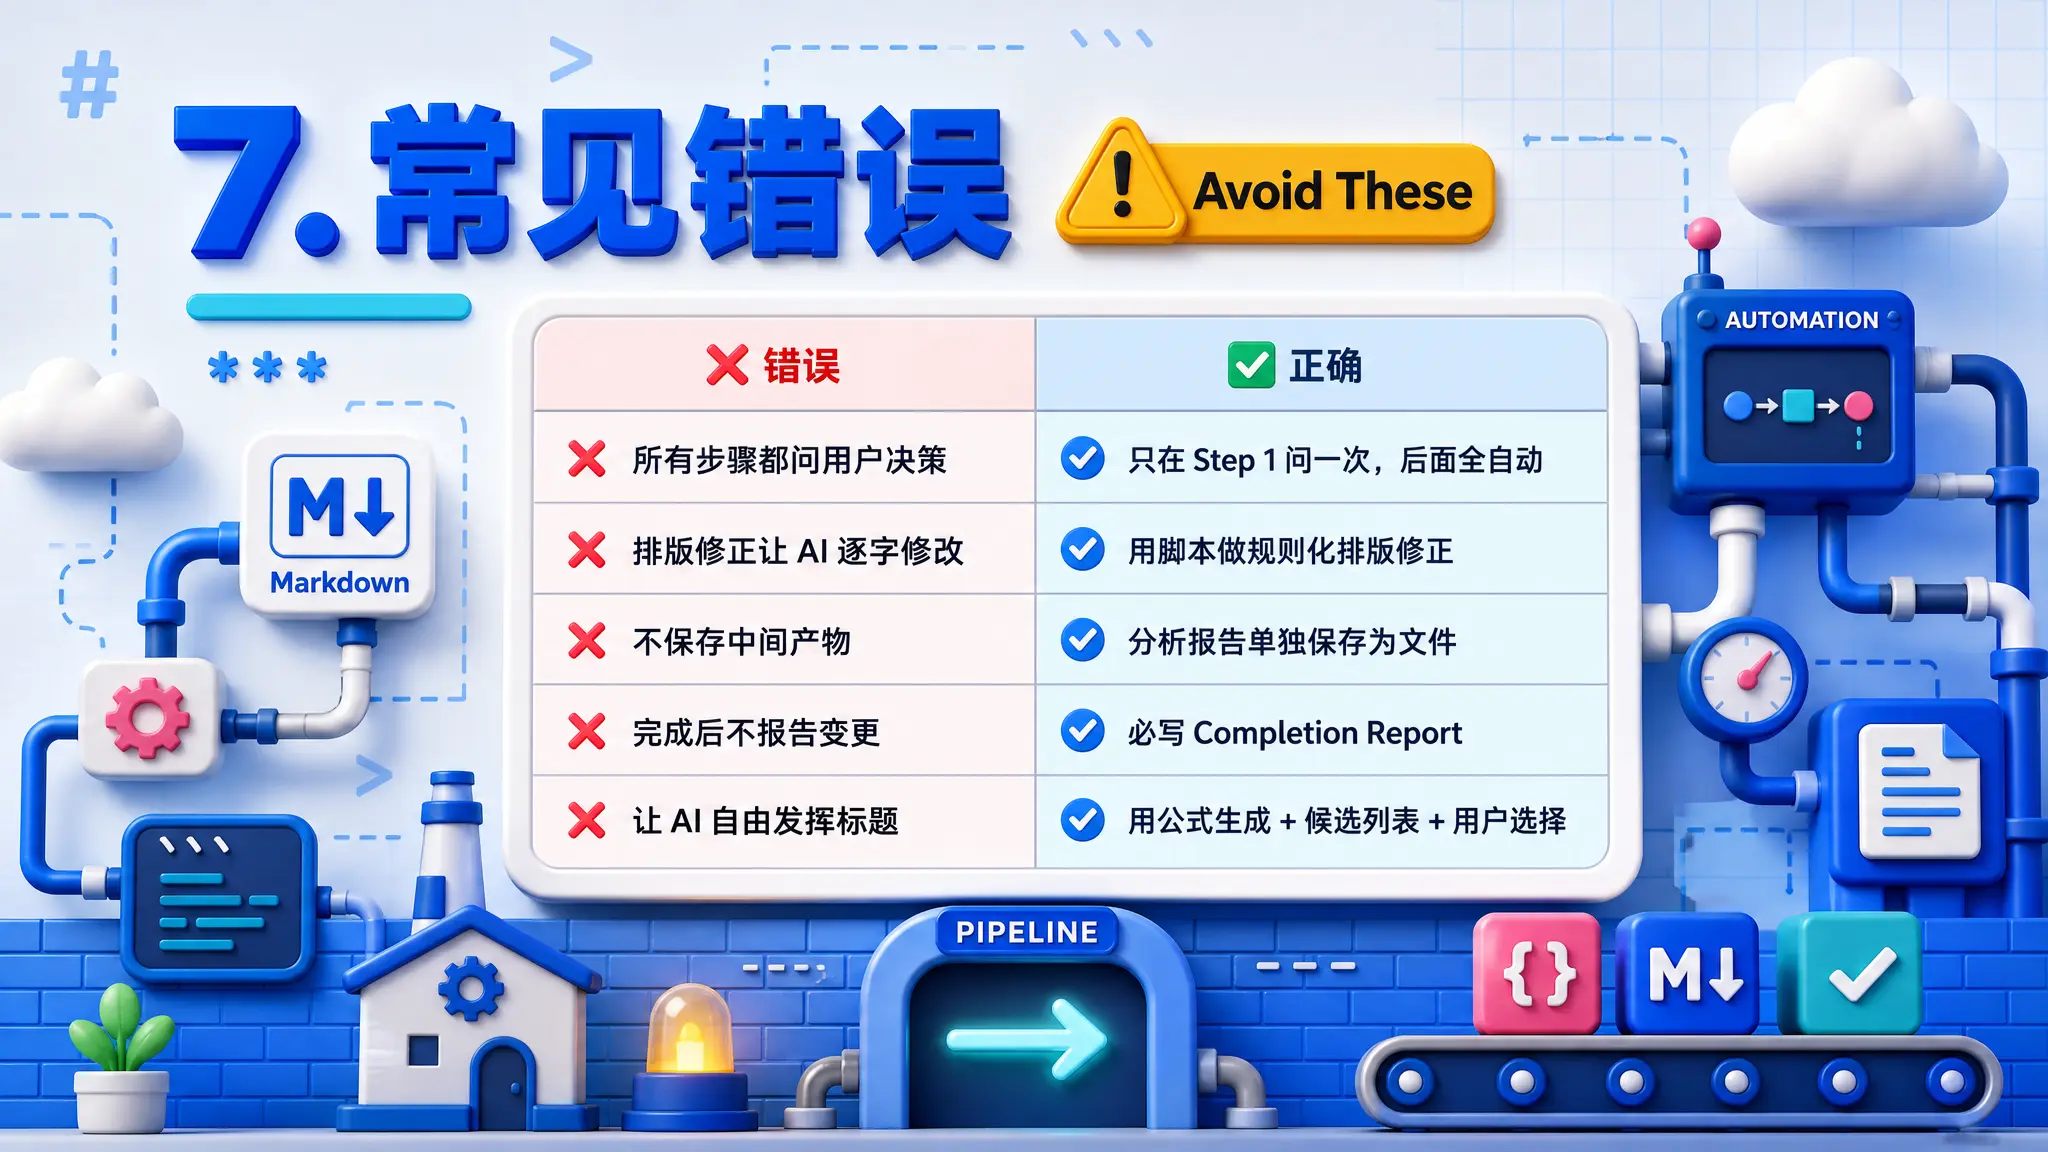
| ❌ 错误 | ✅ 正确 |
|---|---|
| 所有步骤都问用户决策 | 只在 Step 1 问一次,后面全自动 |
| 排版修正让 AI 逐字修改 | 用脚本做规则化排版修正 |
| 不保存中间产物 | 分析报告单独保存为文件 |
| 完成后不报告变更 | 必写 Completion Report |
| 让 AI 自由发挥标题 | 用公式生成 + 候选列表 + 用户选择 |
8. 掌握检验
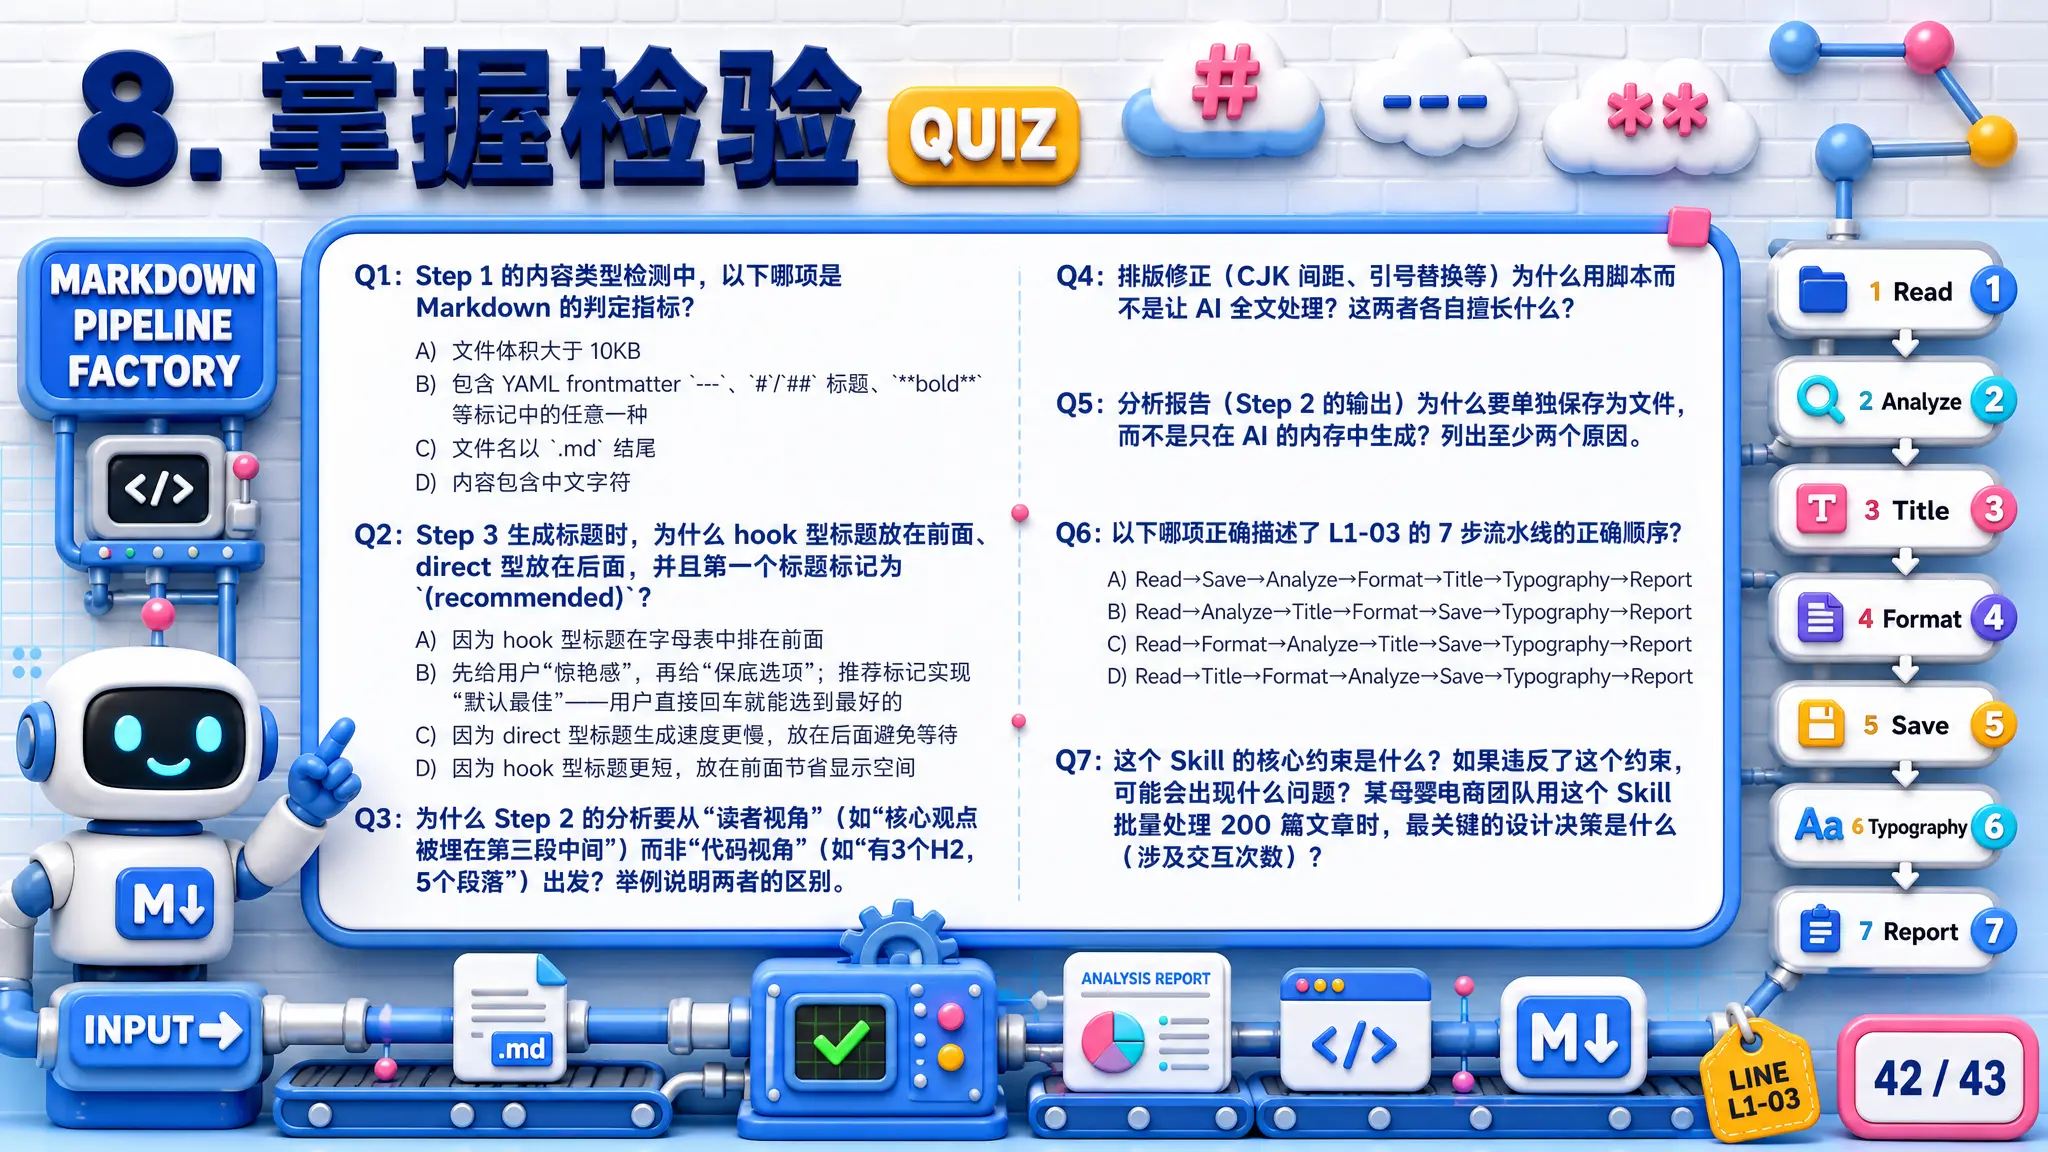
Q1:Step 1 的内容类型检测中,以下哪项是 Markdown 的判定指标?
- A) 文件体积大于 10KB
- B) 包含 YAML frontmatter
---、#/##标题、**bold**等标记中的任意一种 - C) 文件名以
.md结尾 - D) 内容包含中文字符
Q2:Step 3 生成标题时,为什么 hook 型标题放在前面、direct 型放在后面,并且第一个标题标记为 (recommended)?
- A) 因为 hook 型标题在字母表中排在前面
- B) 先给用户"惊艳感",再给"保底选项";推荐标记实现"默认最佳"——用户直接回车就能选到最好的
- C) 因为 direct 型标题生成速度更慢,放在后面避免等待
- D) 因为 hook 型标题更短,放在前面节省显示空间
Q3:为什么 Step 2 的分析要从"读者视角"(如"核心观点被埋在第三段中间")而非"代码视角"(如"有3个H2,5个段落")出发?举例说明两者的区别。
Q4:排版修正(CJK 间距、引号替换等)为什么用脚本而不是让 AI 全文处理?这两者各自擅长什么?
Q5:分析报告(Step 2 的输出)为什么要单独保存为文件,而不是只在 AI 的内存中生成?列出至少两个原因。
Q6:以下哪项正确描述了 L1-03 的 7 步流水线的正确顺序?
- A) Read→Save→Analyze→Format→Title→Typography→Report
- B) Read→Analyze→Title→Format→Save→Typography→Report
- C) Read→Format→Analyze→Title→Save→Typography→Report
- D) Read→Title→Format→Analyze→Save→Typography→Report
Q7:这个 Skill 的核心约束是什么?如果违反了这个约束,可能会出现什么问题?某母婴电商团队用这个 Skill 批量处理 200 篇文章时,最关键的设计决策是什么(涉及交互次数)?
9. 答案
点击查看答案
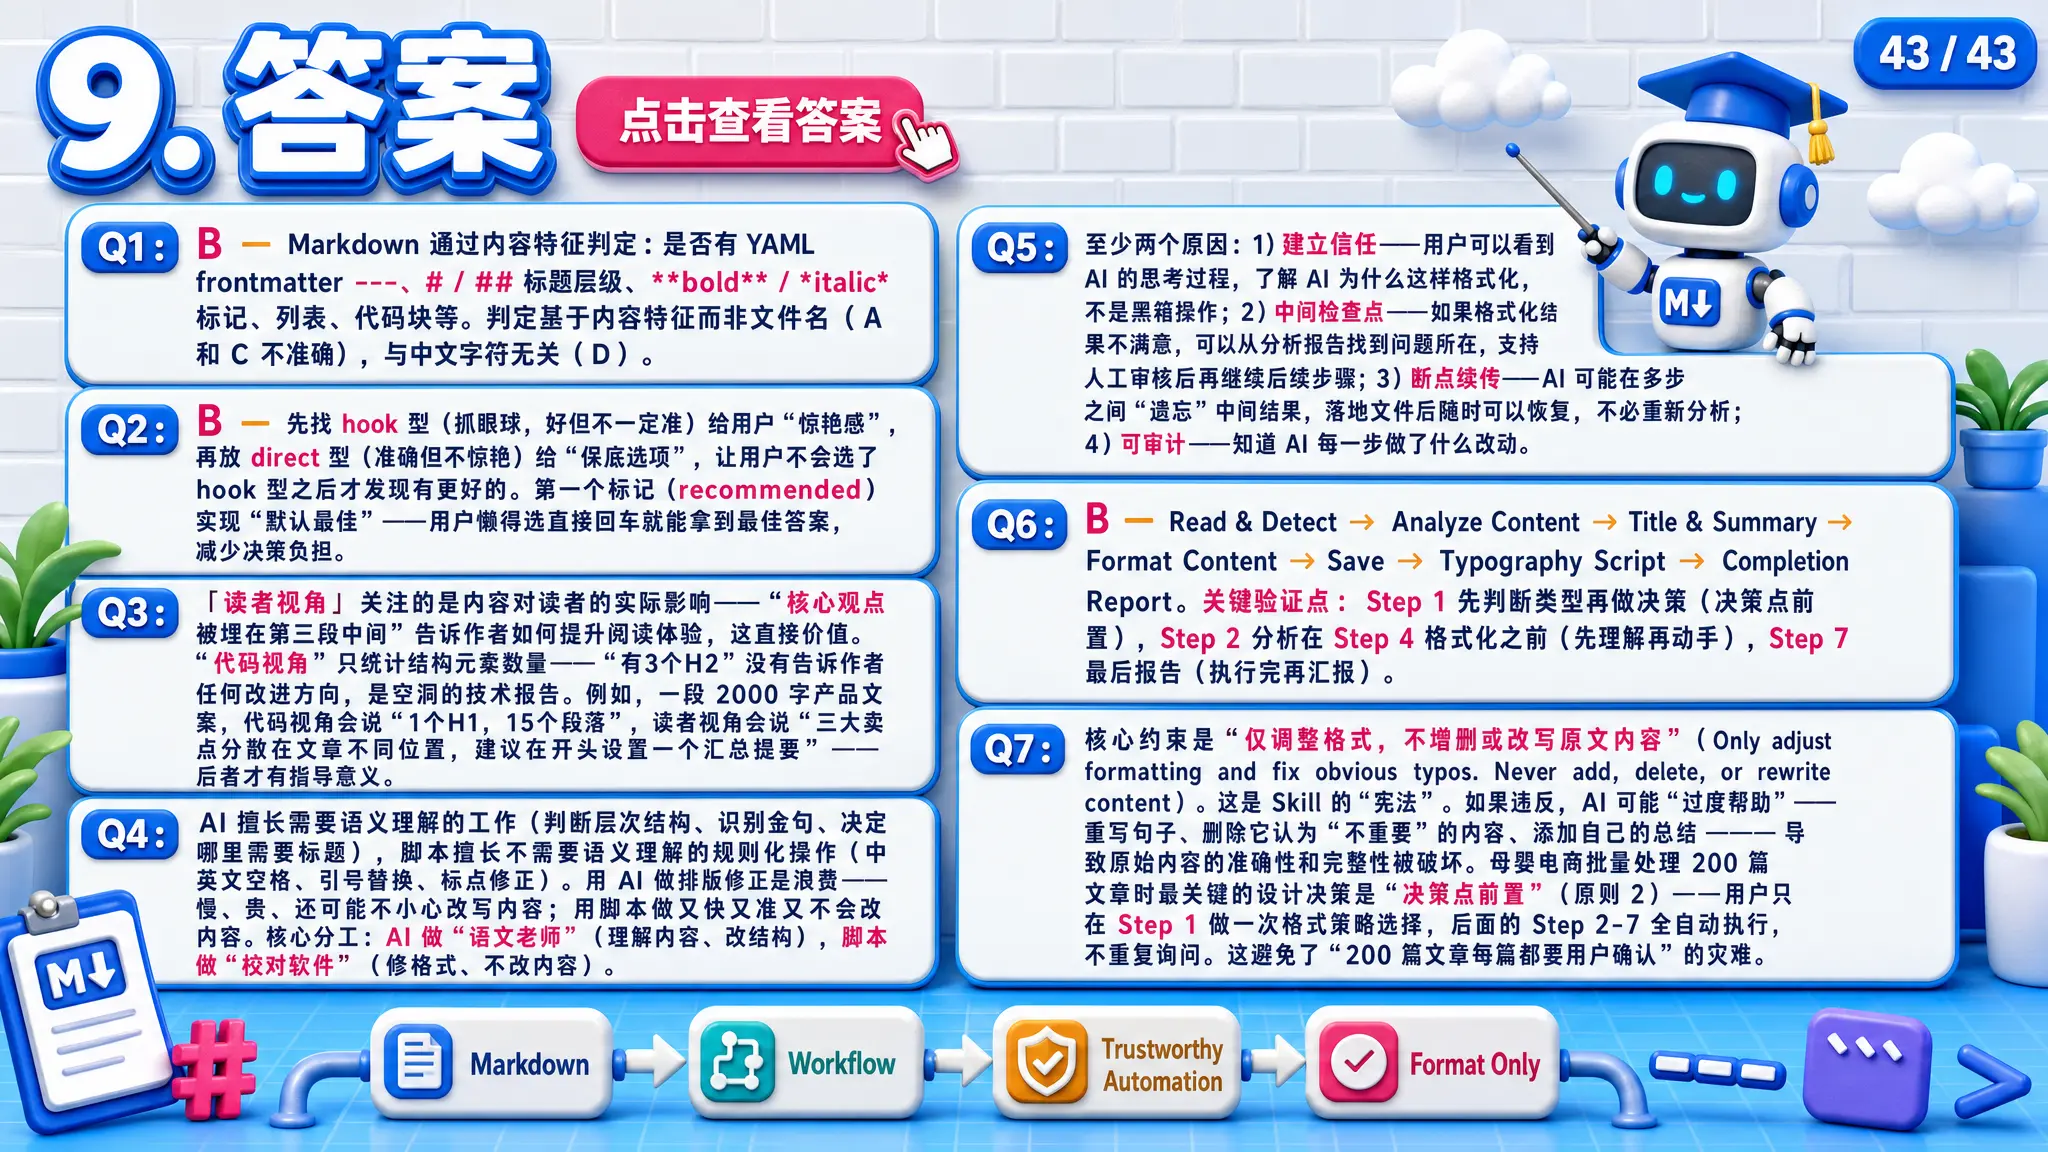
Q1:B — Markdown 通过内容特征判定:是否有 YAML frontmatter ---、#/## 标题层级、**bold**/*italic* 标记、列表、代码块等。判定基于内容特征而非文件名(A 和 C 不准确),与中文字符无关(D)。
Q2:B — 先找 hook 型(抓眼球,好但不一定准)给用户"惊艳感",再放 direct 型(准确但不惊艳)给"保底选项",让用户不会选了 hook 型之后才发现有更好的。第一个标记 (recommended) 实现"默认最佳"——用户懒得选直接回车就能拿到最佳答案,减少决策负担。
Q3:「读者视角」关注的是内容对读者的实际影响——"核心观点被埋在第三段中间"告诉作者如何提升阅读体验,这直接价值。"代码视角"只统计结构元素数量——"有3个H2"没有告诉作者任何改进方向,是空洞的技术报告。例如,一段 2000 字产品文案,代码视角会说"1个H1,15个段落",读者视角会说"三大卖点分散在文章不同位置,建议在开头设置一个汇总提要"——后者才有指导意义。
Q4:AI 擅长需要语义理解的工作(判断层次结构、识别金句、决定哪里需要标题),脚本擅长不需要语义理解的规则化操作(中英文空格、引号替换、标点修正)。用 AI 做排版修正是浪费——慢、贵、还可能不小心改写内容;用脚本做又快又准又不会改内容。核心分工:AI 做"语文老师"(理解内容、改结构),脚本做"校对软件"(修格式、不改内容)。
Q5:至少两个原因:1) 建立信任——用户可以看到 AI 的思考过程,了解 AI 为什么这样格式化,不是黑箱操作;2) 中间检查点——如果格式化结果不满意,可以从分析报告找到问题所在,支持人工审核后再继续后续步骤;3) 断点续传——AI 可能在多步之间"遗忘"中间结果,落地文件后随时可以恢复,不必重新分析;4) 可审计——知道 AI 每一步做了什么改动。
Q6:B — Read & Detect → Analyze Content → Title & Summary → Format Content → Save → Typography Script → Completion Report。关键验证点:Step 1 先判断类型再做决策(决策点前置),Step 2 分析在 Step 4 格式化之前(先理解再动手),Step 7 最后报告(执行完再汇报)。
Q7:核心约束是**"仅调整格式,不增删或改写原文内容"(Only adjust formatting and fix obvious typos. Never add, delete, or rewrite content)。这是 Skill 的"宪法"。如果违反,AI 可能"过度帮助"——重写句子、删除它认为"不重要"的内容、添加自己的总结——导致原始内容的准确性和完整性被破坏。母婴电商批量处理 200 篇文章时最关键的设计决策是"决策点前置"**(原则 2)——用户只在 Step 1 做一次格式策略选择,后面的 Step 2-7 全自动执行,不重复询问。这避免了"200 篇文章每篇都要用户确认"的灾难。
(6/7 通过)
10. 延伸阅读
- [[L1-04-YouTube字幕提取|下一课:视频字幕提取]] — API 调用的正确封装方式
- [[../../Level0-先修课/L0-01-Skill的本质与工作原理|先修课:Skill到底是什么]] — 为什么每步要落地中间产物
- [[Skill写作教程-从零开始#模式 4「多阶段流水线」型|Skill写作:多阶段流水线完整指南]]
做出来了,下一步:登记
项目能跑只是前半程。源码文档整理、申报材料生成这类重复劳动,可以交给软著通——AI 软件著作权申请工具,材料备齐再提交;登记结果以中国版权保护中心审核为准。