AI 入门通识 · 第 1 章

AI 不是魔法:给初学者的人工智能底层逻辑

完全没接触过 AI 也能读懂的底层逻辑课:模型在做什么、能力边界在哪、为什么它有时答非所问。零基础入门的第一课。

  • 学什么AI 不是魔法:给初学者的人工智能底层逻辑
  • 难度L0
  • 预计时间45 分钟
  • 涉及工具AI入门 / 人工智能

AI 不是魔法:给初学者的人工智能底层逻辑

AI不是魔法——人人都能听懂的人工智能底层逻辑课(小白通识)
图片是《AI不是魔法:人人都能听懂的人工智能底层逻辑课》课程的封面。左侧为课程标题及副标题,下方有“一套讲透AI底层逻辑的通识课程”字样,还标注了“2024 EDITION”和“COURSE PACKAGE”。右侧是黑白几何图形构成的立体结构,下方有“SYSTEM THINKING FIRST”字样。封面左侧边缘有“AI · 001”标识,右侧边缘有“AI-001”标识。该图片与文档中介绍该课程的内容相呼应,直观呈现了课程主题和风格。

一、认识AI模型家族

01 大语言模型LLM:负责读、写、聊和分析

图片以“01大语言模型LLM 负责读、写、聊和分析”为标题,左侧有数字“01”及“大语言模型LLM”字样,下方是“负责读、写、聊和分析”的文字。右侧是一个黑色剪影头像,头像内有对话框,对话框内有文字线条,头像右侧还有文件图标。该图片与文档中介绍大语言模型LLM负责读、写、聊和分析的内容相契合,直观呈现了大语言模型的功能。

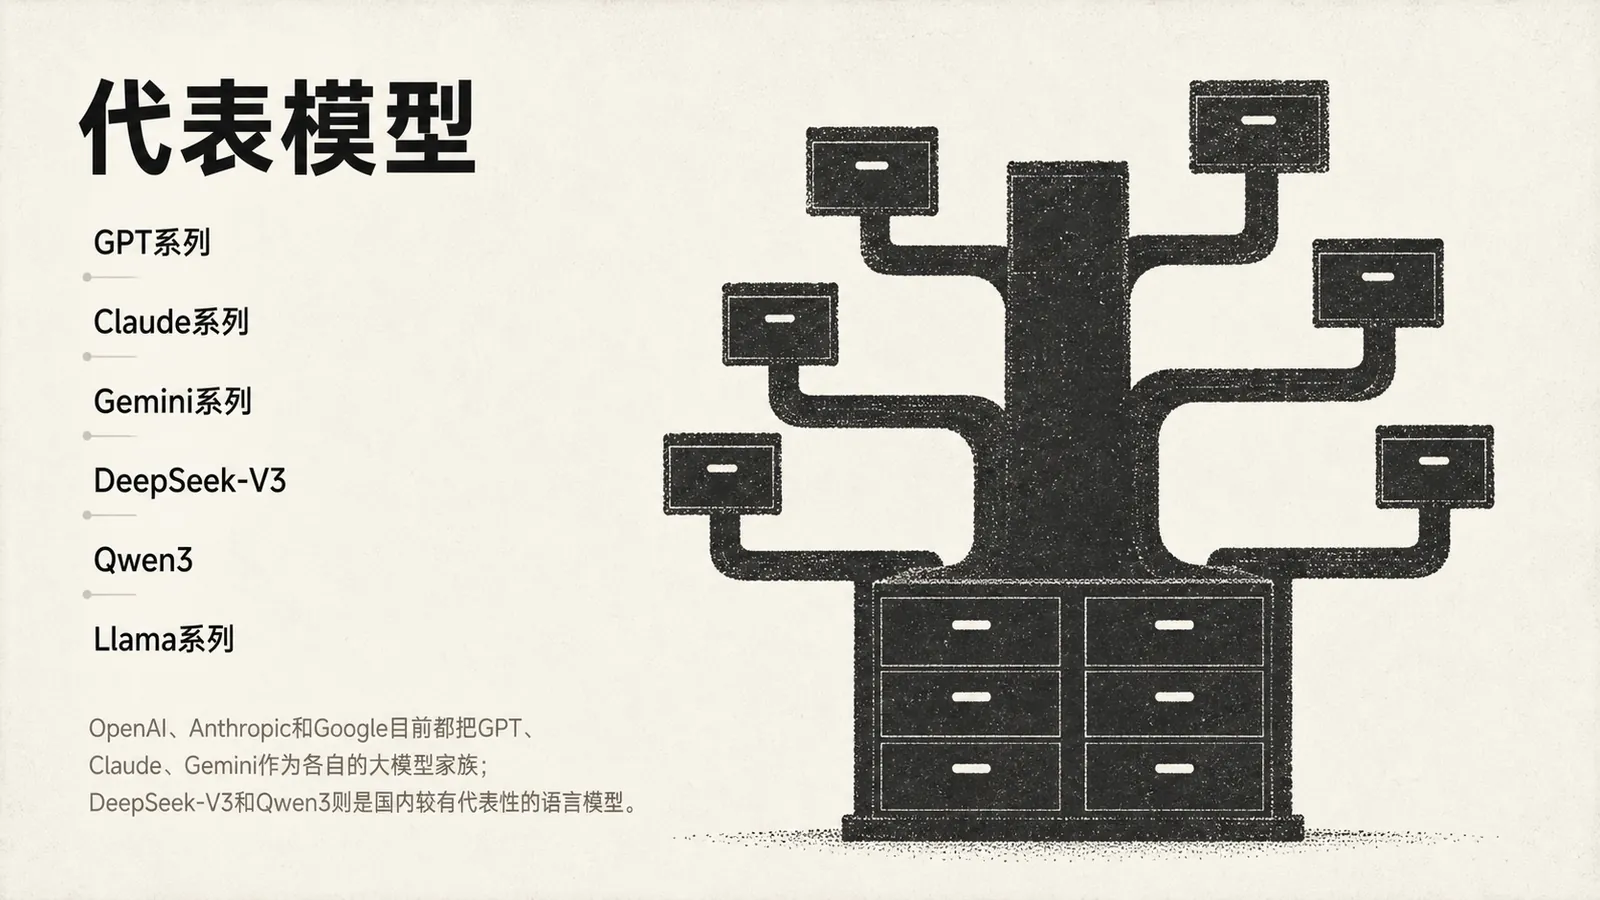
代表模型

图片以“代表模型”为标题,展示了大语言模型家族的代表模型。左侧列出GPT系列、Claude系列、Gemini系列、DeepSeek - V3、Qwen3、Llama系列等模型名称。右侧以一棵树的图案呈现,树干底部有抽屉,树干上长出多个分支,每个分支末端都有一个方块,象征着这些代表模型。图片下方补充说明OpenAI、Anthropic和Google把GPT、Claude、Gemini作为各自大模型家族,DeepSeek - V3和Qwen3是国内较有代表性的语言模型。

  • GPT系列
  • Claude系列
  • Gemini系列
  • DeepSeek-V3
  • Qwen3
  • Llama系列

OpenAI、Anthropic和Google目前都把GPT、Claude、Gemini作为各自的大模型家族;DeepSeek-V3和Qwen3则是国内较有代表性的语言模型。

举例
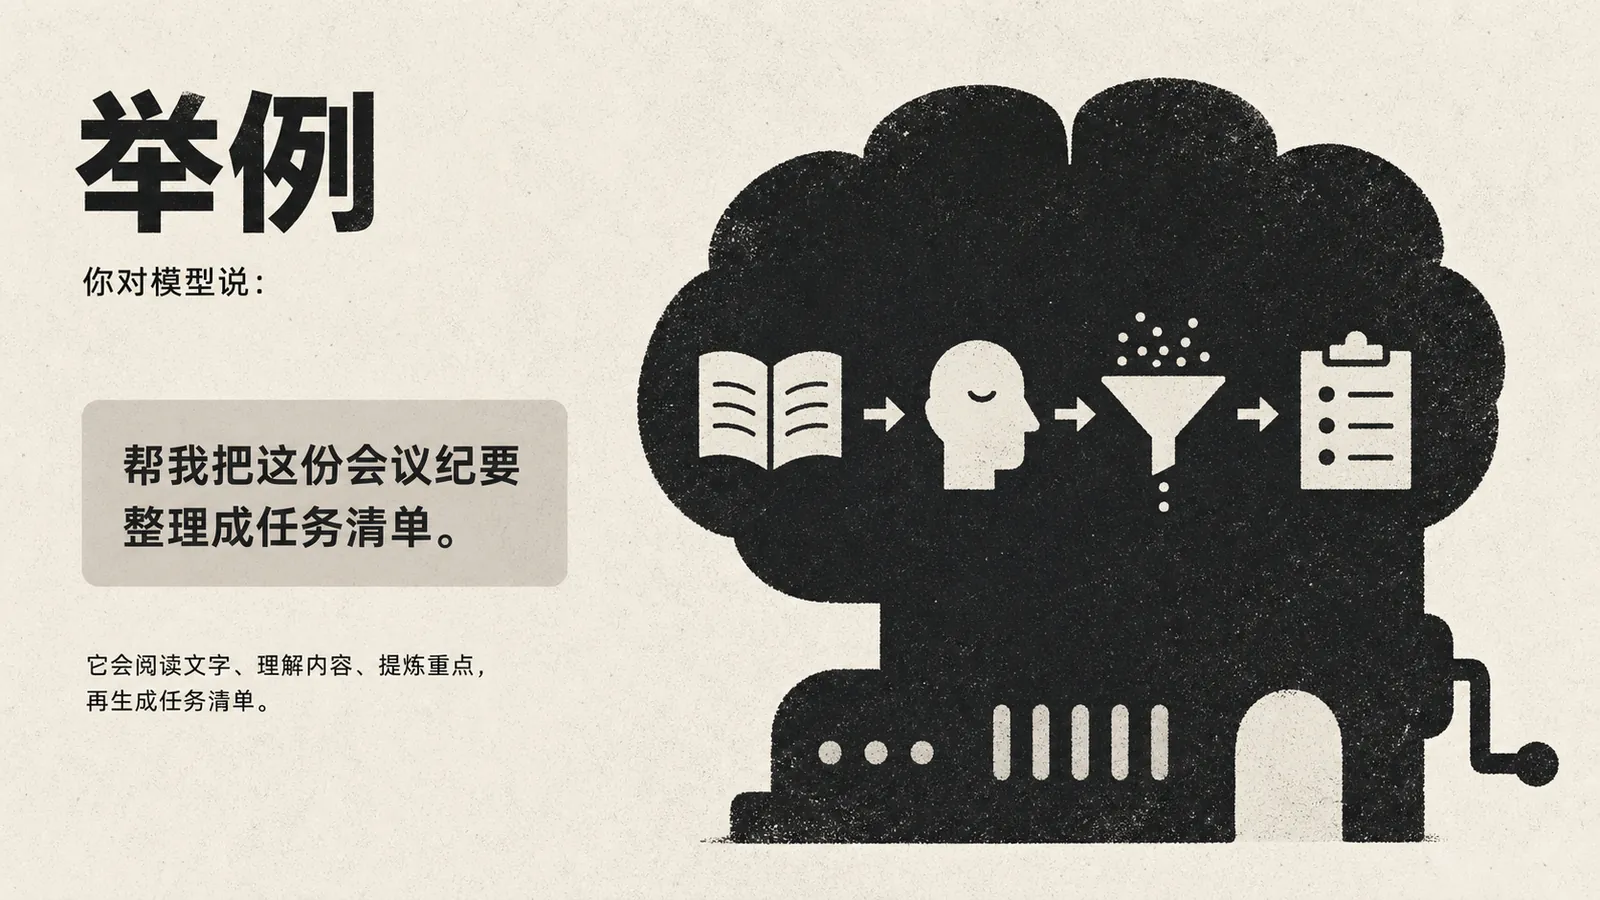
这张图片对应文档中关于大语言模型LLM“举例”的相关内容,以图文结合的形式展示了大语言模型处理任务的过程。图片左侧明确标注了“举例”和“你对模型说:帮我把这份会议纪要整理成任务清单”的指令内容,下方还补充说明了模型会通过“阅读文字、理解内容、提炼重点,再生成任务清单”完成该操作。右侧以大脑造型的图形配合箭头,依次呈现了读取内容、提炼重点、生成任务清单的处理流程,清晰直观地解释了大语言模型处理文本类需求的具体方式。

你对模型说:

帮我把这份会议纪要整理成任务清单。

它会阅读文字、理解内容、提炼重点,再生成任务清单。

通俗类比
图片以“通俗类比”为标题,说明LLM像一个读过大量资料、特别擅长使用语言的员工。画面左侧文字对应标题及说明,右侧是一个黑色轮廓的男性形象,身穿西装,胸前挂有工作证,右侧有对话框图标。该图片与上下文紧密相关,通过形象化表达,直观说明LLM具备读取大量资料和擅长使用语言的特点,帮助读者更好地理解LLM的功能和工作方式。

LLM像一个读过大量资料、特别擅长使用语言的员工。

需要特别说明

图片以“需要特别说明”为标题,阐述LLM(大语言模型)不是“文字搜索器”。其内容强调LLM不会从数据库中找到现成答案,而是根据上下文和训练中学到的规律生成回答。图片右侧配有放大镜图案,左侧有黑色矩形块,整体配色为浅色背景搭配黑色和灰色元素,与上下文对LLM工作原理的说明相呼应,直观辅助理解其生成回答的特性。

LLM不是“文字搜索器”。

它并不是从数据库里找到一句现成答案,而是根据上下文和训练中学到的规律生成回答。


02 推理模型:负责处理复杂问题
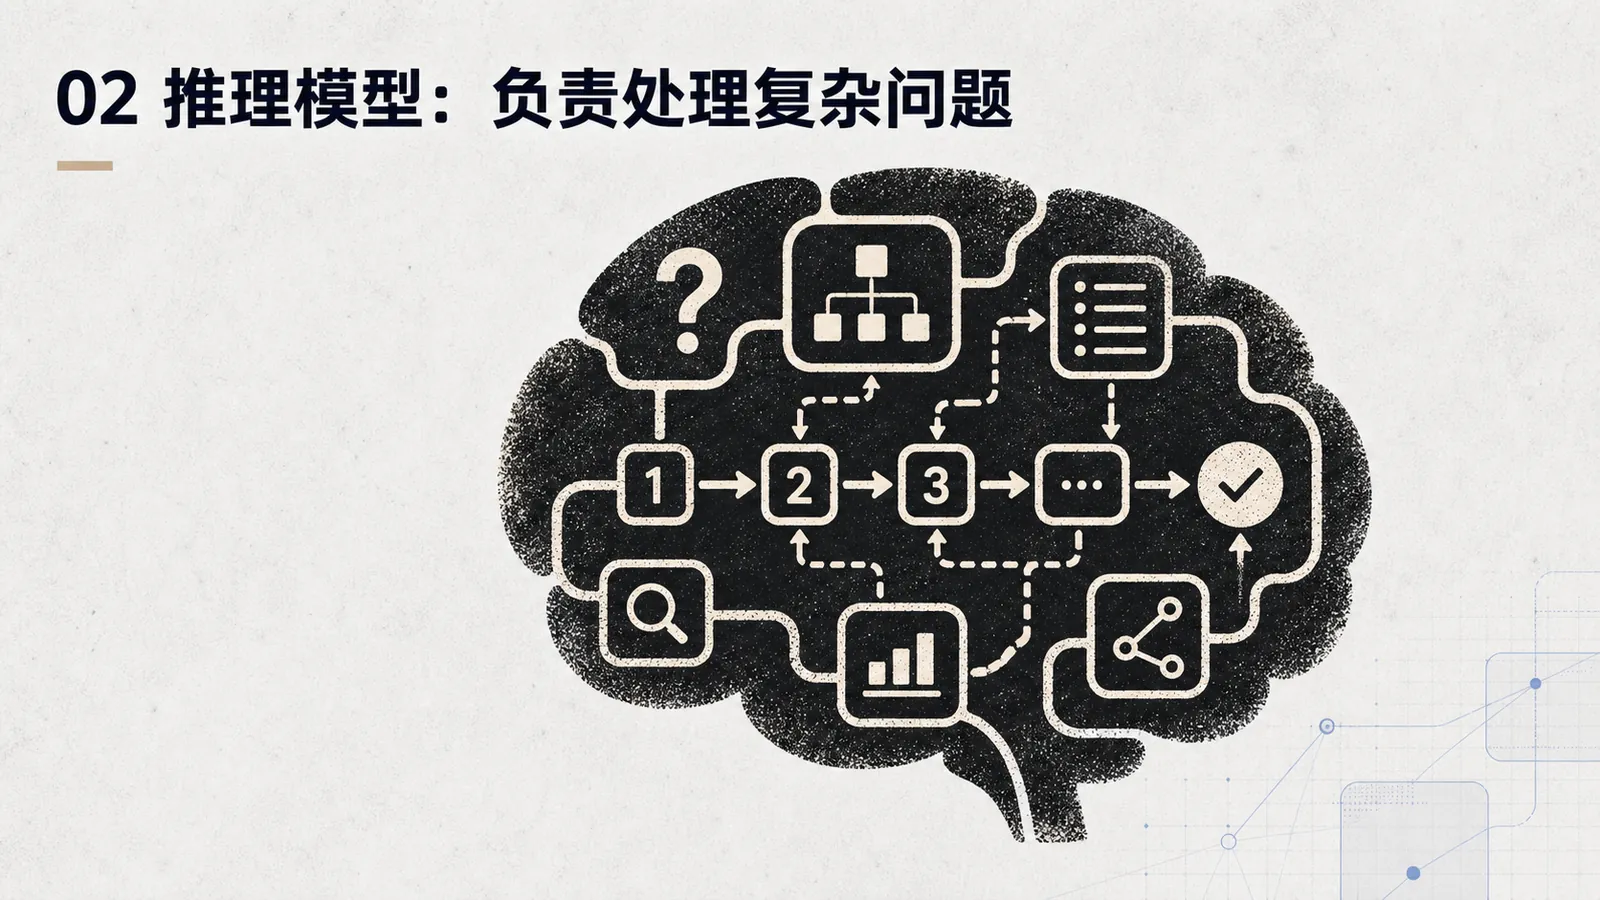
图片以脑部图形为背景,展示推理模型处理复杂问题的流程。左侧上方有“?”符号,下方依次为数字1、2、3及放大镜、图表等图标,右侧有文档、图表、分享等图标,最右侧有对勾符号。该图对应文档中介绍推理模型负责处理复杂问题的内容,直观呈现了推理模型从问题输入到输出的思维过程,与上下文对推理模型功能的阐述相契合。

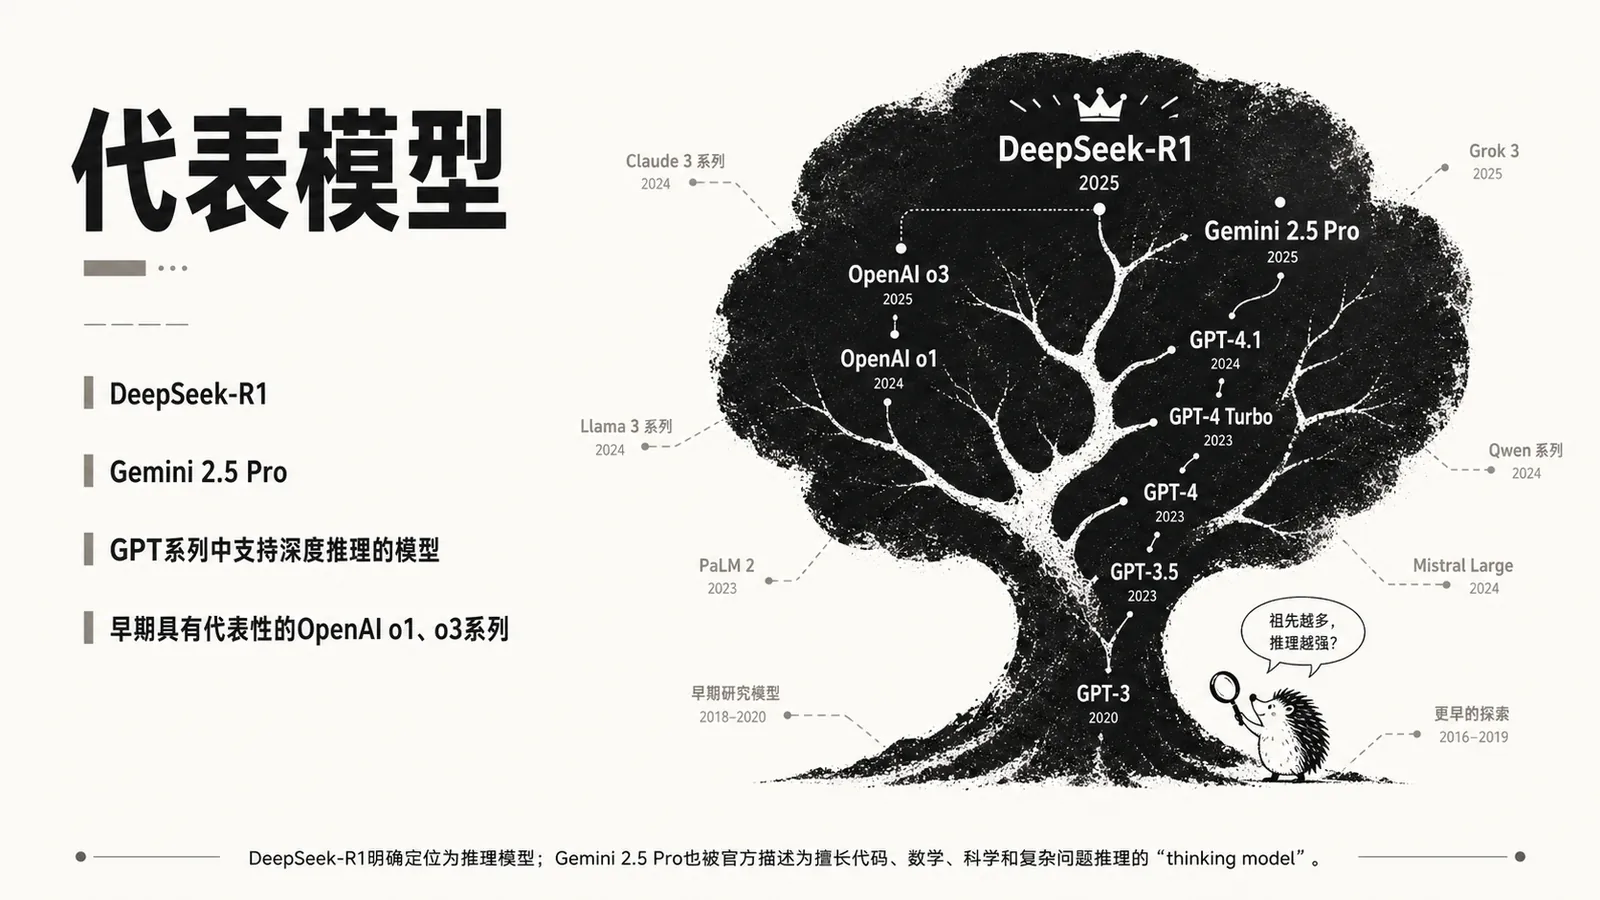
代表模型

图片展示了AI推理模型的代表模型,以一棵树形图呈现。树冠部分标注有“DeepSeek-R1”“Gemini 2.5 Pro”等模型名称,树干及分支上还有“GPT系列中支持深度推理的模型”“早期具有代表性的OpenAI o1、o3系列”等文字。图片下方有“DeepSeek-R1明确定位为推理模型;Gemini 2.5 Pro也被官方描述为擅长代码、数学、科学和复杂问题推理的‘thinking model’”的说明。该图与上下文介绍推理模型负责处理复杂问题的内容相呼应,直观呈现了相关代表模型。

  • DeepSeek-R1
  • Gemini 2.5 Pro
  • GPT系列中支持深度推理的模型
  • 早期具有代表性的OpenAI o1、o3系列

DeepSeek-R1明确定位为推理模型;Gemini 2.5 Pro也被官方描述为擅长代码、数学、科学和复杂问题推理的“thinking model”。

举例
图片以“举例”为标题,阐述推理模型处理复杂问题的步骤。画面中人物头像被问号遮挡,背景为深色。文字说明普通模型遇到复杂题会直接给出答案,而推理模型则先整理已知条件,再拆成小问题,分步求解,检查矛盾,最后生成答案。该图片与上下文紧密相关,是对推理模型处理复杂问题方式的具体说明,直观呈现了推理模型的思维过程。

普通模型遇到一道复杂题,可能马上给答案。

推理模型更像:

  1. 先整理已知条件;
  2. 拆成几个小问题;
  3. 分步求解;
  4. 检查前后是否矛盾;
  5. 再生成最终答案。

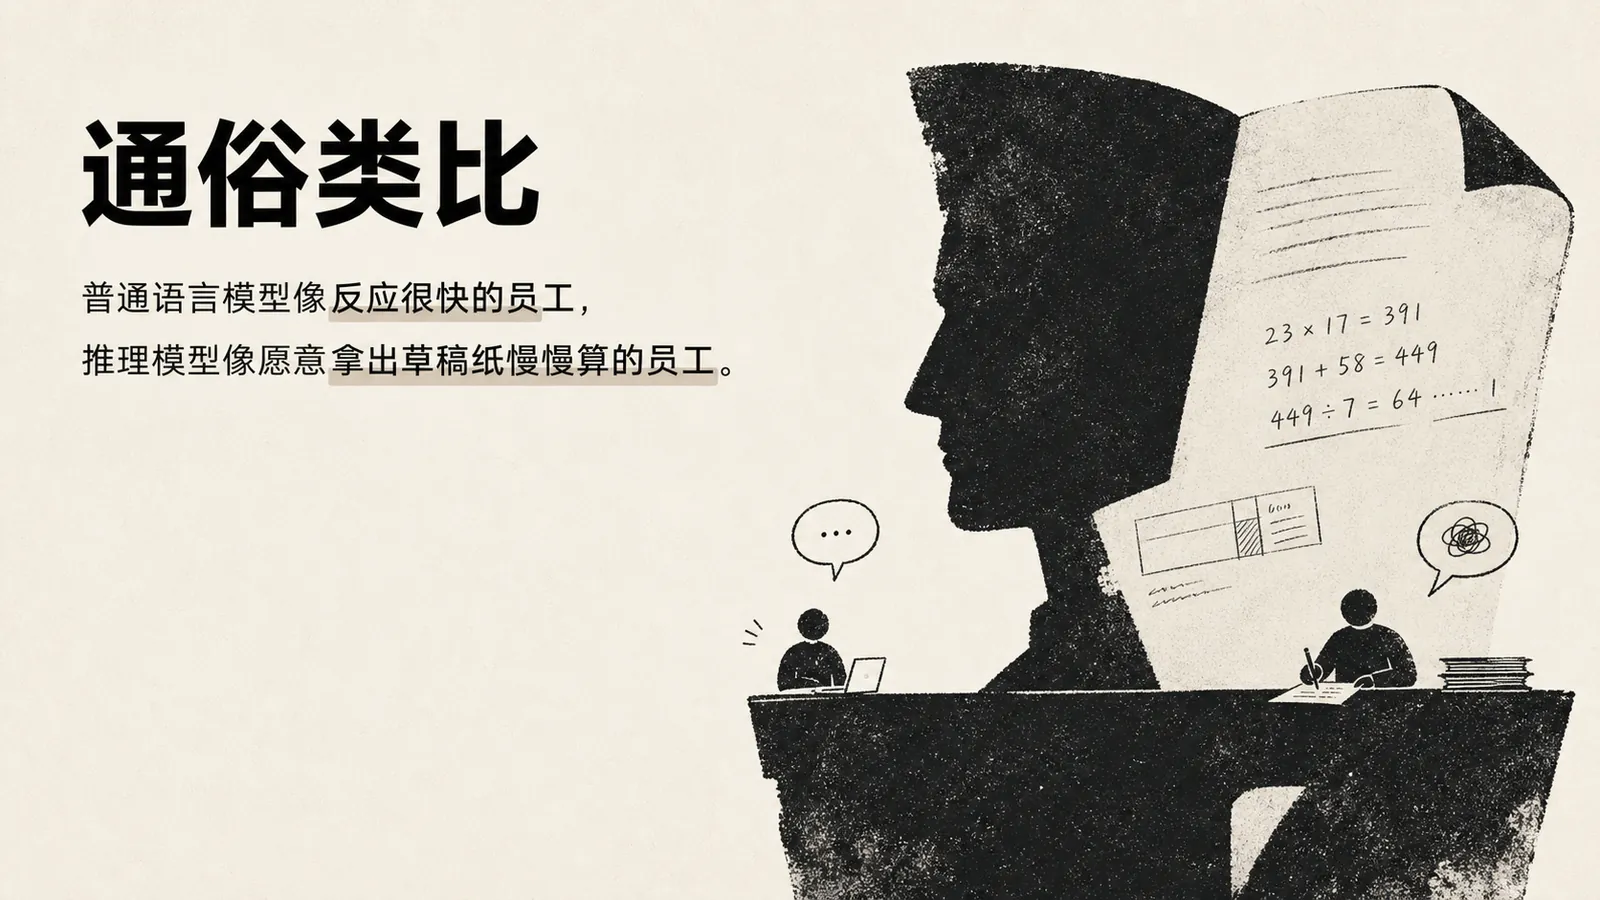
通俗类比

图片以“通俗类比”为标题,将普通语言模型比作反应很快的员工,推理模型比作愿意拿出草稿纸慢慢算的员工。画面中,左侧是反应很快的员工,右侧是正在算题的员工,桌上放着草稿纸,上面写着“23×17=391”“391+58=449”“449÷7=64......”。该图与上下文紧密相关,通过形象对比,直观说明了推理模型处理复杂问题时的思考过程,与上文对推理模型处理问题步骤的阐述相呼应。

普通语言模型像反应很快的员工,推理模型像愿意拿出草稿纸慢慢算的员工。

需要特别说明
图片以“需要特别说明”为标题,阐述推理模型与LLM的关系。它指出推理模型不是完全不同于LLM的新物种,更准确地说,推理模型通常仍属于大语言模型,只是更强调多步骤分析、规划和验证。图片右侧有一个黑色的抽象图形,左侧有文字说明,与上下文对推理模型的介绍相呼应,强调其与LLM的联系与区别。

推理模型不是完全不同于LLM的新物种。

更准确地说:

它通常仍然属于大语言模型,只是更强调多步骤分析、规划和验证。


03 视觉语言模型VLM:负责看懂图片并回答
图片以“视觉语言模型VLM:负责看懂图片并回答”为主题,左侧文字标注“03”,右侧是一只眼睛的图案,眼睛内有对话框,对话框中显示一张山的图片。该图片与文档中介绍视觉语言模型VLM的内容相关,VLM是负责看懂图片并回答的模型,图片直观呈现了VLM的功能,与上下文对VLM的描述相呼应。

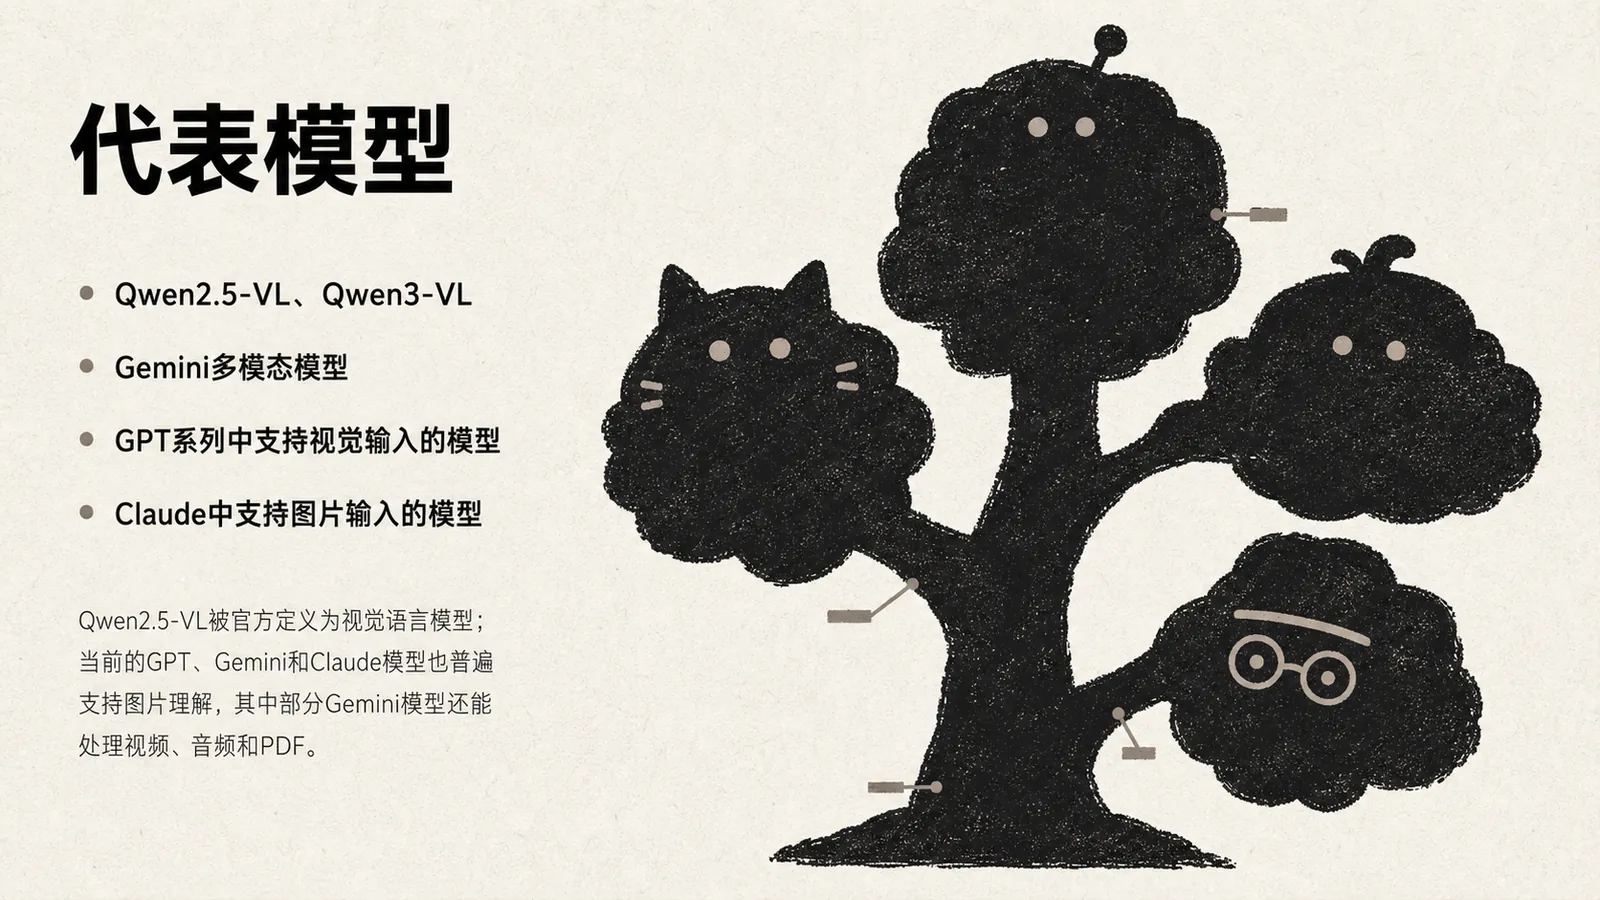
代表模型

图片以树形结构呈现,标题为“代表模型”,列出Qwen2.5-VL、Qwen3-VL、Gemini多模态模型、GPT系列中支持视觉输入的模型、Claude中支持图片输入的模型等视觉语言模型。底部文字说明Qwen2.5-VL被官方定义为视觉语言模型,当前GPT、Gemini和Claude模型普遍支持图片理解,部分Gemini模型还能处理视频、音频和PDF。图片与上下文紧密相关,直观展示了视觉语言模型的代表模型及其特点。

  • Qwen2.5-VL、Qwen3-VL
  • Gemini多模态模型
  • GPT系列中支持视觉输入的模型
  • Claude中支持图片输入的模型

Qwen2.5-VL被官方定义为视觉语言模型;当前的GPT、Gemini和Claude模型也普遍支持图片理解,其中部分Gemini模型还能处理视频、音频和PDF。

举例
图片展示了一张电商主图,图中包含多个化妆品瓶罐、标签等物品。上方文字为“举例”,下方文字是给模型一张电商主图后,问“这张图片为什么看起来不高级?”并列出可能分析的几点:构图太满、字体过多、颜色没有主次、产品主体不突出、光影质感不统一。该图片与上下文紧密相关,是对给定电商主图的分析示例,用于说明视觉语言模型VLM能看懂图片并回答问题的能力。

给模型一张电商主图,问:

这张图片为什么看起来不高级?

它可能分析:

  • 构图太满;
  • 字体过多;
  • 颜色没有主次;
  • 产品主体不突出;
  • 光影质感不统一。

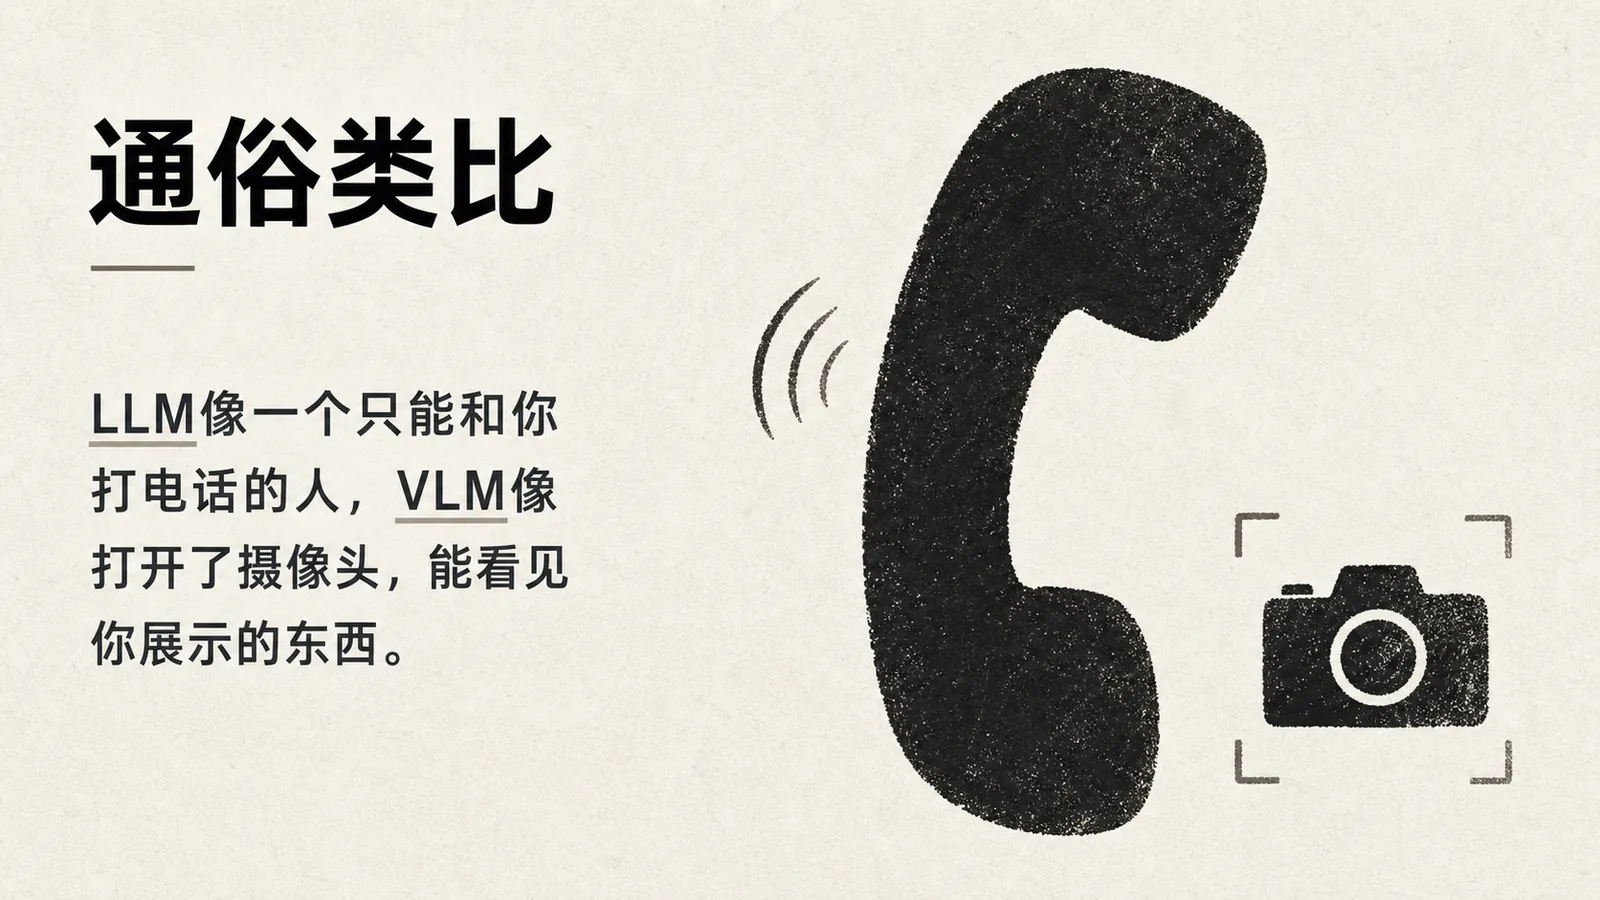
通俗类比

图片以“通俗类比”为标题,将LLM(语言模型)比作只能打电话的人,VLM(视觉语言模型)比作打开摄像头能看见展示东西的人。画面左侧文字对应类比内容,右侧是一个黑色电话听筒图案,其右侧下方有一个黑色相机图案。该图片与上下文紧密相关,通过生动形象的比喻,直观说明了LLM和VLM在功能上的差异,即LLM只能通过语言交流,而VLM能通过视觉理解展示内容。

LLM像一个只能和你打电话的人,VLM像打开了摄像头,能看见你展示的东西。


04 多模态模型:文字、图片、声音和视频都能处理
图片以黑色为主色调,展示了一个黑色的箱子,箱内有文字、图片、音频、视频、PDF、屏幕画面等图标。上方文字为“04 多模态模型:文字、图片、声音和视频都能处理”,并说明VLM主要强调视觉和语言,多模态模型范围更大,可处理文字、图片、音频、视频、PDF、屏幕画面等内容。该图片与上下文紧密相关,直观呈现了多模态模型能处理多种类型信息的特点,是对上下文介绍多模态模型内容的视觉补充。

VLM主要强调视觉和语言。

多模态模型的范围更大,可以处理:

  • 文字
  • 图片
  • 音频
  • 视频
  • PDF
  • 屏幕画面

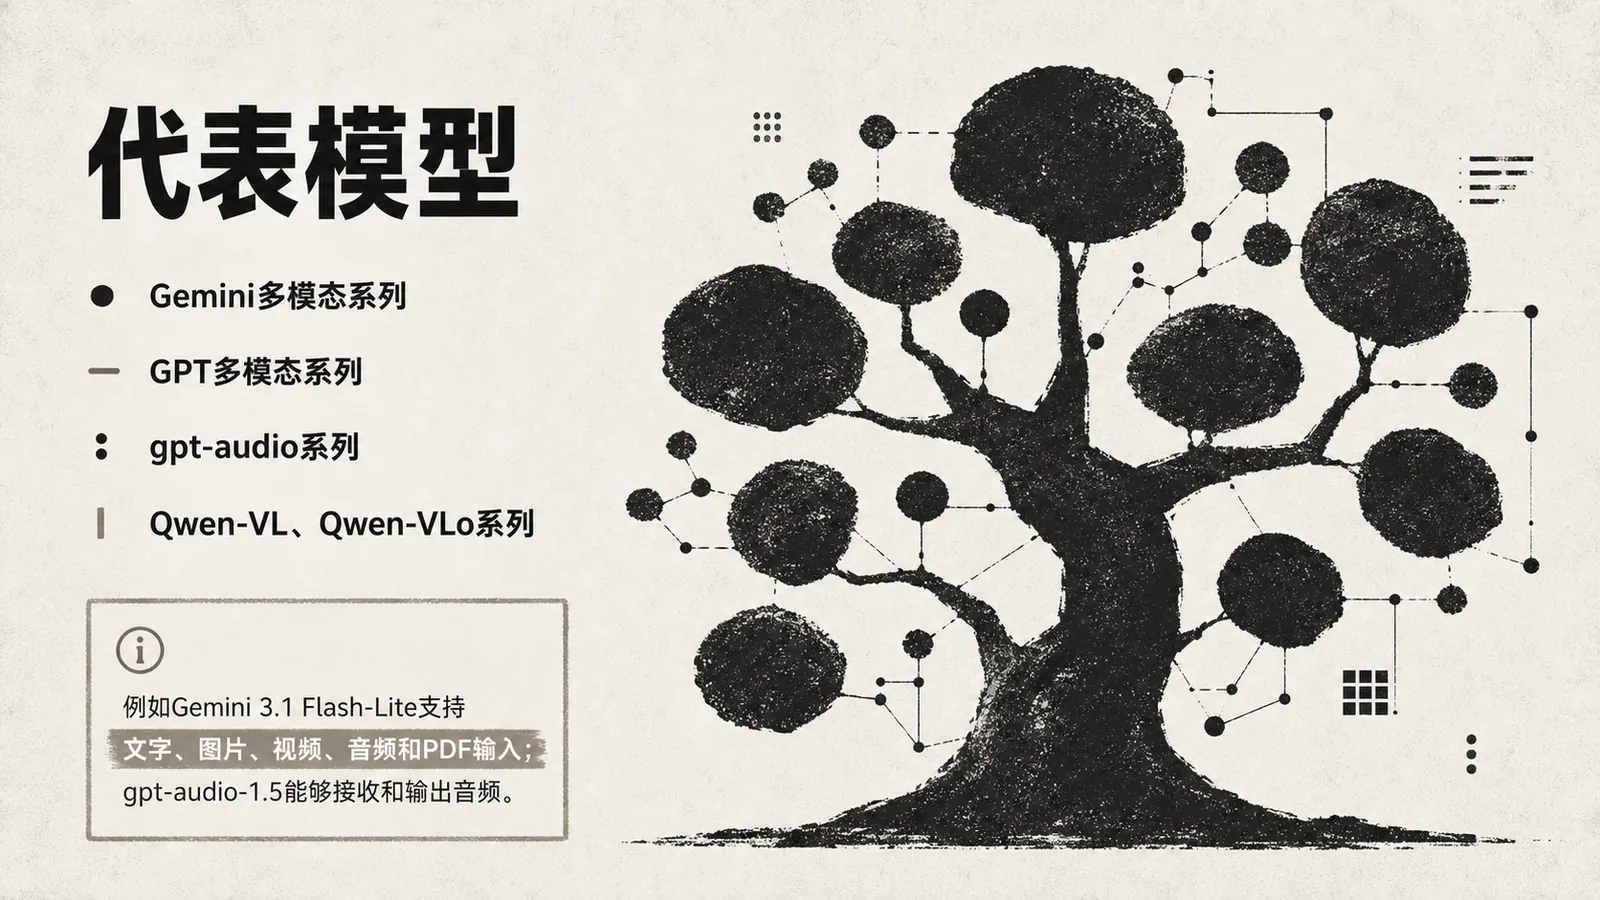
代表模型

图片展示了多模态模型的代表模型,包括Gemini多模态系列、GPT多模态系列、gpt - audio系列、Qwen - VL、Qwen - VLo系列。左侧以黑色文字标注模型系列,右侧以黑色树形图呈现模型结构。树干底部有信息框,标注Gemini 3. 1 Flash - Lite支持文字、图片、视频、音频和PDF输入;gpt - audio - 1. 5能够接收和输出音频。该图与上下文紧密相关,直观呈现了多模态模型的代表模型种类及部分模型功能。

  • Gemini多模态系列
  • GPT多模态系列
  • gpt-audio系列
  • Qwen-VL、Qwen-VLo系列

例如Gemini 3.1 Flash-Lite支持文字、图片、视频、音频和PDF输入;gpt-audio-1.5能够接收和输出音频。

举例
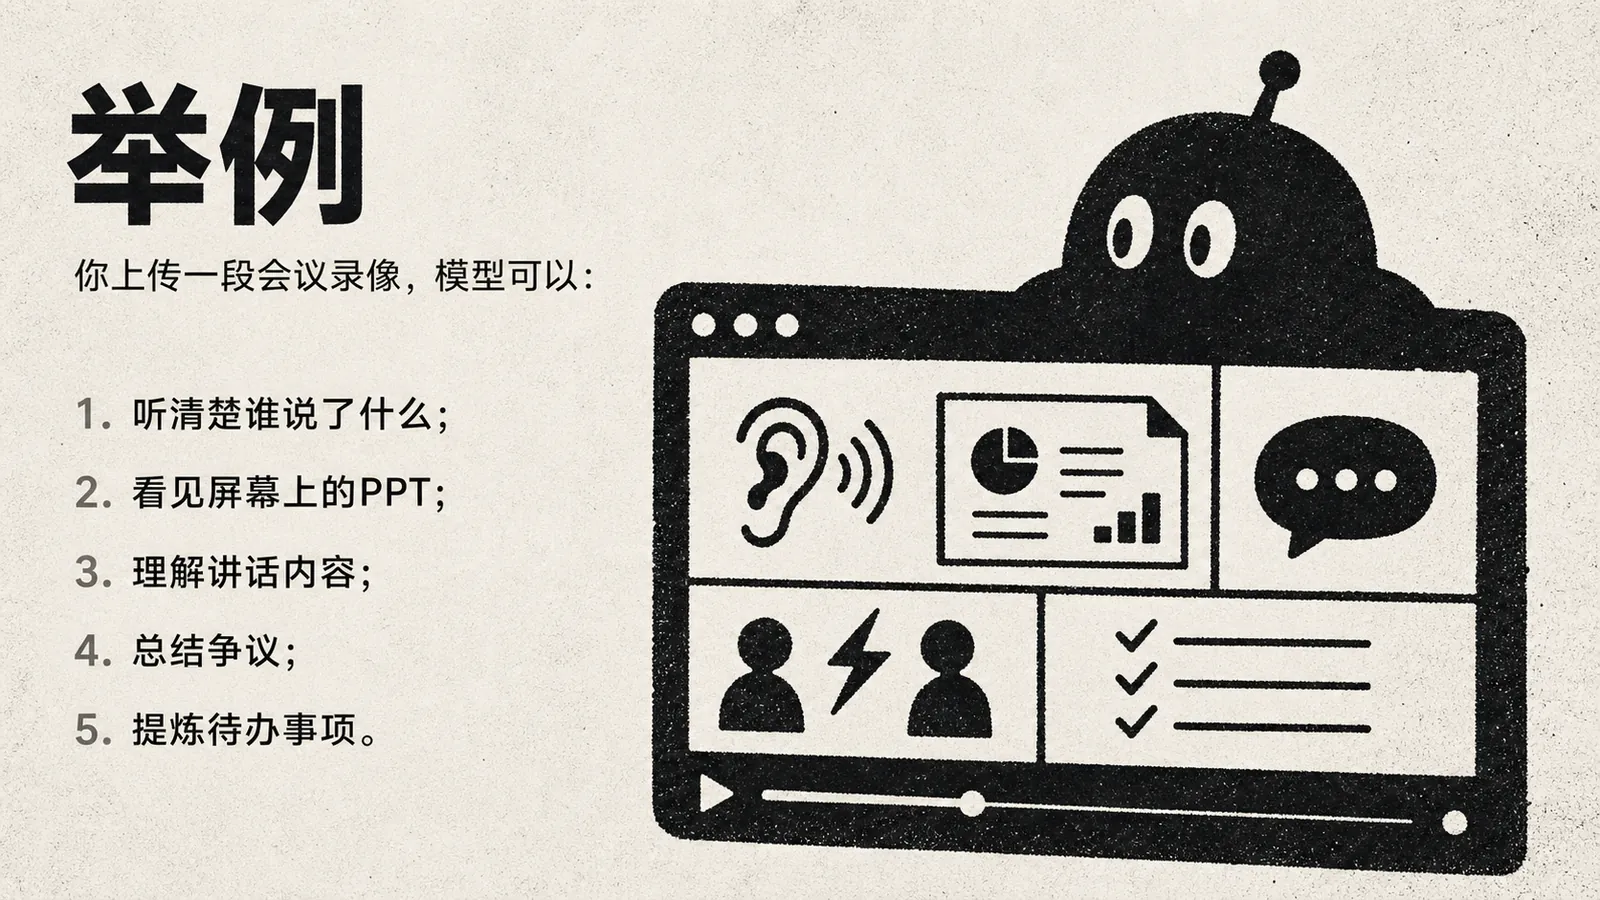
图片展示了多模态模型处理会议录像的能力举例。画面左侧文字说明上传会议录像,模型可做到听清楚谁说了什么、看见屏幕上的PPT、理解讲话内容、总结争议、提炼待办事项。右侧是一个带有机器人头像的屏幕,屏幕内有耳麦图标、PPT图表、对话框、人物头像、闪电符号及待办事项列表,直观呈现了模型处理会议录像的多种功能。

你上传一段会议录像,模型可以:

  1. 听清楚谁说了什么;
  2. 看见屏幕上的PPT;
  3. 理解讲话内容;
  4. 总结争议;
  5. 提炼待办事项。

通俗类比

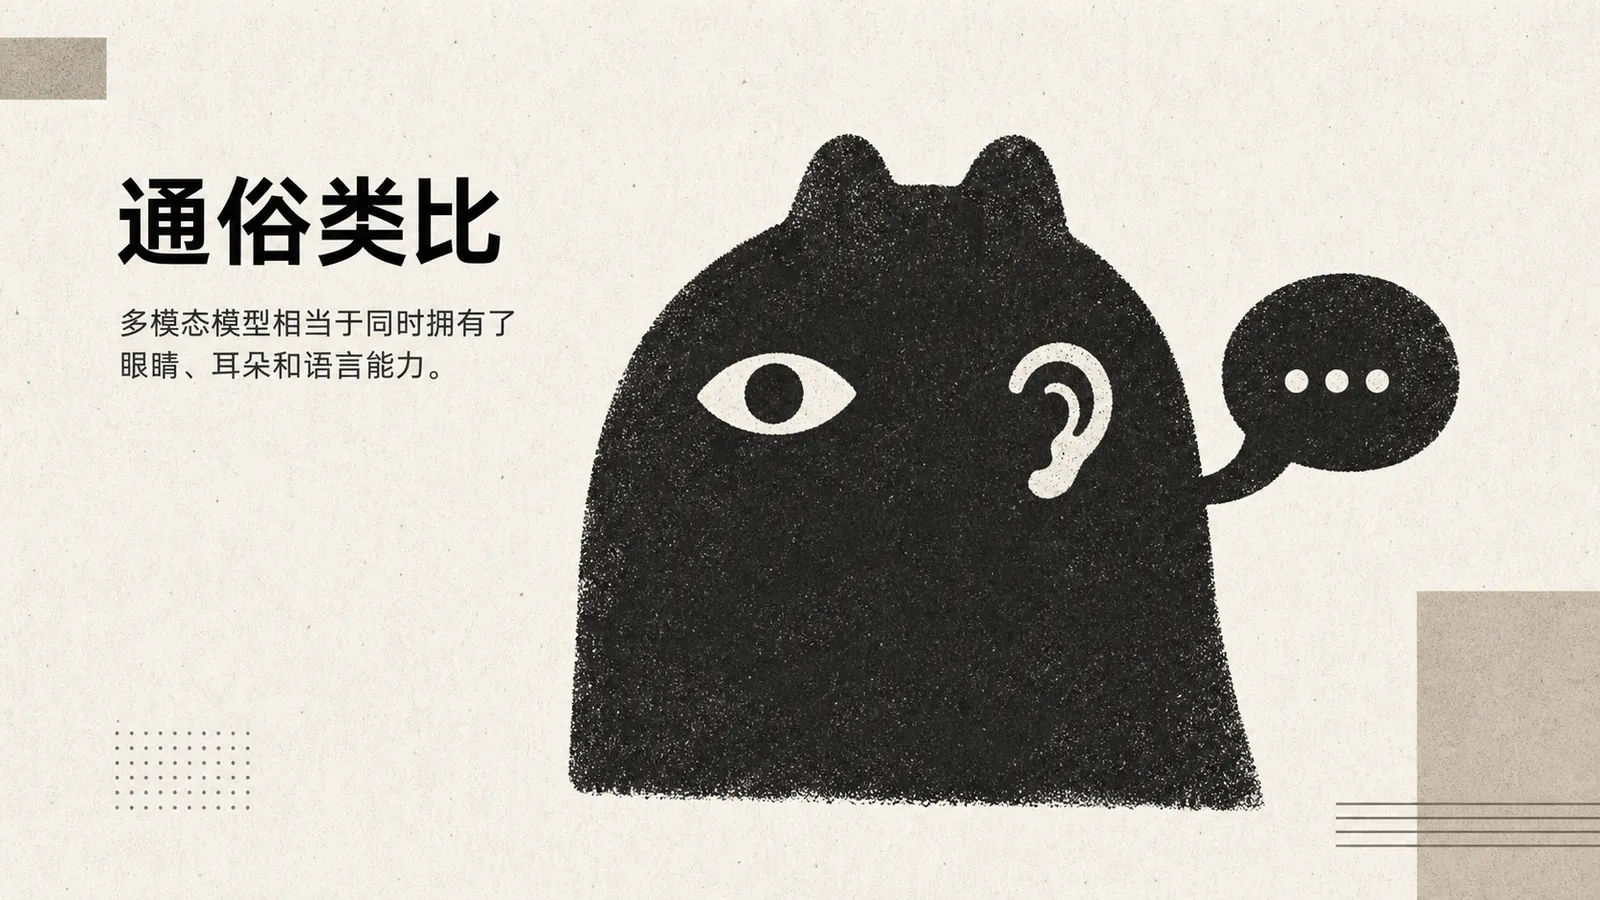
图片以卡通风格呈现,左侧上方有“通俗类比”标题及“多模态模型等于是同时拥有了眼睛、耳朵和语言能力”文字。右侧是一个黑色的卡通形象,其头部有猫耳,眼睛、耳朵和嘴巴分别以白色图案标识,嘴巴处有对话框。该图片与上下文紧密相关,上下文在介绍多模态模型时,将其类比为同时拥有眼睛、耳朵和语言能力,此图直观地用卡通形象展示了这一类比,帮助读者更清晰地理解多模态模型的功能。

多模态模型等于是同时拥有了眼睛、耳朵和语言能力。


05 代码模型:负责理解、生成和修改代码
图片以代码符号“< >”为背景,左侧文字说明“代码模型:负责理解、生成和修改代码”。该图片位于介绍代码模型功能的上下文部分,与上文提到的代码模型负责理解、生成和修改代码的内容相呼应,直观呈现了代码模型的工作职责,帮助读者更清晰地理解代码模型在AI模型家族中的角色。

代表模型

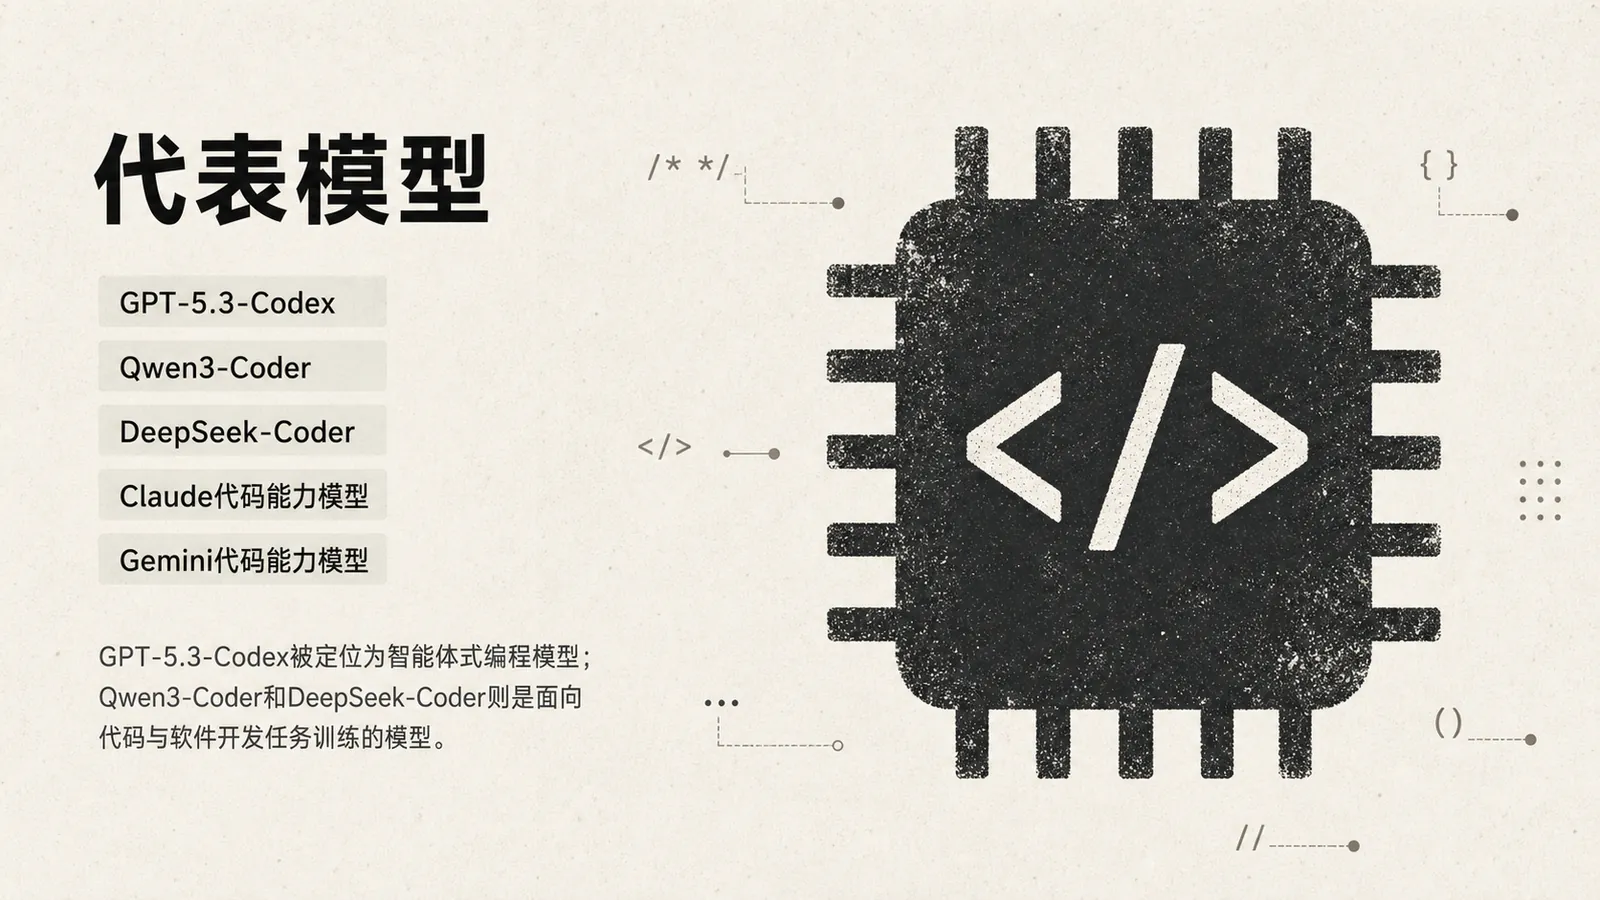
图片展示了代码模型的代表模型,包括GPT-5.3-Codex、Qwen3-Coder、DeepSeek-Coder、Claude代码能力模型、Gemini代码能力模型。左侧文字说明GPT-5.3-Codex被定位为智能体式编程模型,Qwen3-Coder和DeepSeek-Coder则是面向代码与软件开发任务训练的模型。右侧是一张带有代码符号“<”“>”的芯片插画,芯片上有代码相关符号,如“/* */”“{}”“()”“//”等,与代码模型主题相呼应。

  • GPT-5.3-Codex
  • Qwen3-Coder
  • DeepSeek-Coder
  • Claude代码能力模型
  • Gemini代码能力模型

GPT-5.3-Codex被定位为智能体式编程模型;Qwen3-Coder和DeepSeek-Coder则是面向代码与软件开发任务训练的模型。

举例
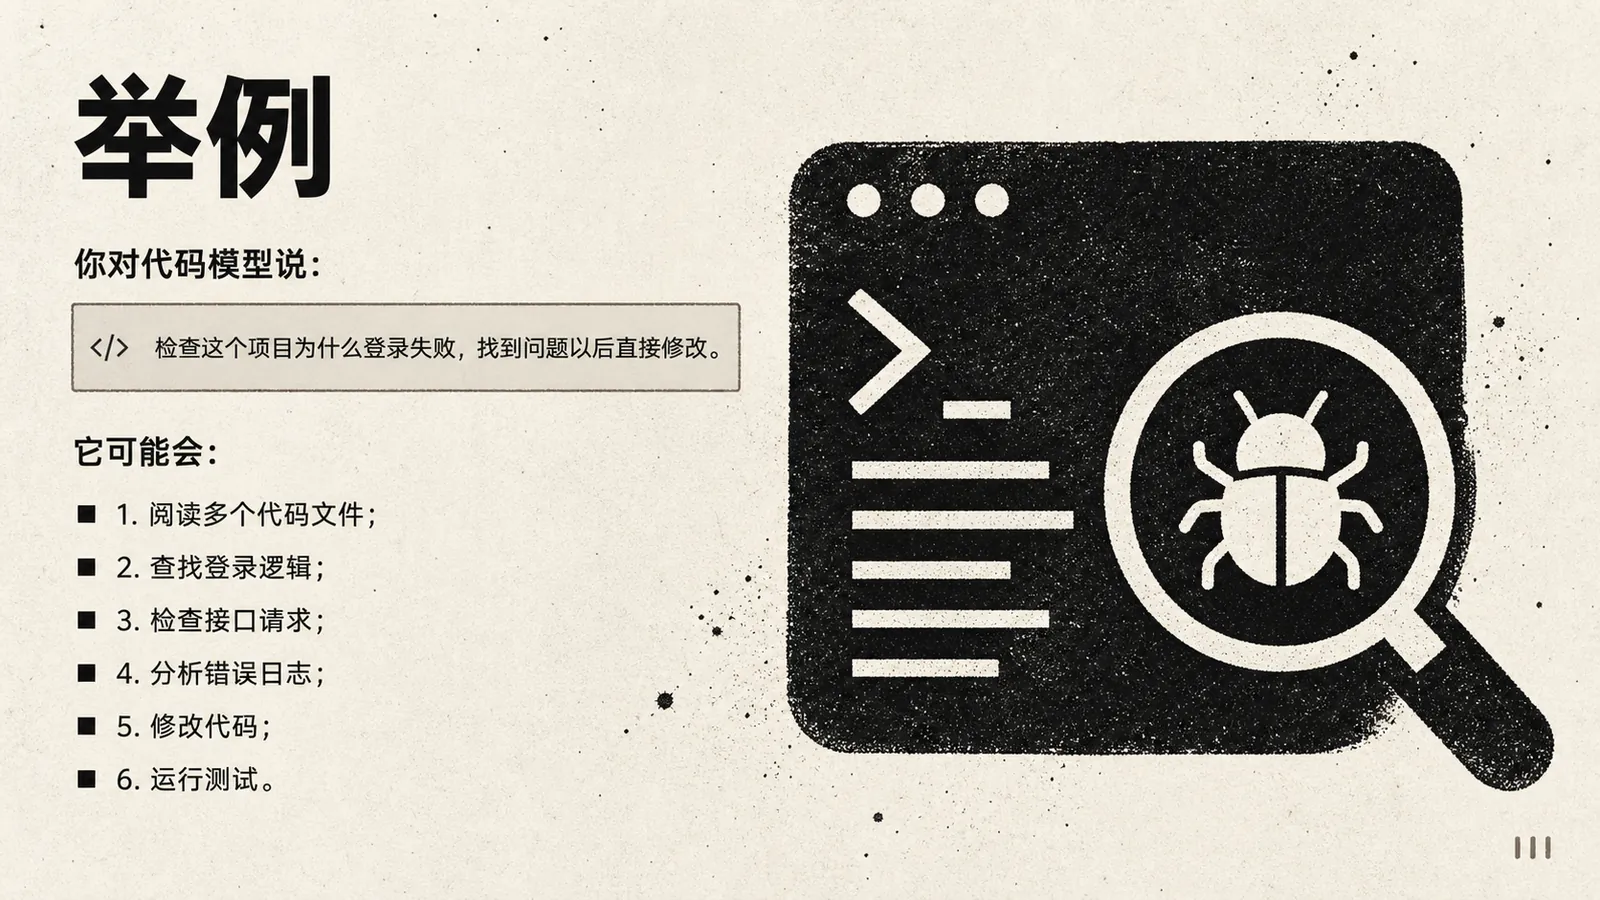
图片以“举例”为标题,展示了一段代码模型指令“检查这个项目为什么登录失败,找到问题以后直接修改”,并列出其可能采取的步骤:阅读多个代码文件、查找登录逻辑、检查接口请求、分析错误日志、修改代码、运行测试。右侧配有代码界面、放大镜和带有“bug”标识的图标,直观呈现代码模型在代码问题排查中的操作。该图片与上文介绍代码模型负责理解、生成和修改代码,以及举例说明其如何处理代码问题等内容紧密相关。

你对代码模型说:

检查这个项目为什么登录失败,找到问题以后直接修改。

它可能会:

  • 阅读多个代码文件;
  • 查找登录逻辑;
  • 检查接口请求;
  • 分析错误日志;
  • 修改代码;
  • 运行测试。

通俗类比

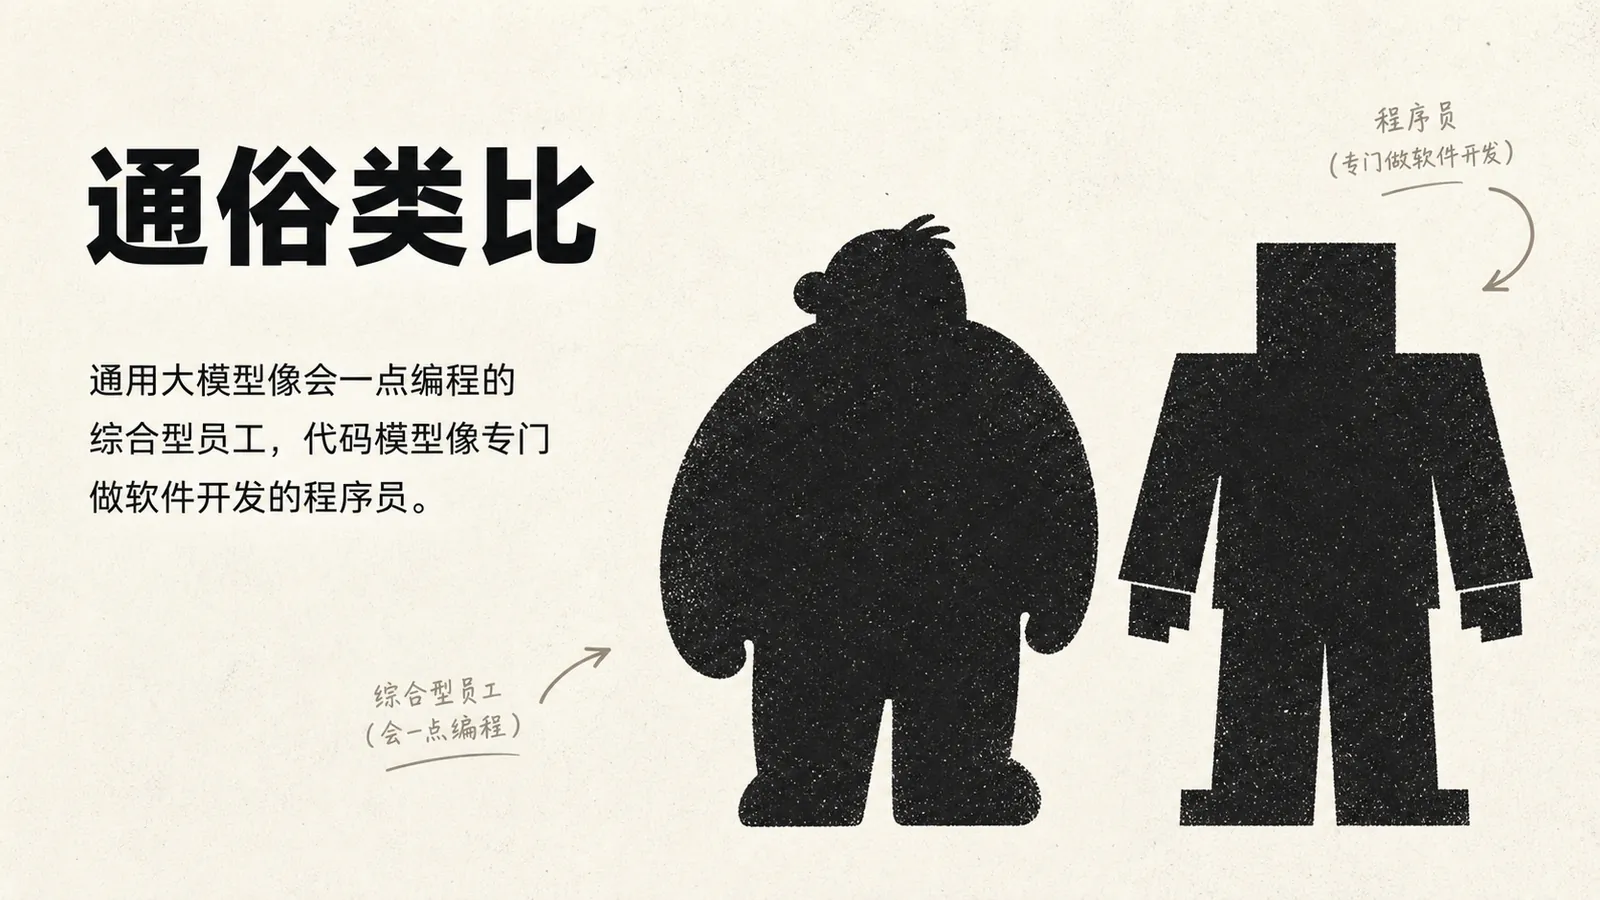
图片以“通俗类比”为标题,将通用大模型比作会一点编程的综合型员工,代码模型比作专门做软件开发的程序员。画面左侧是一个体型较大的卡通人物,标注“综合型员工(会一点编程)”,右侧是一个体型较小的方块人物,标注“程序员(专门做软件开发)”。该图片与上下文紧密相关,通过形象对比,直观呈现了通用大模型与代码模型在能力上的差异,帮助读者更好地理解二者在AI模型家族中的定位。

通用大模型像会一点编程的综合型员工,代码模型像专门做软件开发的程序员。


06 目标检测模型:负责找到画面里的物体
图片以“06目标检测模型:负责找到画面里的物体”为标题,左侧有数字“06”及“目标检测模型”字样。右侧是一个黑色的放大镜图标,周围有多个白色方框和线条。该图片与文档中介绍目标检测模型的内容相关,直观呈现了目标检测模型的功能,即负责找到画面里的物体,与上下文对目标检测模型的描述相呼应。

代表模型

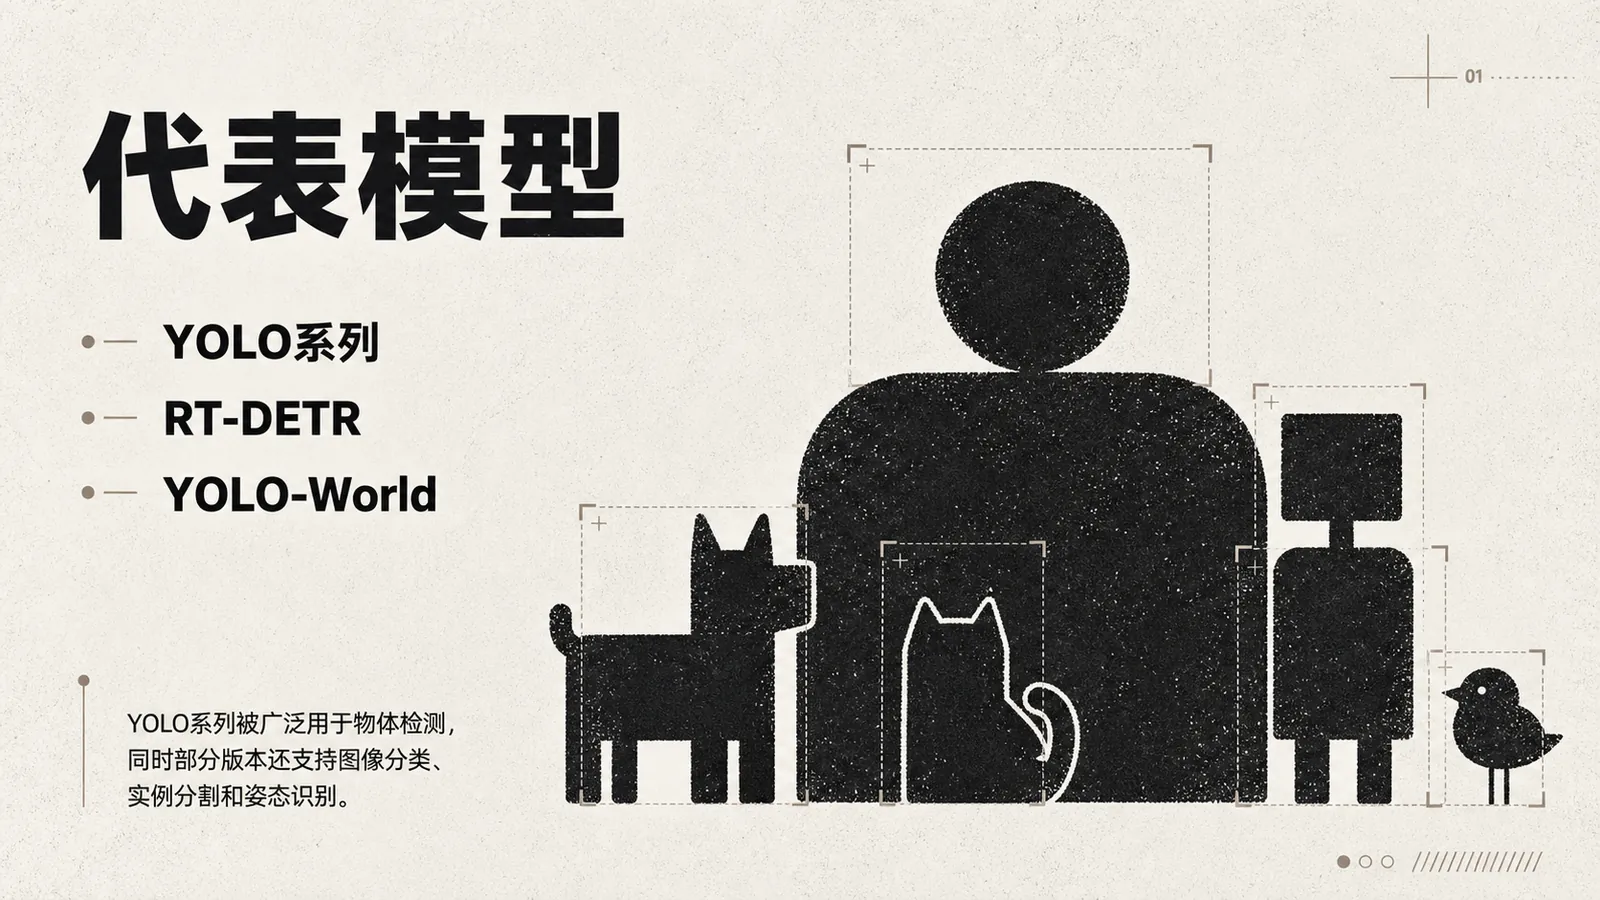
这张图是目标检测模型的代表模型相关内容,对应文档中目标检测模型的介绍板块。图中列出了该领域的主流代表模型,分别是YOLO系列、RT-DETR、YOLO-World,左侧还标注了YOLO系列的应用范围,即被广泛用于物体检测,部分版本还支持图像分类、实例分割和姿态识别。图的右侧以拟人化的图形示例,呈现了目标检测模型的工作效果,即能识别出画面里的人、猫、狗、机器人、鸟这些物体,还能确定它们的位置。

  • YOLO系列
  • RT-DETR
  • YOLO-World

YOLO系列被广泛用于物体检测,同时部分版本还支持图像分类、实例分割和姿态识别。

举例
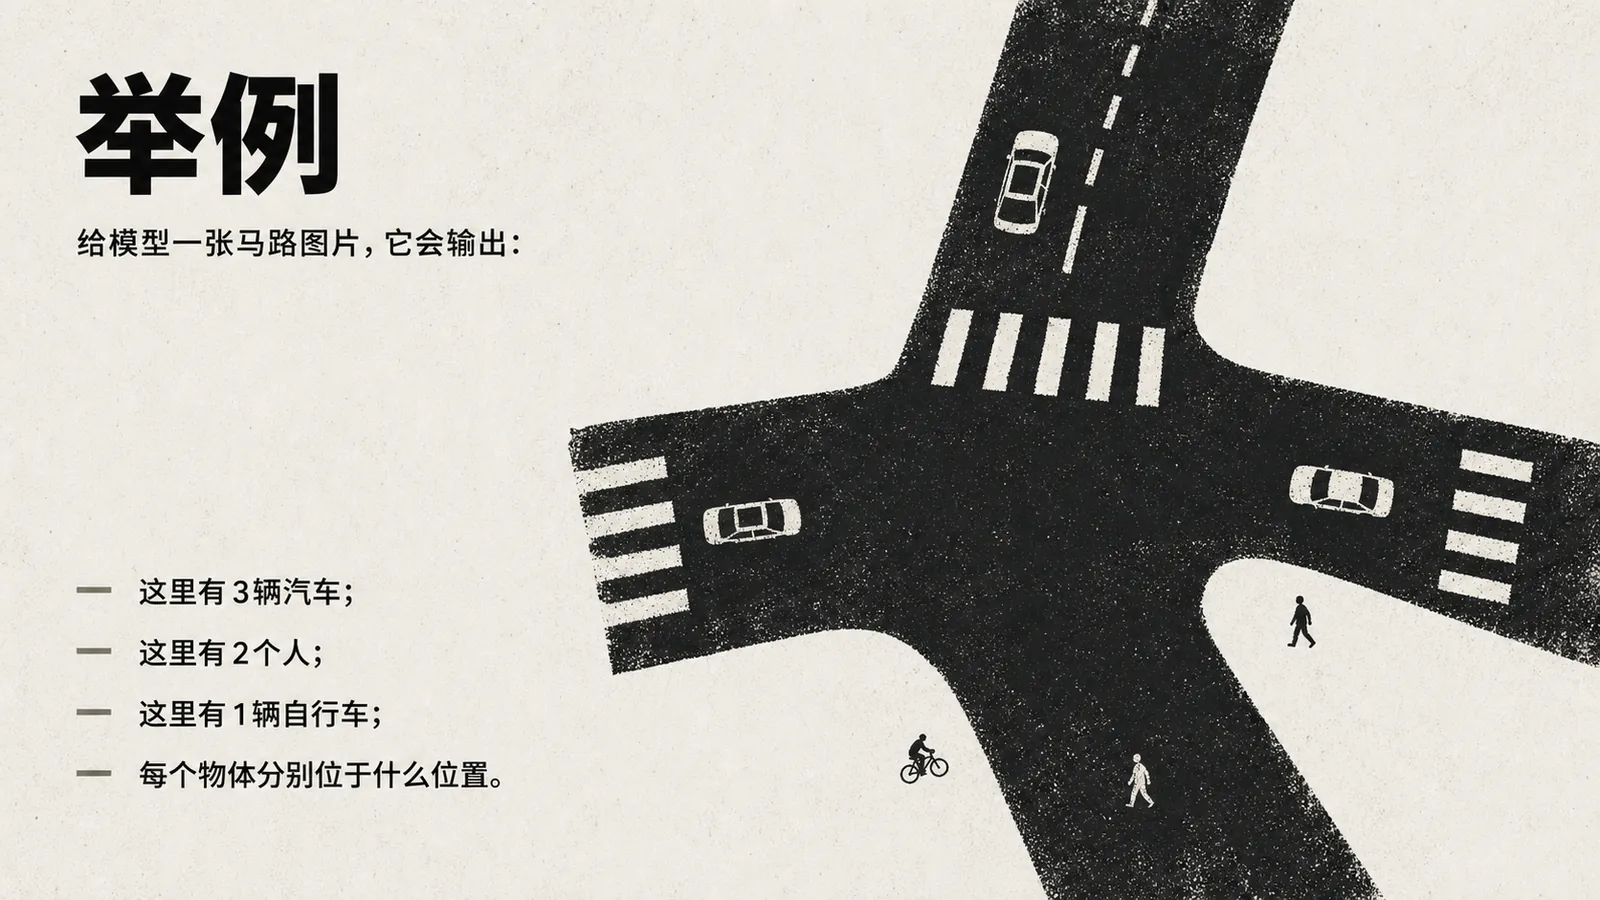
图片展示了一张马路图片,用于说明目标检测模型的功能。图片中有3辆汽车、2个人和1辆自行车。上方文字说明给模型一张马路图片,它会输出:这里有3辆汽车;这里有2个人;这里有1辆自行车;每个物体分别位于什么位置。该图片与上下文紧密相关,直观呈现了目标检测模型能识别并描述图片中物体数量及位置的特点。

给模型一张马路图片,它会输出:

  • 这里有3辆汽车;
  • 这里有2个人;
  • 这里有1辆自行车;
  • 每个物体分别位于什么位置。

通俗类比

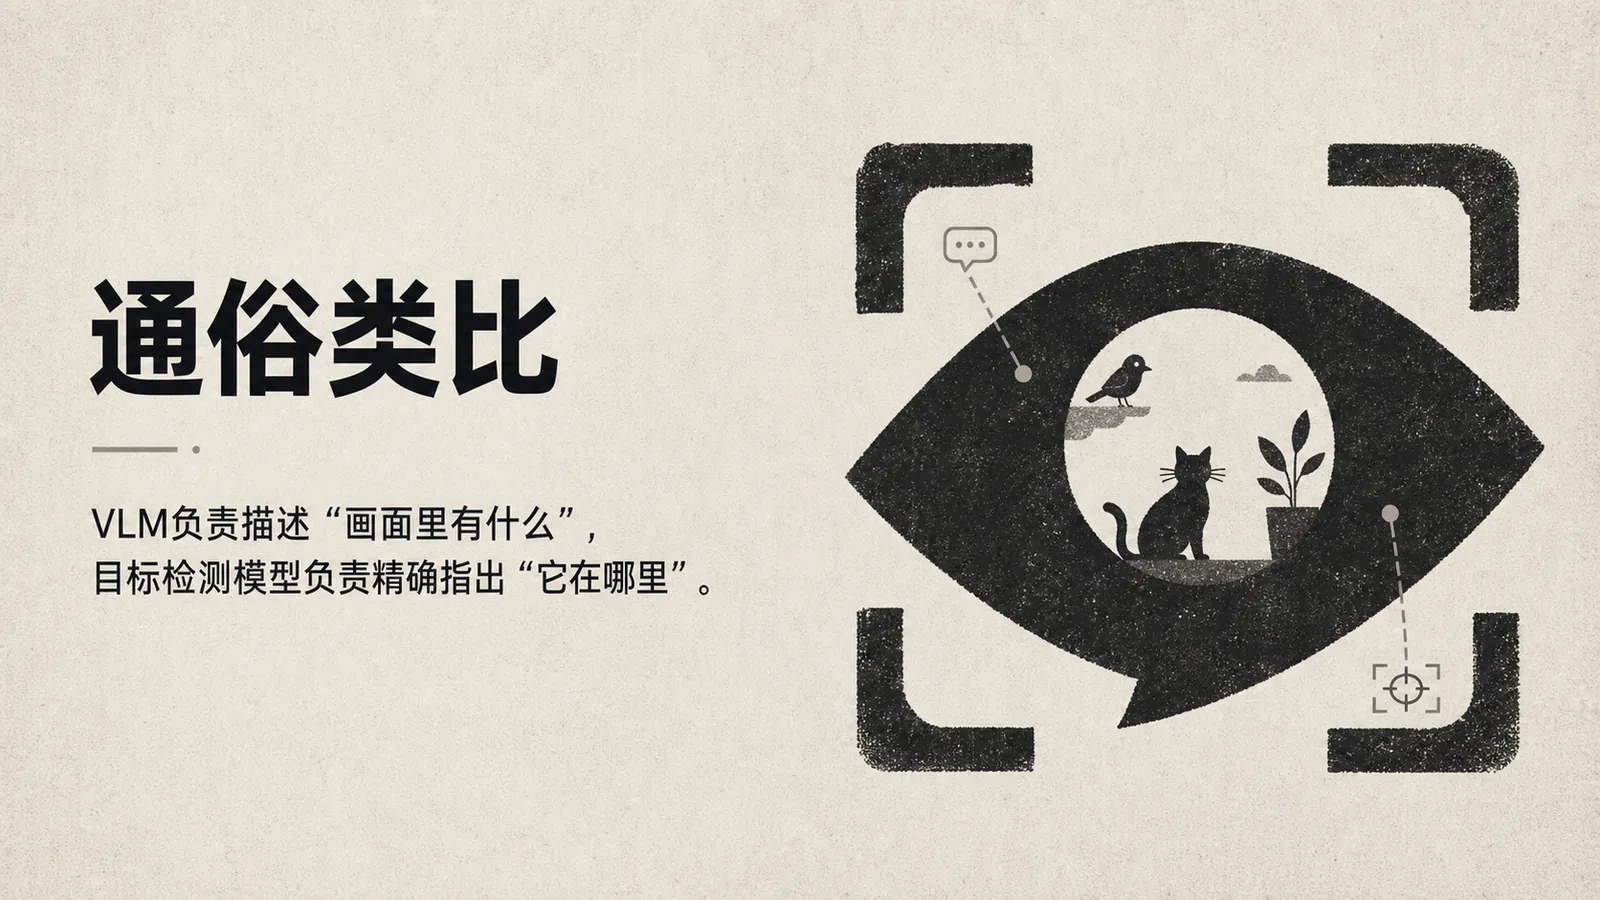
图片以“通俗类比”为标题,左侧文字说明VLM负责描述“画面里有什么”,目标检测模型负责精确指出“它在哪里”。右侧是一只眼睛的图案,画面中有一只猫、一只鸟和一株植物,鸟在说话,猫在看植物。该图片与上下文紧密相关,通过类比的方式,直观呈现VLM和目标检测模型在图像识别任务中的不同功能,帮助理解它们在AI模型家族中的作用。

VLM负责描述“画面里有什么”,目标检测模型负责精确指出“它在哪里”。


07 图像分割模型:负责把物体精确抠出来
图片展示了一张人物剪影,背景为浅色,人物轮廓以黑色呈现。左侧文字标注“07图像分割模型:负责把物体精确抠出来”。该图片位于介绍图像分割模型的文档中,与上下文紧密相关,直观呈现了图像分割模型的核心功能,即通过模型将图片中的物体精确抠出来,与上下文提到的图像分割模型负责把物体精确抠出来相呼应,帮助读者更清晰地理解这一概念。

代表模型

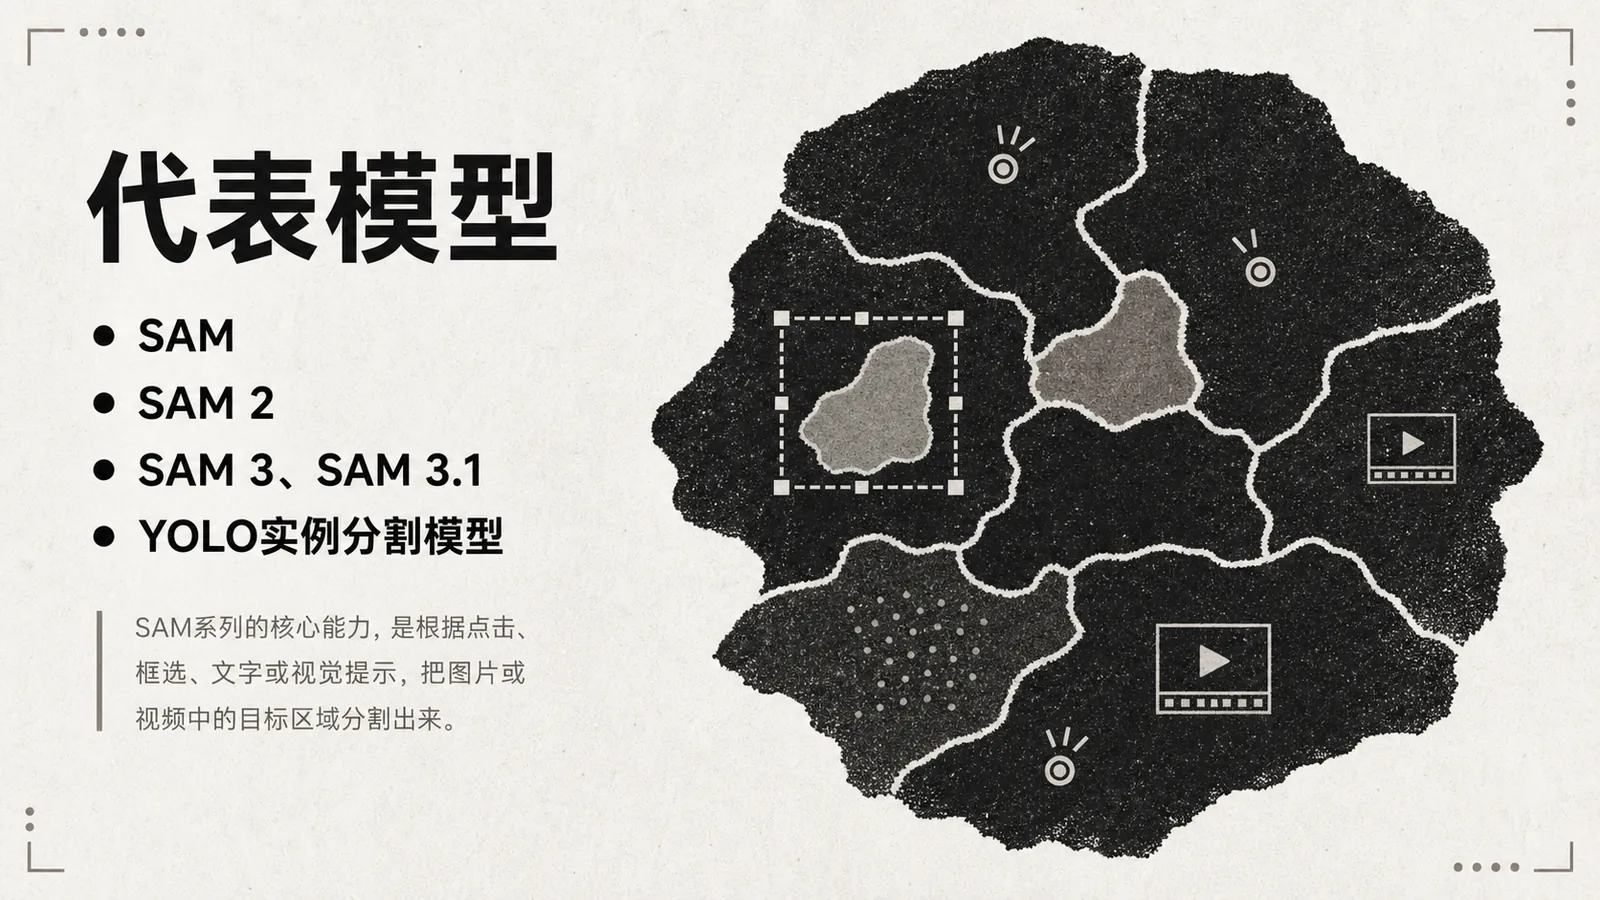
这张图是介绍图像分割模型代表模型的内容,左侧列出了图像分割领域的代表模型,分别为SAM、SAM 2、SAM 3与SAM 3.1,以及YOLO实例分割模型,同时还标注了SAM系列模型的核心能力:可根据点击、框选、文字或视觉提示,将图片或视频中的目标区域分割出来。右侧是一幅示意图像,以不同色块表现分割出的不同区域,其中一个区域被虚线框标注,另有多个带播放标识、点组的不同色块,直观体现出图像分割模型对目标区域的识别与分割效果。

  • SAM
  • SAM 2
  • SAM 3、SAM 3.1
  • YOLO实例分割模型

SAM系列的核心能力,是根据点击、框选、文字或视觉提示,把图片或视频中的目标区域分割出来。

举例
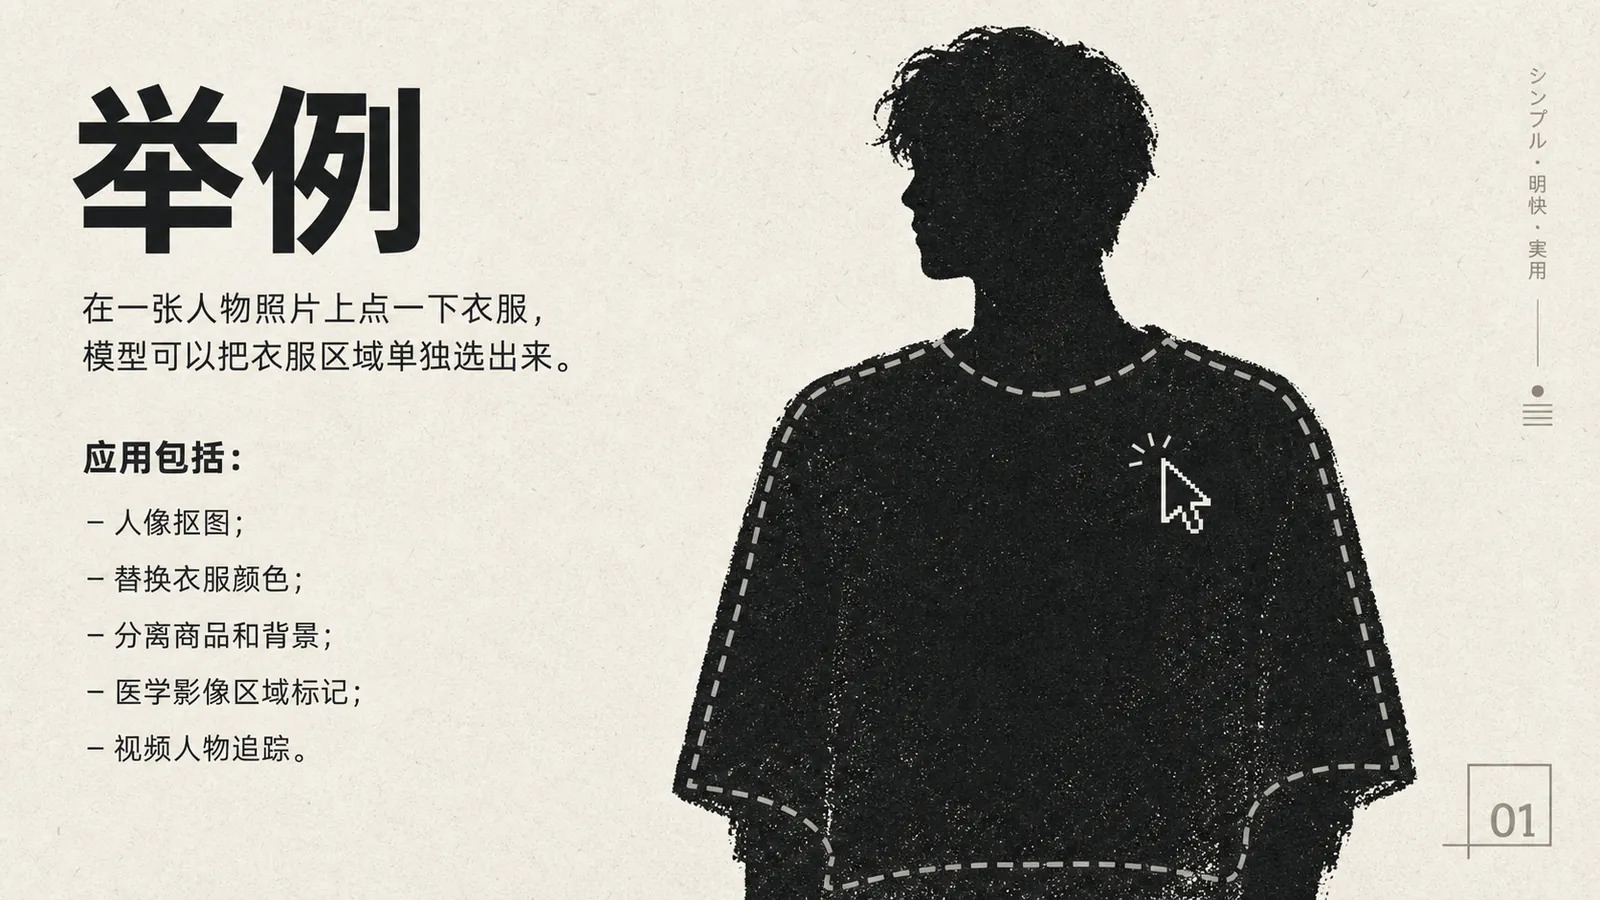
图片展示了图像分割模型的举例内容。画面中是一位侧身站立的男性,背景为黑色,男性轮廓以白色虚线勾勒。左侧文字说明在一张人物照片上点一下衣服,模型可以把衣服区域单独选出来。下方列出应用包括人像抠图、替换衣服颜色、分离商品和背景、医学影像区域标记、视频人物追踪等。该图片与上下文紧密相关,直观呈现了图像分割模型的应用场景,帮助理解其核心能力。

在一张人物照片上点一下衣服,模型可以把衣服区域单独选出来。

应用包括:

  • 人像抠图;
  • 替换衣服颜色;
  • 分离商品和背景;
  • 医学影像区域标记;
  • 视频人物追踪。

通俗类比

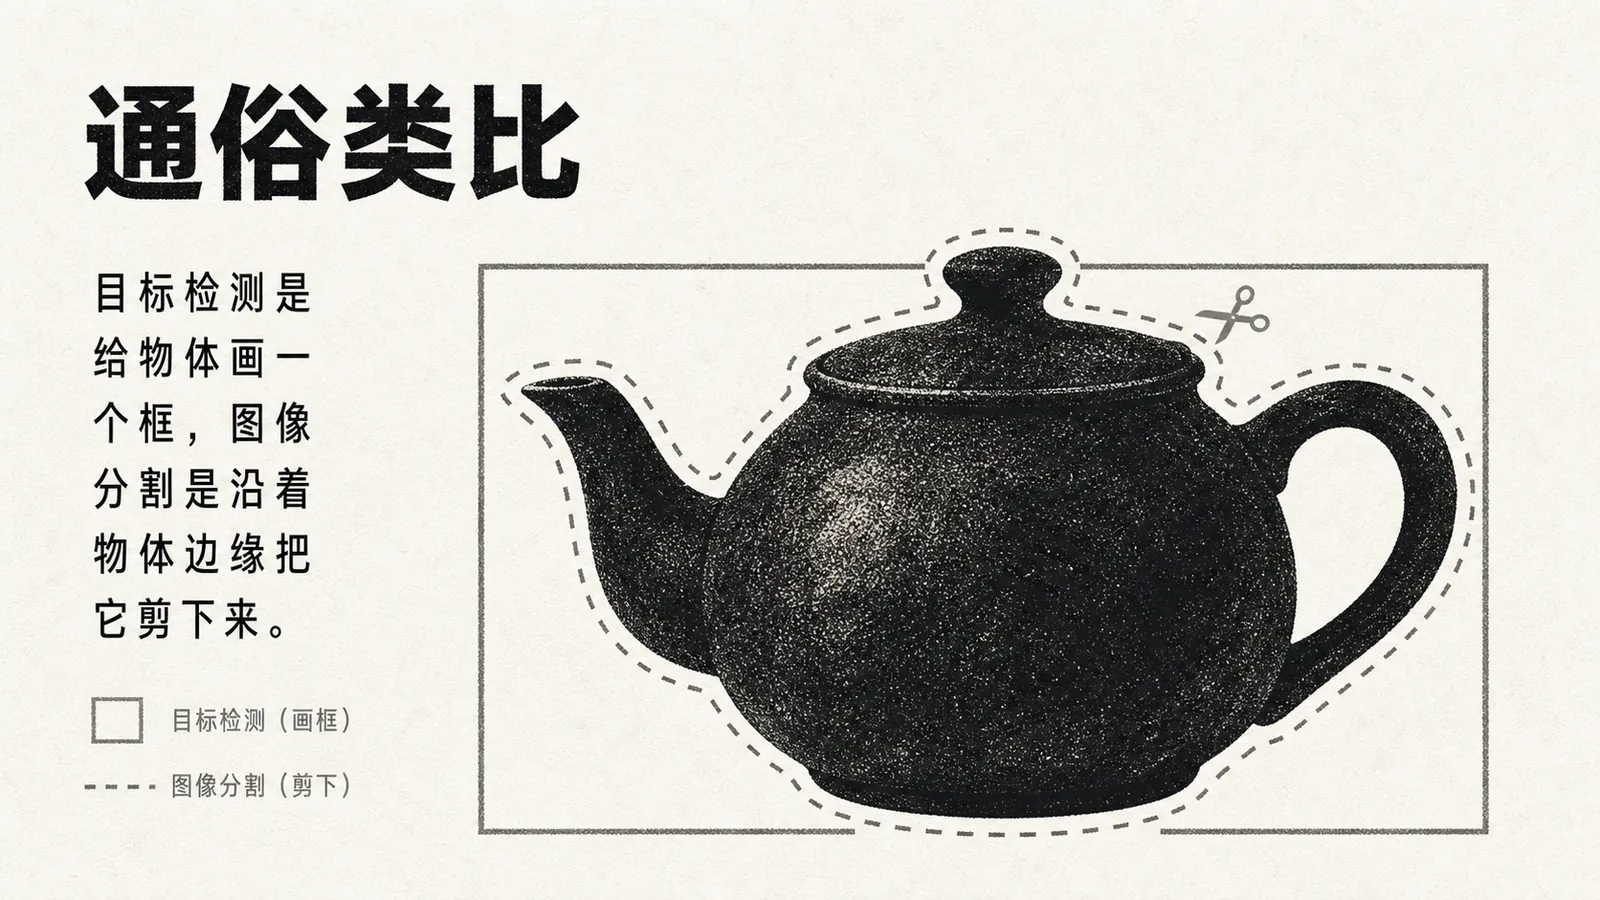
图片以“通俗类比”为标题,通过一张茶壶的黑白插画,直观展示目标检测和图像分割的概念。左侧文字说明目标检测是给物体画一个框,图像分割是沿着物体边缘把它剪下来。右侧茶壶图中,茶壶轮廓用虚线框出,代表目标检测;茶壶被虚线剪开,代表图像分割。此图与上下文紧密相关,通过类比方式,帮助读者更清晰地理解目标检测和图像分割在图像处理中的不同操作方式。

目标检测是给物体画一个框,图像分割是沿着物体边缘把它剪下来。


08 OCR和文档模型:负责阅读图片和文件
图片以“08 OCR和文档模型:负责阅读图片和文件”为标题,左侧文字介绍OCR和文档模型功能,右侧是一张带有像素化眼睛图案的文件图标,图标背景为黑色,文件图标边缘有白色边框。该图片与上下文紧密相关,上下文介绍了OCR和文档模型负责阅读图片和文件,图片通过视觉元素直观呈现了这一功能,使概念更加形象易懂。

代表模型

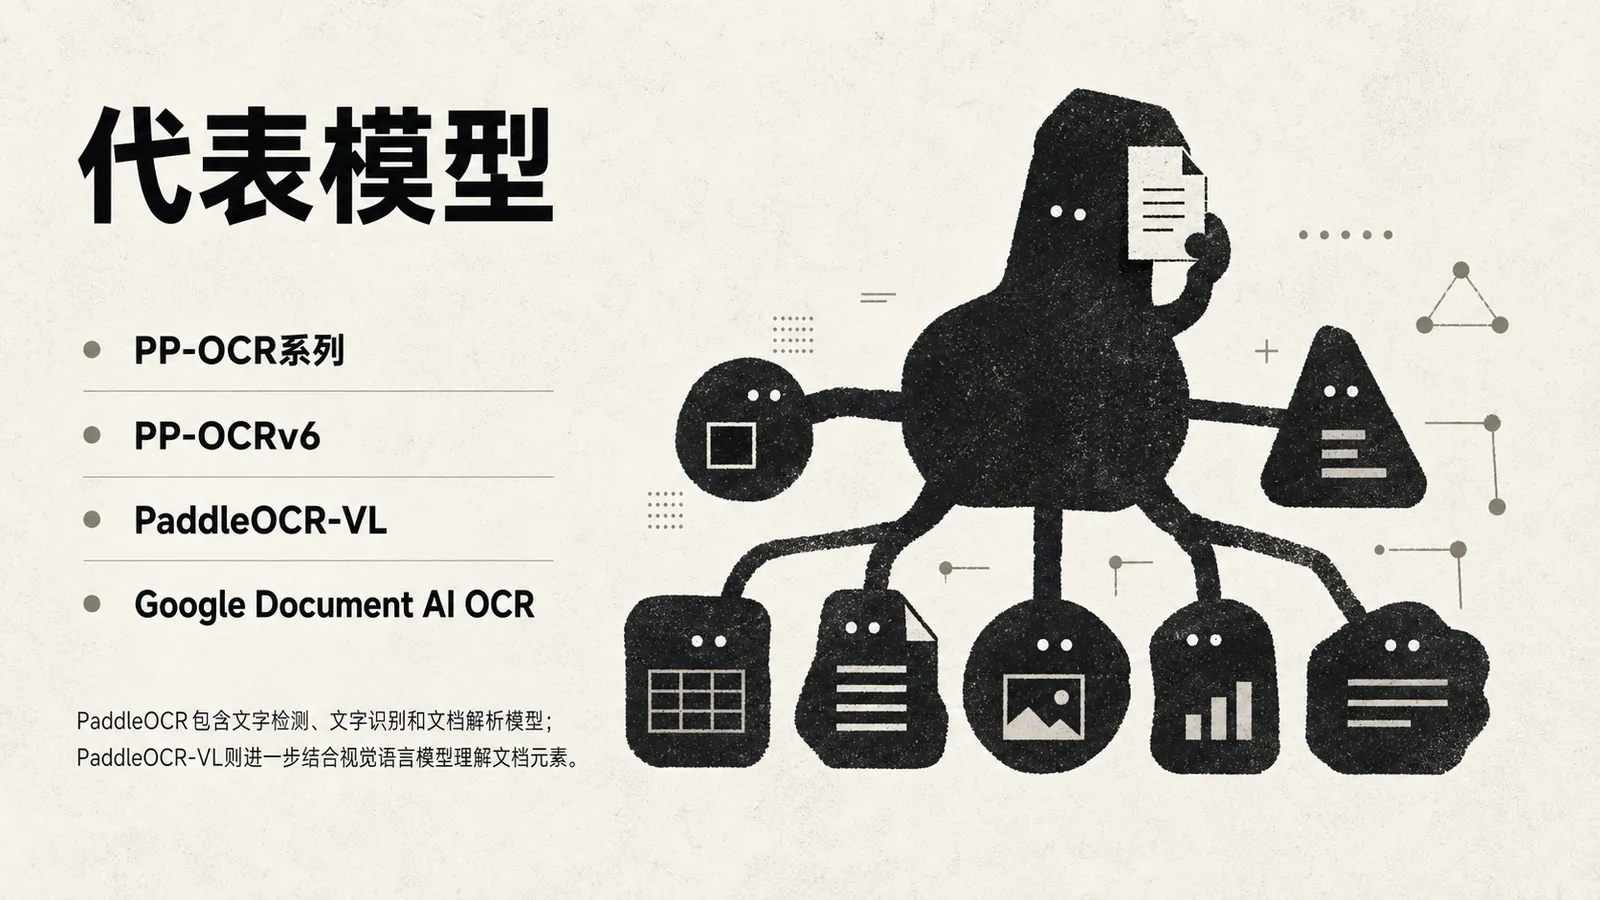
图片展示了OCR和文档模型的代表模型,包括PP-OCR系列、PP-OCRv6、PaddleOCR-VL、Google Document AI OCR。这些模型以一个拟人化机器人形象呈现,机器人手持文件,身体连接着多个图标,分别代表文字、表格、图片、图表、文档等元素。下方文字说明PaddleOCR包含文字检测、文字识别和文档解析模型,PaddleOCR-VL则进一步结合视觉语言模型理解文档元素。此图与文档中介绍OCR和文档模型的内容相呼应,直观呈现了相关模型的类型和功能。

  • PP-OCR系列
  • PP-OCRv6
  • PaddleOCR-VL
  • Google Document AI OCR

PaddleOCR包含文字检测、文字识别和文档解析模型;PaddleOCR-VL则进一步结合视觉语言模型理解文档元素。

举例
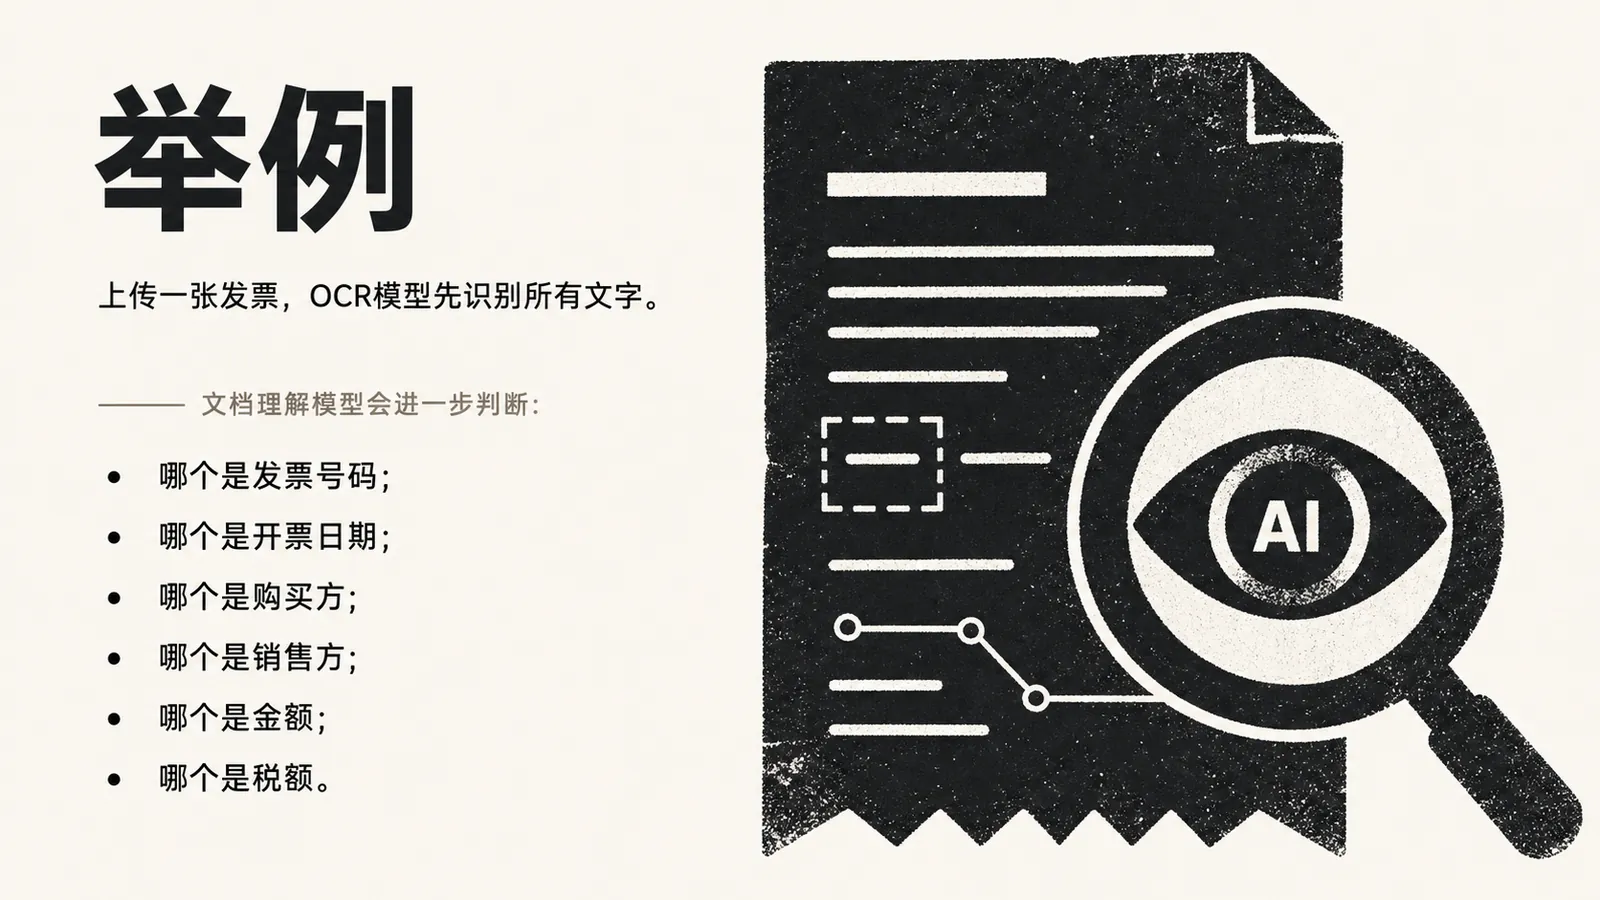
图片展示了OCR模型识别发票文字及文档理解模型进一步判断发票信息的示例。左侧文字说明上传发票后OCR模型先识别所有文字,右侧是一张发票的黑白插画,发票上用虚线框标出发票号码、开票日期、购买方、销售方、金额、税额等区域。右侧还配有放大镜图标,内有“AI”字样。该图与上下文紧密相关,直观呈现了OCR模型和文档理解模型在发票处理中的作用。

上传一张发票,OCR模型先识别所有文字。

文档理解模型会进一步判断:

  • 哪个是发票号码;
  • 哪个是开票日期;
  • 哪个是购买方;
  • 哪个是销售方;
  • 哪个是金额;
  • 哪个是税额。

通俗类比

图片以“通俗类比”为标题,左侧是一本打开的书,书页上有文字,右侧是一个放大镜,正对着书页。右侧文字说明OCR是把字抄下来,文档理解模型是理解这些字分别代表什么。该图片与上下文紧密相关,上下文在介绍OCR和文档理解模型,OCR是把字抄下来,而文档理解模型则是理解这些字分别代表什么,此图形象地展示了这一概念,直观呈现了OCR和文档理解模型的工作方式。

OCR是把字抄下来,文档理解模型是理解这些字分别代表什么。


09 图像生成模型:负责画图和改图
图片以“09图像生成模型:负责画图和改图”为标题,展示了图像生成模型的功能。画面中,左侧有代表图片的图标,中间是加号和调色板图标,右侧是带有画笔的电脑屏幕,屏幕上有山峰图案。这与文档中介绍图像生成模型负责画图和改图的内容相契合,直观呈现了其功能,辅助说明图像生成模型在图像生成和编辑方面的应用。

代表模型

图片展示了图像生成模型的代表模型,包括GPT Image 2、FLUX.2、FLUX.1 Kontext、DALL·E 3、Stable Diffusion系列。这些模型被以类似神经网络的结构呈现,由多个节点组成,节点间有箭头连接,形成网络。图片与上下文紧密相关,上下文介绍了这些模型的功能,如GPT Image 2支持文字生成图片和图片编辑;FLUX.2则支持文生图、多参考图和图像编辑等任务,直观呈现了模型间的联系与功能。

  • GPT Image 2
  • FLUX.2
  • FLUX.1 Kontext
  • DALL·E 3
  • Stable Diffusion系列

GPT Image 2支持文字生成图片和图片编辑;FLUX.2则支持文生图、多参考图和图像编辑等任务。

举例
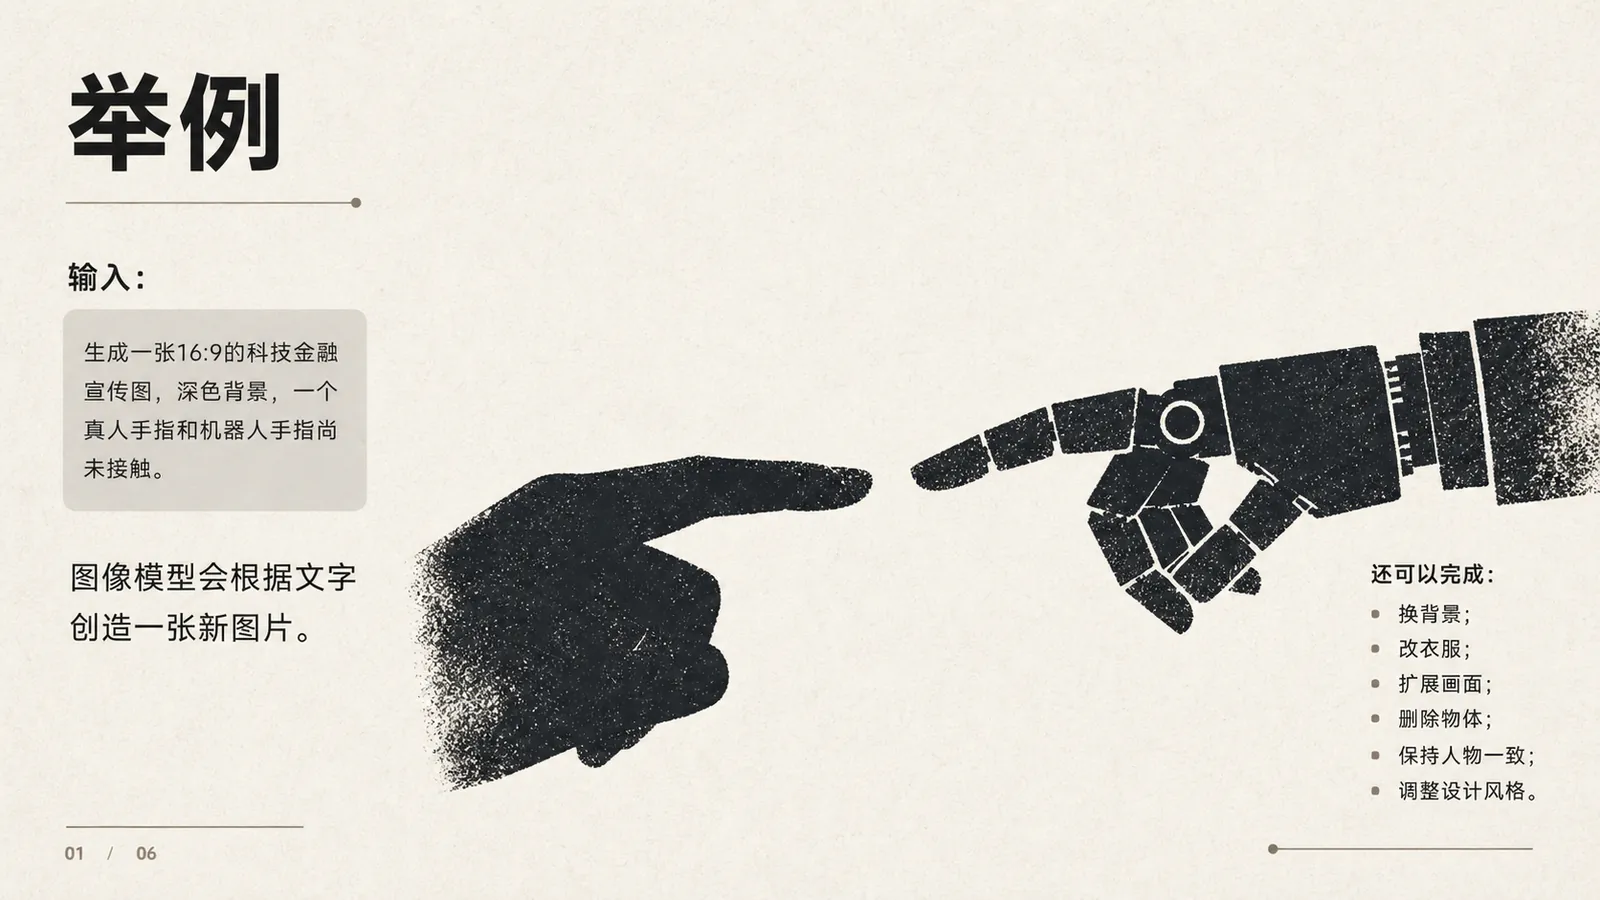
图片展示了一张科技金融宣传图的示例,背景为深色,左侧是真人手指,右侧是机器人手指,两者尚未接触。图片左上角有“举例”标题,下方是输入内容,要求生成一张16:9的科技金融宣传图,深色背景,一个真人手指和机器人手指尚未接触。右下角列出了图像模型可完成的任务,包括换背景、改衣服、扩展画面、删除物体、保持人物一致、调整设计风格等。该图片与上下文介绍图像生成模型的功能相呼应,直观呈现了模型的创作能力。

输入:

生成一张16:9的科技金融宣传图,深色背景,一个真人手指和机器人手指尚未接触。

图像模型会根据文字创造一张新图片。

还可以完成:

  • 换背景;
  • 改衣服;
  • 扩展画面;
  • 删除物体;
  • 保持人物一致;
  • 调整设计风格。

通俗类比

图片以“通俗类比”为标题,左侧是一位戴眼镜、手持画笔的剪影人物,右侧配有文字说明。文字指出VLM是美术评论员,图像生成模型是画师。该图片与上下文紧密相关,通过将VLM比作美术评论员,将图像生成模型比作画师,形象地解释了图像生成模型在AI模型家族中的职责,即负责画图和改图,与上下文对图像生成模型功能的介绍相呼应。

VLM是美术评论员,图像生成模型是画师。


10 视频生成模型:负责让画面动起来
图片以淡灰色背景呈现,左侧黑色文字写着“10 视频生成模型:负责让画面动起来”。右侧是一个黑色的播放图标,图标右侧有黑色的线条向外延伸。该图片位于介绍视频生成模型的上下文部分,视频生成模型是AI模型家族中负责让画面动起来的成员,图片通过播放图标和线条等元素,直观地传达了视频生成模型的功能,与上下文内容紧密相关。

代表模型

图片以黑色相机造型为主,标注了“代表模型”及Sora系列、Runway Gen - 4.5、Google Veo系列、可灵视频模型、万相视频模型等五个视频生成模型名称。右侧有文字说明,Sora 2可根据文字或图片生成带声音的视频;Runway Gen - 4.5支持文生视频和图生视频,并能理解摄影机运动和连续动作。该图与上下文介绍视频生成模型的内容相呼应,直观呈现了视频生成模型的代表模型。

  • Sora系列
  • Runway Gen-4.5
  • Google Veo系列
  • 可灵视频模型
  • 万相视频模型

Sora 2可根据文字或图片生成带声音的视频;Runway Gen-4.5支持文生视频和图生视频,并能理解摄影机运动和连续动作。

举例
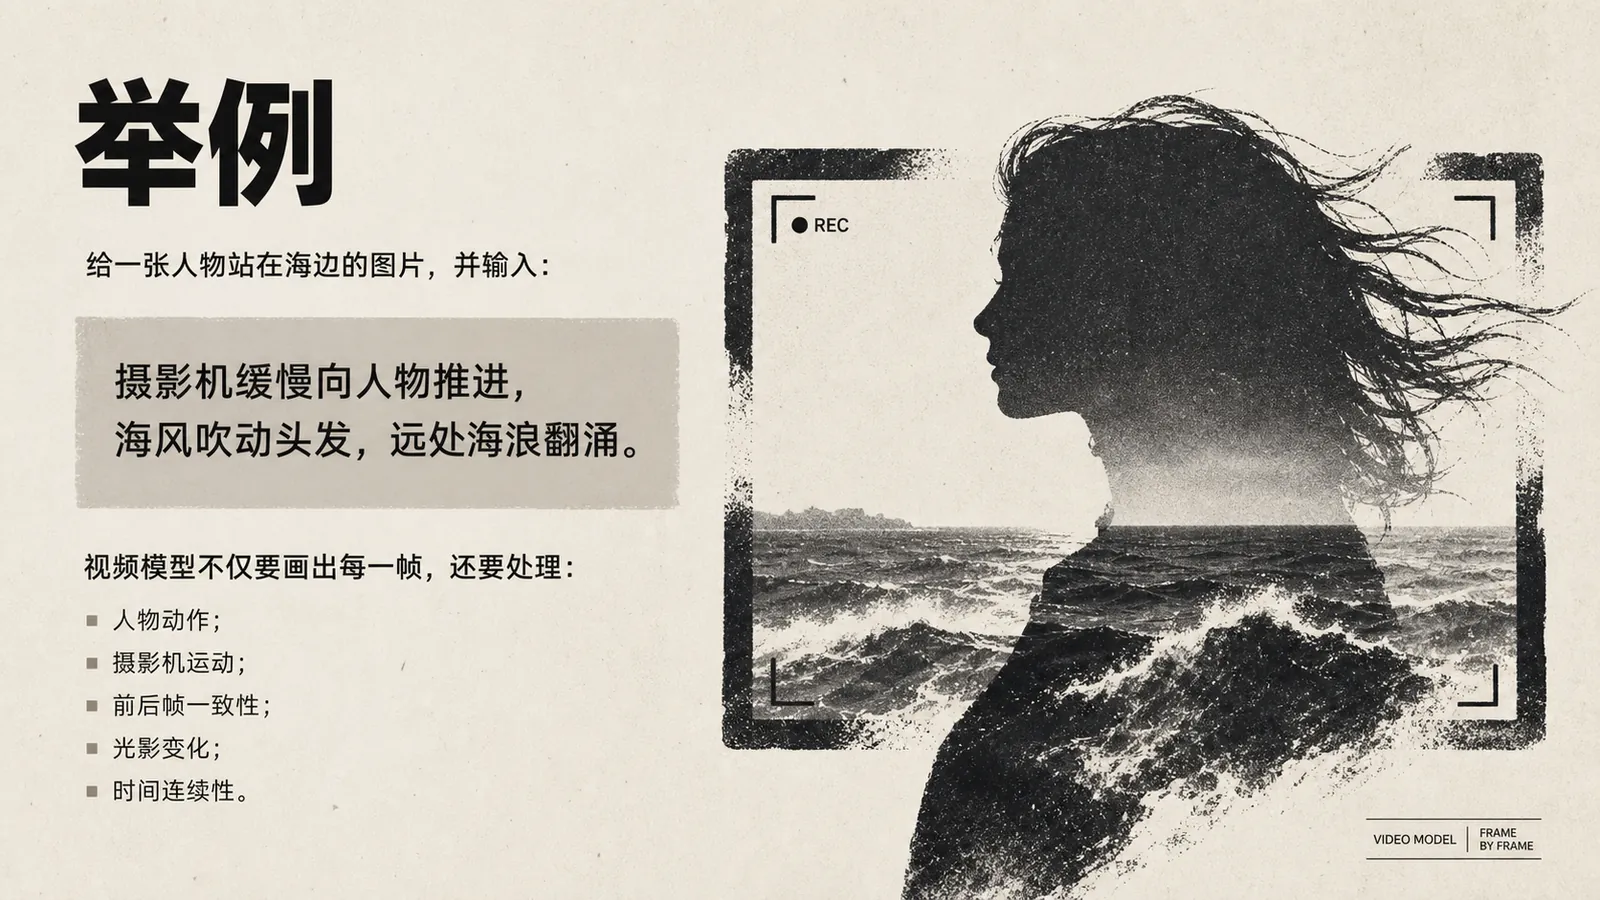
图片展示了一位站在海边的人物剪影,海风吹动其头发,远处海浪翻涌。上方文字说明给一张人物站在海边的图片,并输入:摄影机缓慢向人物推进,海风吹动头发,远处海浪翻涌。下方文字指出视频模型不仅要画出每一帧,还要处理人物动作、摄影机运动、前后帧一致性、光影变化、时间连续性等内容。此图与上下文紧密相关,是对视频生成模型举例的直观呈现,帮助理解其生成视频时需处理的复杂因素。

给一张人物站在海边的图片,并输入:

摄影机缓慢向人物推进,海风吹动头发,远处海浪翻涌。

视频模型不仅要画出每一帧,还要处理:

  • 人物动作;
  • 摄影机运动;
  • 前后帧一致性;
  • 光影变化;
  • 时间连续性。

通俗类比

图片以“通俗类比”为标题,左侧是一张相机的插画,右侧是一个电影胶卷的插画。下方文字说明“图像模型负责拍一张照片,视频模型负责拍一段电影”。该图片与上下文紧密相关,上下文在介绍图像生成模型和视频模型时,将图像模型比作拍一张照片,视频模型比作拍一段电影,此图直观呈现了这一类比关系,帮助读者更清晰地理解图像生成模型和视频模型的功能区别。

图像模型负责拍一张照片,视频模型负责拍一段电影。


11 语音识别模型:负责把声音变成文字
图片以黑色和白色为主色调,左侧文字“11语音识别模型:负责把声音变成文字”突出显示。画面中央是一个卡通麦克风形象,嘴巴张开,露出开心的笑容,背景有声波图案。该图片与文档中介绍语音识别模型的内容相关,直观呈现了语音识别模型将声音转换为文字的功能,与上下文对语音识别模型负责把声音变成文字的描述相契合。

代表模型

图片展示了语音识别模型的代表模型,包括Whisper、GPT-4o Transcribe、GPT-4o Transcribe Diarize、Cohere Transcribe。画面右侧有一个话筒和对话框的图案,话筒上方有声波图示。下方文字说明Whisper和GPT-4o Transcribe属于语音转文字模型;Transcribe Diarize还能判断不同语音片段分别属于哪位说话者。该图片与上下文紧密相关,是对上文介绍的语音识别模型代表的直观呈现。

  • Whisper
  • GPT-4o Transcribe
  • GPT-4o Transcribe Diarize
  • Cohere Transcribe

Whisper和GPT-4o Transcribe属于语音转文字模型;Transcribe Diarize还能判断不同语音片段分别属于哪位说话者。

举例
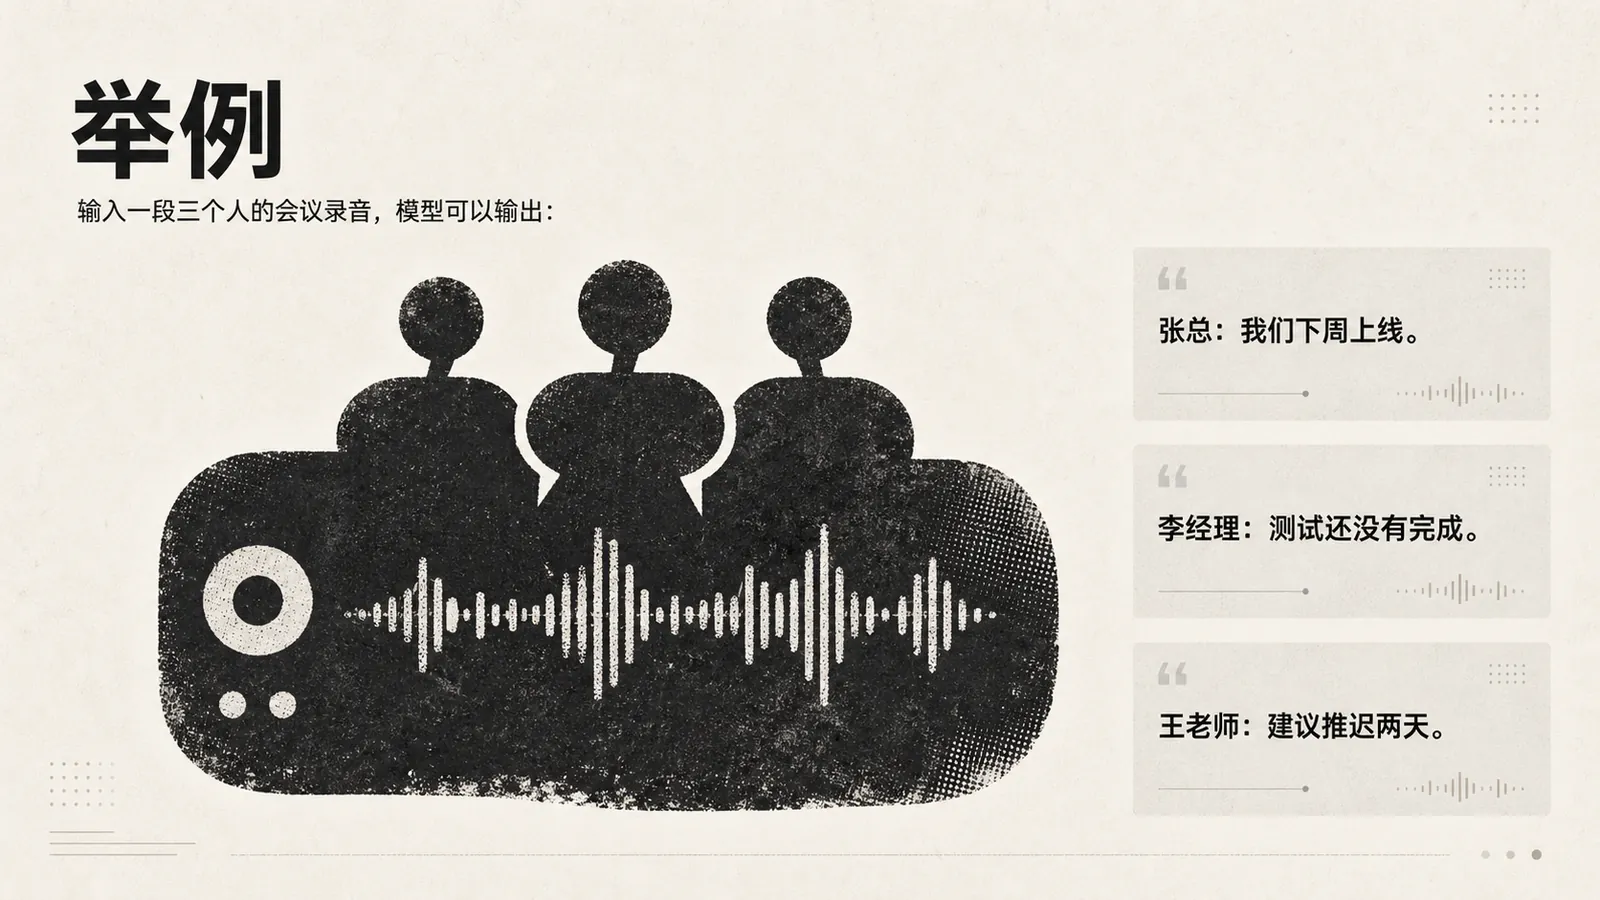
图片展示了语音识别模型将会议录音转为文字的示例。左侧是一个麦克风图案,下方有声波图。右侧列出三个人的发言内容,分别是张总说“我们下周上线”,李经理说“测试还没有完成”,王老师说“建议推迟两天”。该图片与上下文紧密相关,是对上文“输入一段三个人的会议录音,模型可以输出”内容的具体呈现,直观展示了语音识别模型的输出效果。

输入一段三个人的会议录音,模型可以输出:

张总:我们下周上线。
李经理:测试还没有完成。
王老师:建议推迟两天。

通俗类比
图片以“通俗类比”为标题,左侧有竖条纹装饰,右侧是一位手持笔在笔记本上写字的剪影。笔记本上写着“语音识别模型是听写员。”图片与上下文紧密相关,上下文在介绍语音识别模型时,将其类比为听写员,此图直观呈现了这一类比,通过听写员的形象生动地解释了语音识别模型的功能,即负责把声音变成文字。

语音识别模型是听写员。


12 语音合成模型:负责把文字变成声音

图片展示了一个黑色的对话气泡,右侧连接着一个喇叭状的扬声器,扬声器旁有声波图案。左侧文字说明“12 语音合成模型:负责把文字变成声音”。该图片与文档中介绍语音合成模型的内容相关,直观呈现了语音合成模型将文字转换为声音这一功能,与上下文对语音合成模型的定义相呼应。

代表模型

图片展示了语音识别模型的代表模型,包括GPT-4o mini TTS、TTS-1、ElevenLabs语音模型、CosyVoice、ChatTTS。画面右侧是一个带有声音波形的对话气泡,气泡内有三个代表人物的轮廓。图片下方说明GPT-4o mini TTS和TTS-1都属于文字转语音模型,能够把文字转换成自然语音。该图片与上下文紧密相关,是对上文介绍的语音识别模型代表模型的直观呈现,帮助读者更清晰地了解这些模型。

  • GPT-4o mini TTS
  • TTS-1
  • ElevenLabs语音模型
  • CosyVoice
  • ChatTTS

GPT-4o mini TTS和TTS-1都属于文字转语音模型,能够把文字转换成自然语音。

举例
图片展示的是一个关于语音合成模型的举例内容。左侧是一个黑色的卡通麦克风图案,右侧文字说明输入一段广告文案,要求用30岁左右女性的声音,语速稍慢,语气温柔但有力量,模型会生成配音。该图片与上下文紧密相关,是对上文提到的语音合成模型功能的直观呈现,通过具体示例帮助读者理解该模型将文字转换成自然语音的能力。

输入一段广告文案,并要求:

用30岁左右女性的声音,语速稍慢,语气温柔但有力量。

模型会生成配音。

通俗类比
图片以耳朵和嘴唇的图案为背景,左侧文字为“通俗类比”,下方文字说明“语音识别是‘听声音写文字’,语音合成是‘看文字念出来’”。该图片位于介绍语音识别和语音合成模型的上下文之后,是对语音识别和语音合成工作原理的通俗解释,通过类比的方式,直观呈现了语音识别将声音转换为文字、语音合成将文字转换为语音的逻辑,帮助读者更好地理解这两种模型的功能。

语音识别是“听声音写文字”,语音合成是“看文字念出来”。


13 音频模型:可以直接理解和生成声音
图片展示了音频模型的直观概念,左侧有“13音频模型:可以直接理解和生成声音”的文字说明。画面中,左侧是一条声波曲线,右侧是一个黑色的耳朵轮廓,耳朵内部有一个人形图案。该图片与文档中介绍音频模型的内容相关,直观呈现了音频模型可以接收和生成声音这一特性,与上下文对音频模型可直接理解和生成声音的描述相呼应。

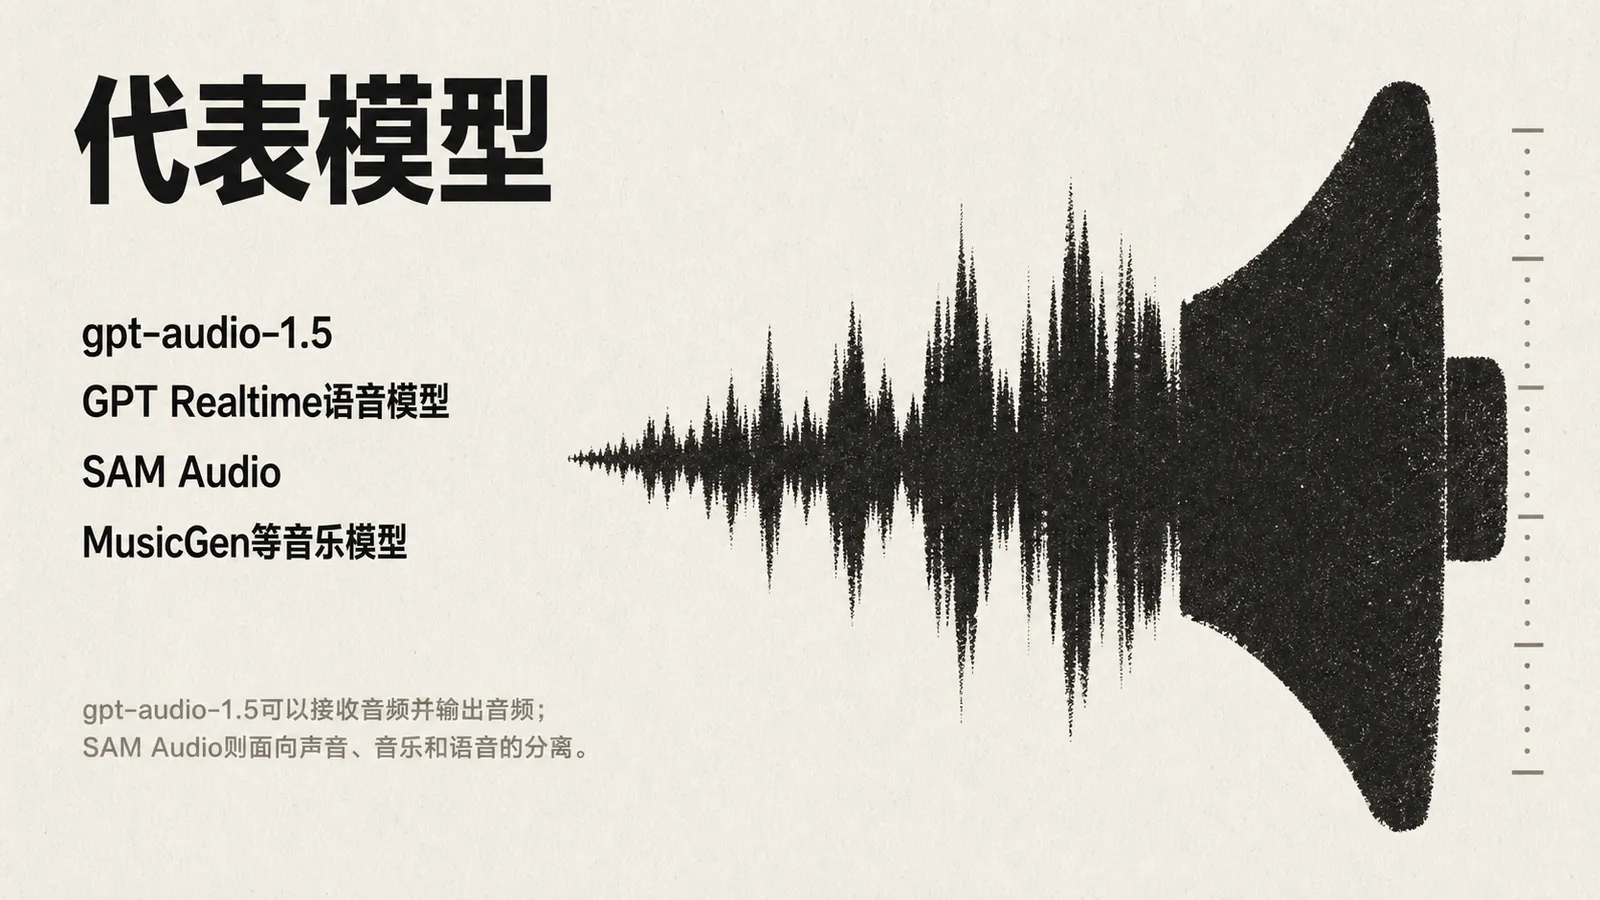
代表模型

图片展示了13音频模型的代表模型,包括gpt - audio - 1. 5、GPT Realtime语音模型、SAM Audio、MusicGen等音乐模型。画面右侧是一个黑色喇叭形状的图形,左侧文字说明gpt - audio - 1. 5可接收音频并输出音频,SAM Audio面向声音、音乐和语音分离。该图片与上下文紧密相关,是对13音频模型中代表模型的直观呈现,帮助读者更清晰地了解这些模型的功能和特点。

  • gpt-audio-1.5
  • GPT Realtime语音模型
  • SAM Audio
  • MusicGen等音乐模型

gpt-audio-1.5可以接收音频并输出音频;SAM Audio则面向声音、音乐和语音的分离。

举例
图片展示了GPT Realtime语音模型的举例内容。左侧以“举例”为标题,列出该模型可完成的六项功能:实时语音对话、判断说话人情绪、从视频中分离人声、去除环境噪声、生成音效、生成音乐。右侧配有黑色音波图案和一只耳朵的插画,耳朵上有“!”和“...”符号,音波图案下方有“...”符号。此图与上下文紧密相关,直观呈现了GPT Realtime语音模型的应用场景。

它可以完成:

  • 实时语音对话;
  • 判断说话人的情绪;
  • 从视频中分离人声;
  • 去除环境噪声;
  • 生成音效;
  • 生成音乐。

通俗类比

图片以卡通风格呈现,左侧文字为“通俗类比”,下方说明传统语音模型在声音和文字间转换,音频模型可直接在声音世界里理解和创作。右侧是一个带有大耳朵的卡通形象,耳朵里有音符,下方有声波图案。该图片与上下文紧密相关,通过形象化表达,直观说明了音频模型与传统语音模型在处理声音信息方面的不同,即传统语音模型需在声音和文字间转换,而音频模型可直接在声音世界里进行理解和创作。

传统语音模型是在声音和文字之间转换,音频模型可以直接在声音世界里进行理解和创作。


14 向量模型:负责寻找意思相近的内容
图片展示了一个放大镜图案,背景为米色,放大镜内有密集的黑色点状分布。图片上方大号数字“14”,下方文字“向量模型:负责寻找意思相近的内容”。该图片与文档中介绍向量模型的内容相关,直观呈现了向量模型在信息检索中的作用,即通过类似放大镜聚焦的方式,寻找意思相近的内容,与上下文对向量模型功能的阐述相呼应。

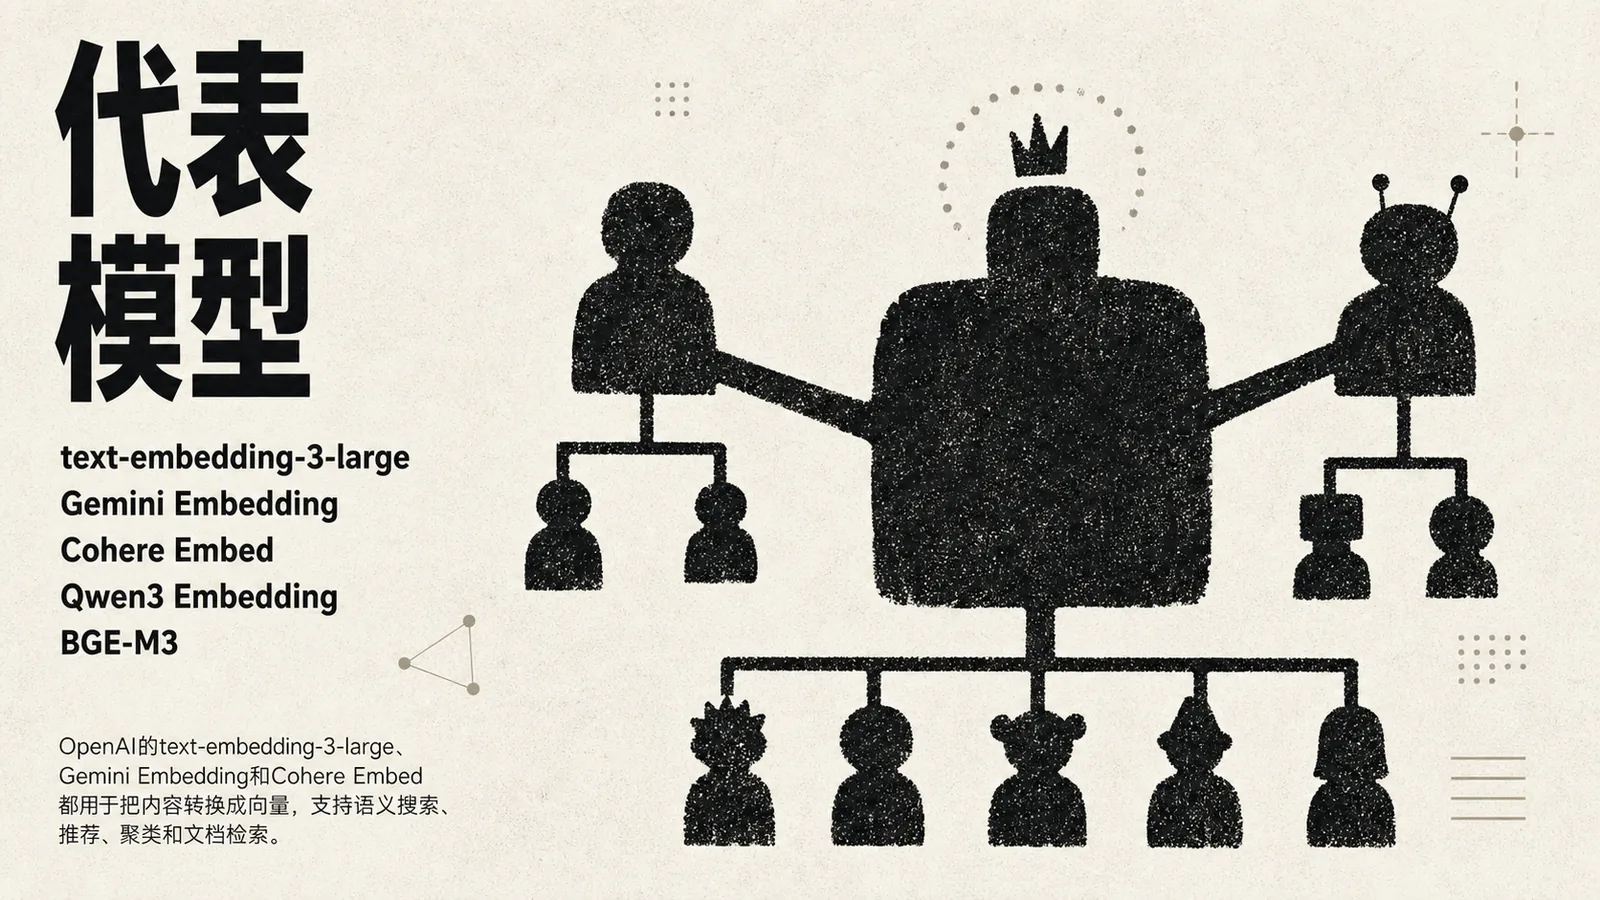
代表模型

图片展示了AI模型家族中的代表模型,包括text-embedding-3-large、Gemini Embedding、Cohere Embed、Qwen3 Embedding、BGE-M3。这些模型都用于把内容转换成向量,支持语义搜索、推荐、聚类和文档检索。图片位于介绍AI模型家族相关内容之后,直观呈现了上文提到的几种代表模型,帮助读者更清晰地理解这些模型在AI模型家族中的位置及功能。

  • text-embedding-3-large
  • Gemini Embedding
  • Cohere Embed
  • Qwen3 Embedding
  • BGE-M3

OpenAI的text-embedding-3-large、Gemini Embedding和Cohere Embed都用于把内容转换成向量,支持语义搜索、推荐、聚类和文档检索。

举例
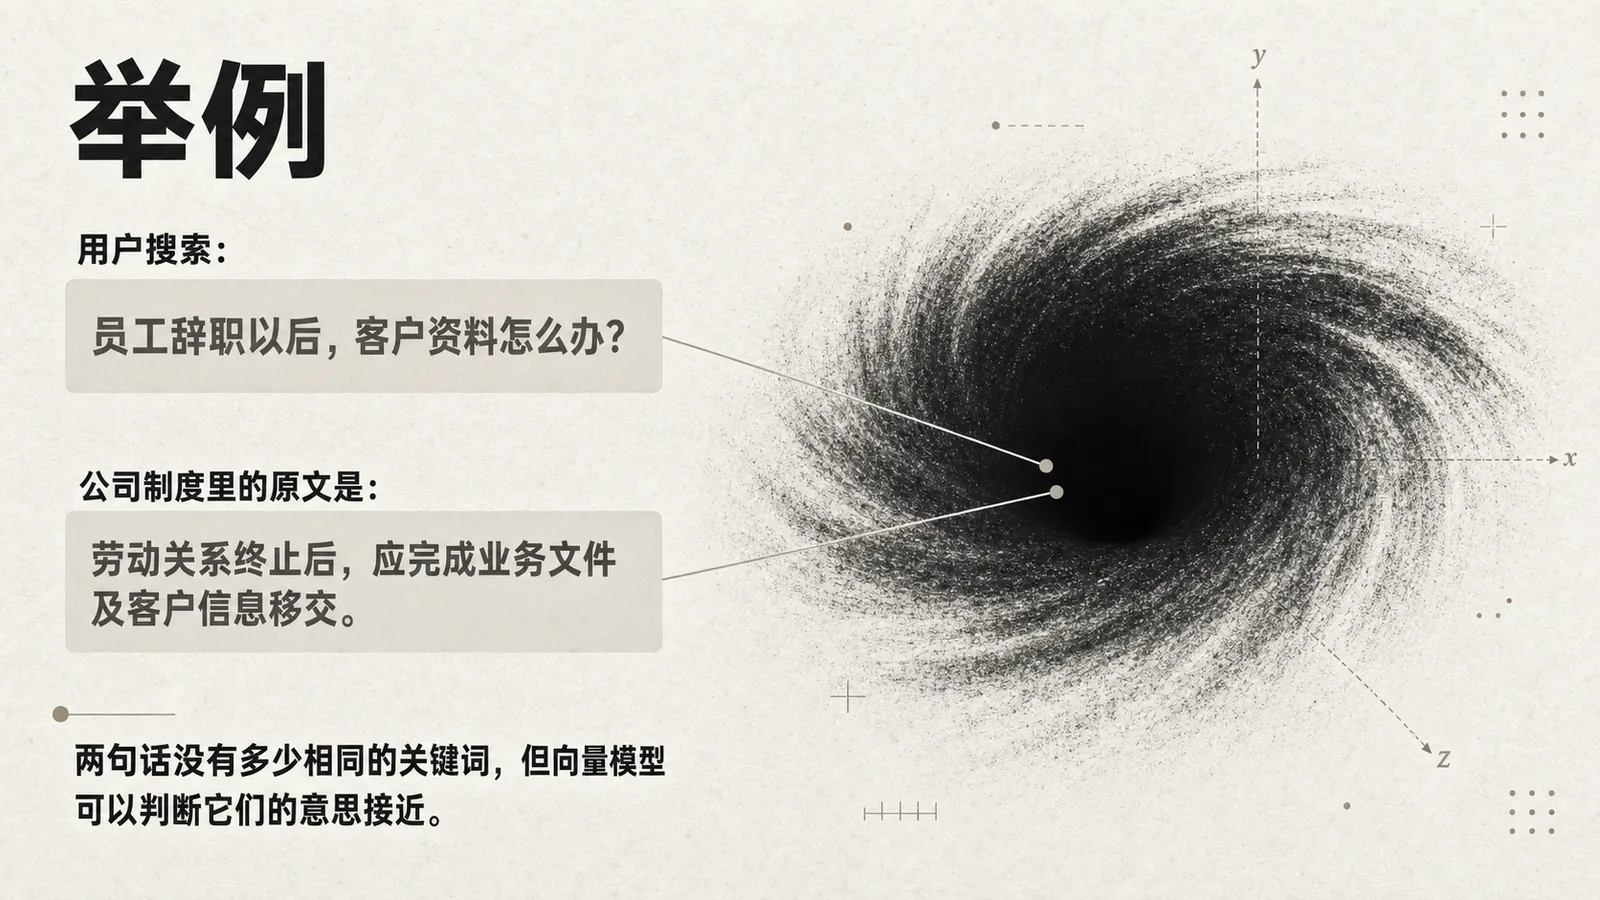
图片展示了向量模型判断意思相近内容的举例。用户搜索“员工辞职以后,客户资料怎么办?”与公司制度原文“劳动关系终止后,应完成业务文件及客户信息移交”两句话,虽无相同关键词,但向量模型能判断其意思接近。图片背景为漩涡图案,左侧有“举例”标题及用户搜索内容,右侧标注x、y、z轴坐标,直观呈现了向量模型在处理语言信息时的场景。

用户搜索:

员工辞职以后,客户资料怎么办?

公司制度里的原文是:

劳动关系终止后,应完成业务文件及客户信息移交。

两句话没有多少相同的关键词,但向量模型可以判断它们的意思接近。

通俗类比
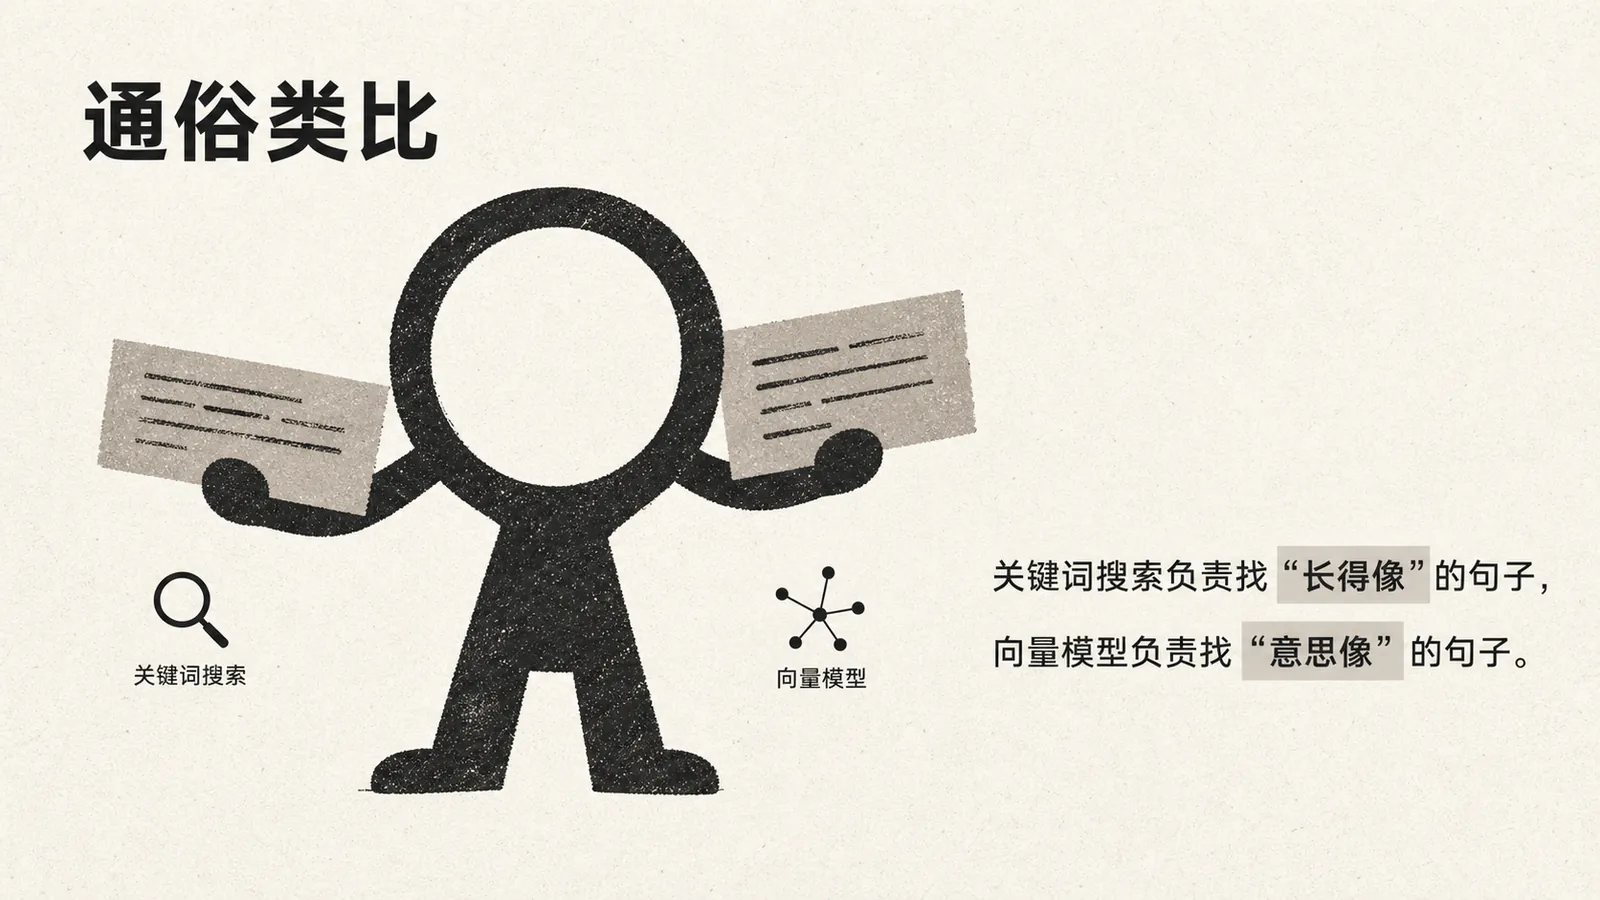
图片以卡通人物形象呈现,左侧人物手持带有文字的纸张,标注“关键词搜索”,右侧人物手持纸张,标注“向量模型”。画面右侧文字说明“关键词搜索负责找‘长得像’的句子,向量模型负责找‘意思像’的句子。”该图与上下文紧密相关,上下文在介绍AI模型家族中向量模型的功能,通过此图直观地将关键词搜索与向量模型的工作职责进行对比,帮助读者更好地理解向量模型在AI模型家族中的作用。

关键词搜索负责找“长得像”的句子,向量模型负责找“意思像”的句子。


15 重排模型:负责把搜索结果重新排队
图片展示了15重排模型的功能,其左侧文字说明“负责把搜索结果重新排队”。右侧画面中,多份文件被一只手从上往下排列,文件上标注有“...”,下方还有类似文件的虚线框。该图片与上下文紧密相关,上下文介绍了15重排模型是AI模型家族中负责重新排队搜索结果的部分,此图直观呈现了其功能,帮助理解模型在信息处理中的作用。

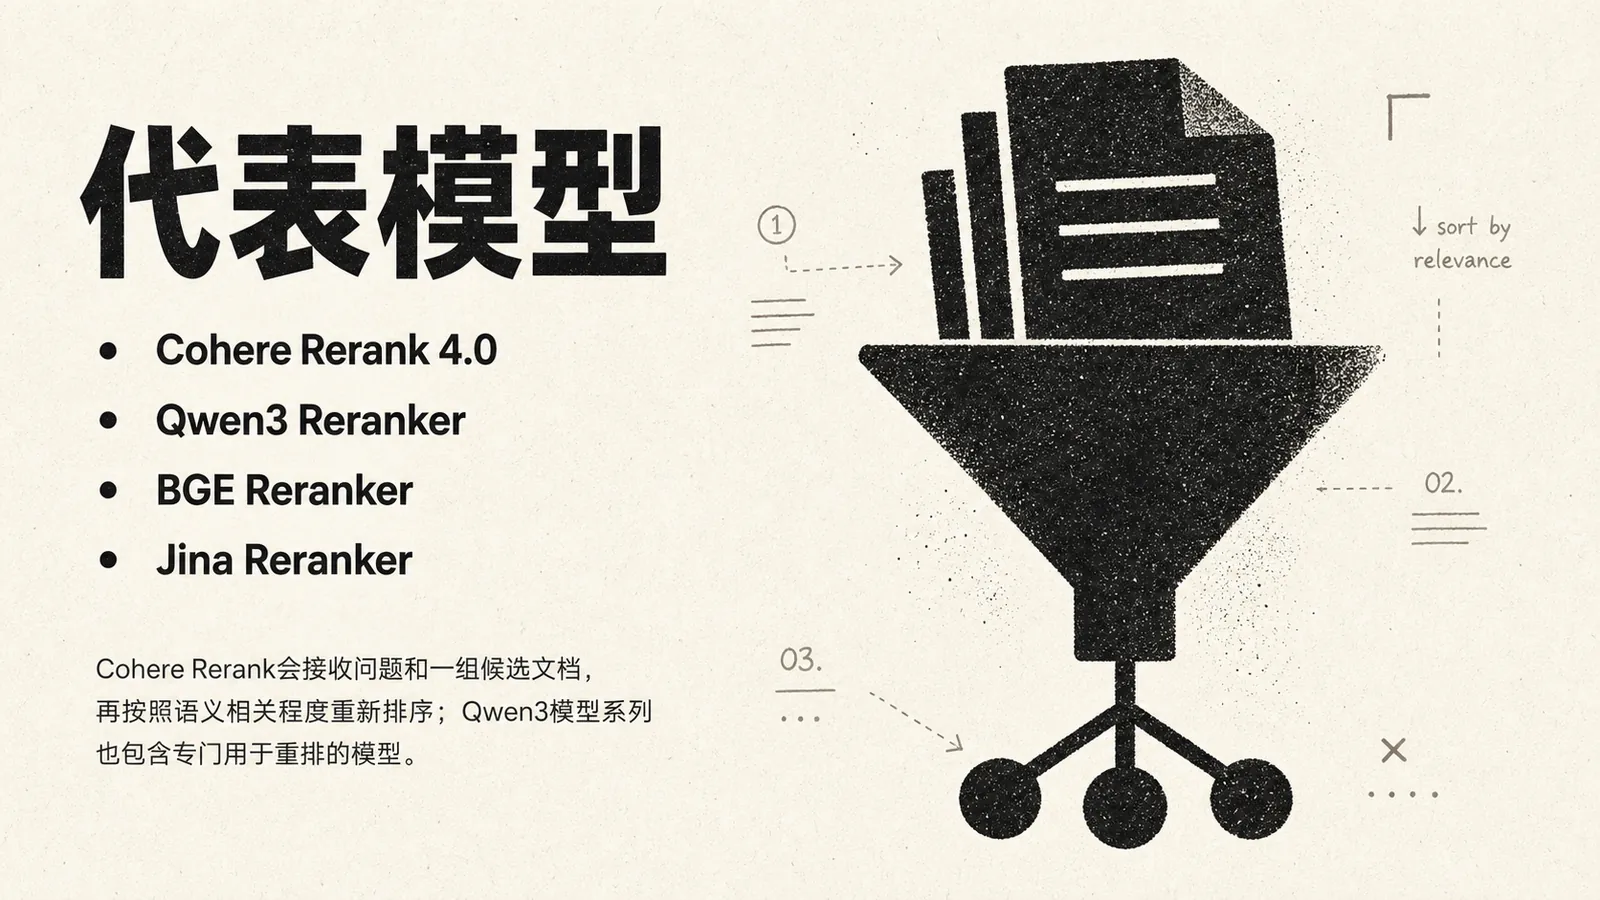
代表模型

图片展示了代表模型,包括Cohere Rerank 4.0、Qwen3 Reranker、BGE Reranker、Jina Reranker。右侧是一个漏斗状结构,顶部有“sort by relevance”标识,下方有数字序号1、2、3,分别对应接收问题和候选文档、排序、输出结果。图片与上下文紧密相关,上下文提到Cohere Rerank会接收问题和一组候选文档,再按语义相关程度重新排序,Qwen3模型系列也包含专门用于重排的模型,此图直观呈现了重排模型的工作流程。

  • Cohere Rerank 4.0
  • Qwen3 Reranker
  • BGE Reranker
  • Jina Reranker

Cohere Rerank会接收问题和一组候选文档,再按照语义相关程度重新排序;Qwen3模型系列也包含专门用于重排的模型。

举例
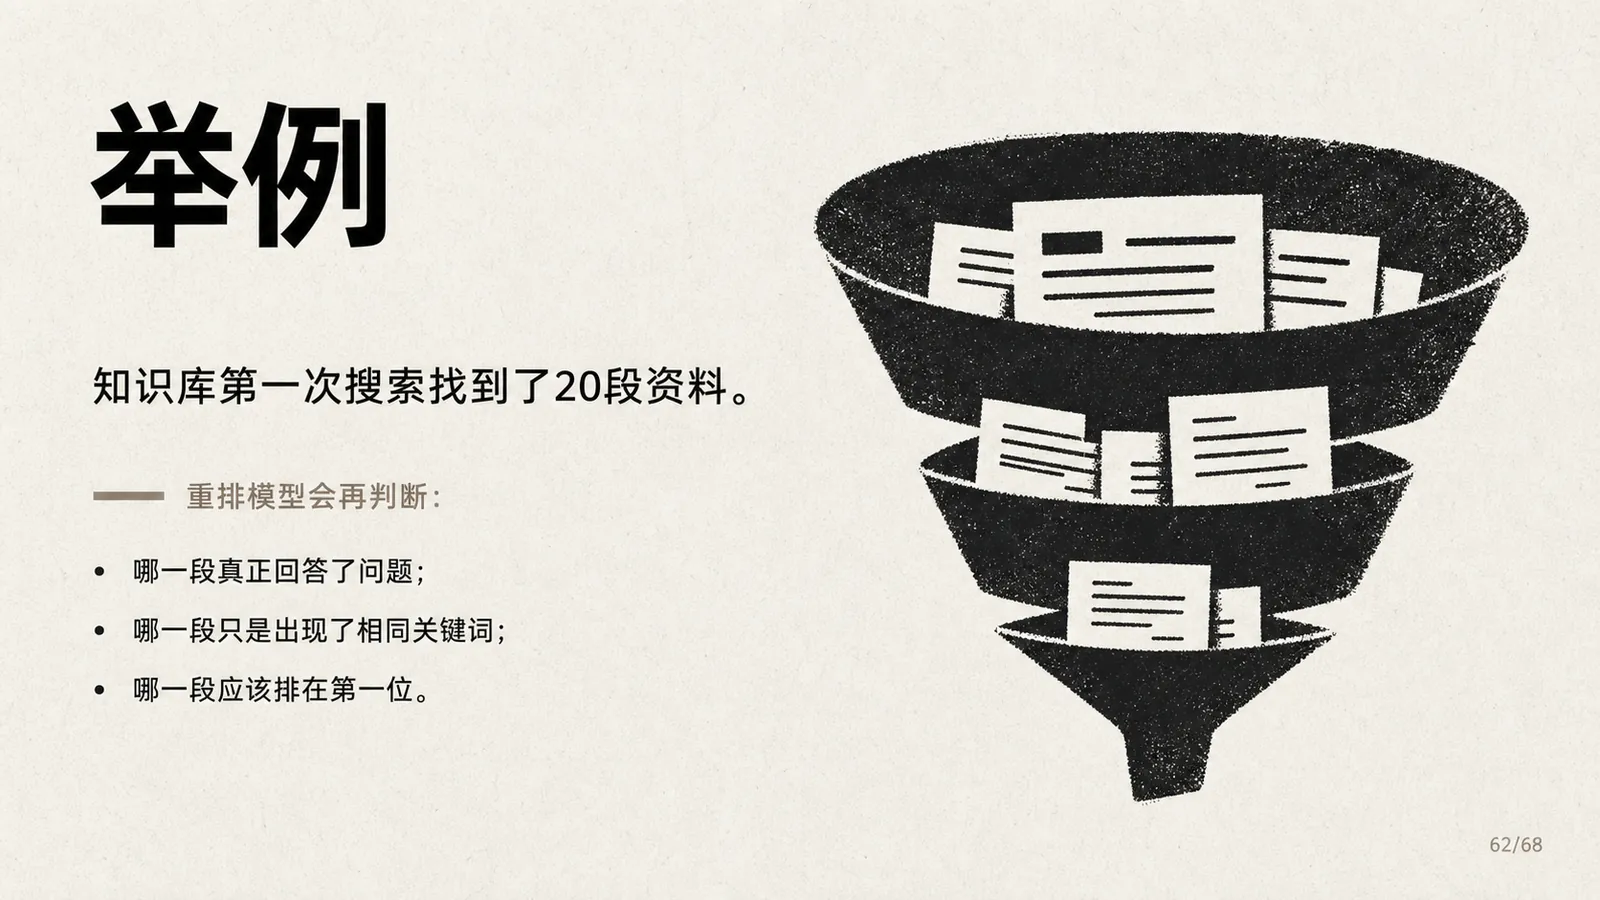
图片以“举例”为标题,说明知识库第一次搜索找到20段资料后,重排模型会再判断哪一段真正回答了问题、哪一段只是出现了相同关键词、哪一段应该排在第一位。右侧是一个漏斗图,代表信息筛选过程,从上至下依次缩小,漏斗内有多个纸张图标,象征着筛选出的资料。该图片与上下文紧密相关,直观呈现了重排模型在知识库搜索结果处理中的作用。

知识库第一次搜索找到了20段资料。

重排模型会再判断:

  • 哪一段真正回答了问题;
  • 哪一段只是出现了相同关键词;
  • 哪一段应该排在第一位。

通俗类比

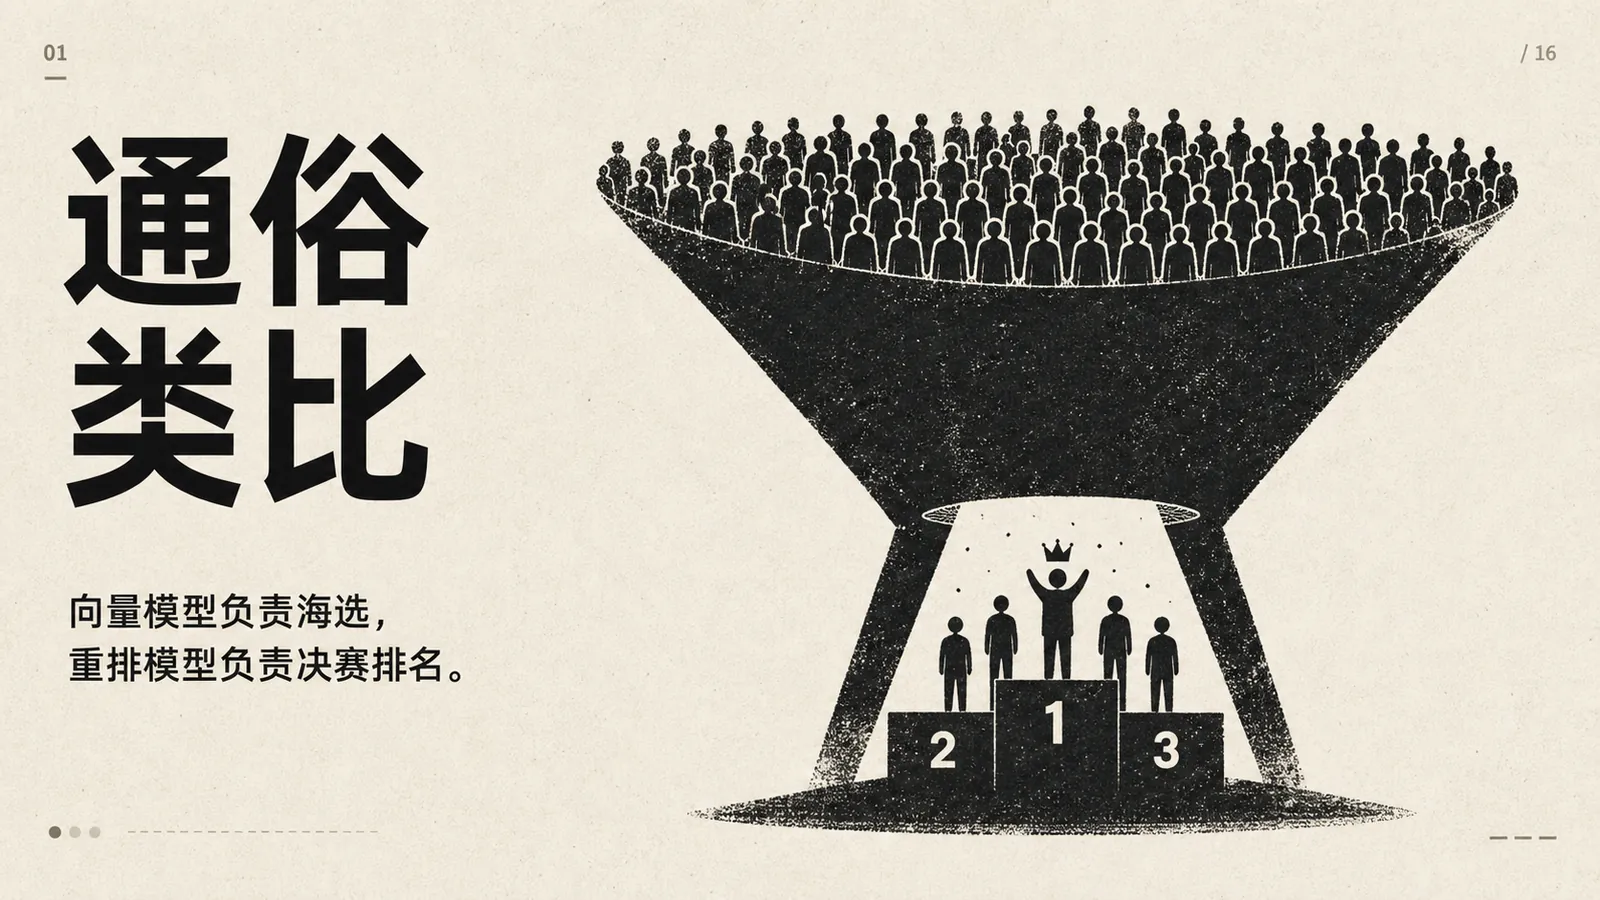
这张是AI模型相关的通俗类比示意图,用形象的图形对应了向量模型和重排模型的分工。图中上方大量人群经漏斗汇聚,最终进入下方的领奖台区域,领奖台上的中央1号位置戴着皇冠的人物,对应了重排模型负责的决赛排名,两侧2、3号位置的人物则代表排序后的其他结果,配合下方的文字说明,直观展示了向量模型负责海选、重排模型负责对结果进行决赛排名的逻辑。

向量模型负责海选,重排模型负责决赛排名。


16 分类与审核模型:负责判断、分流和把关
图片以黑色漏斗和房屋为背景,上方有多种形状和符号,下方漏斗口处有一张标签。左侧文字标注“16 分类与审核模型:负责判断、分流和把关”。该图与文档中介绍分类与审核模型的内容相关,通过形象化表达,说明此类模型负责对信息进行判断、分流和把关,将信息按类别进行处理,如将客户留言自动分成产品咨询、售后投诉、退款申请、合作建议、风险内容等。

代表模型

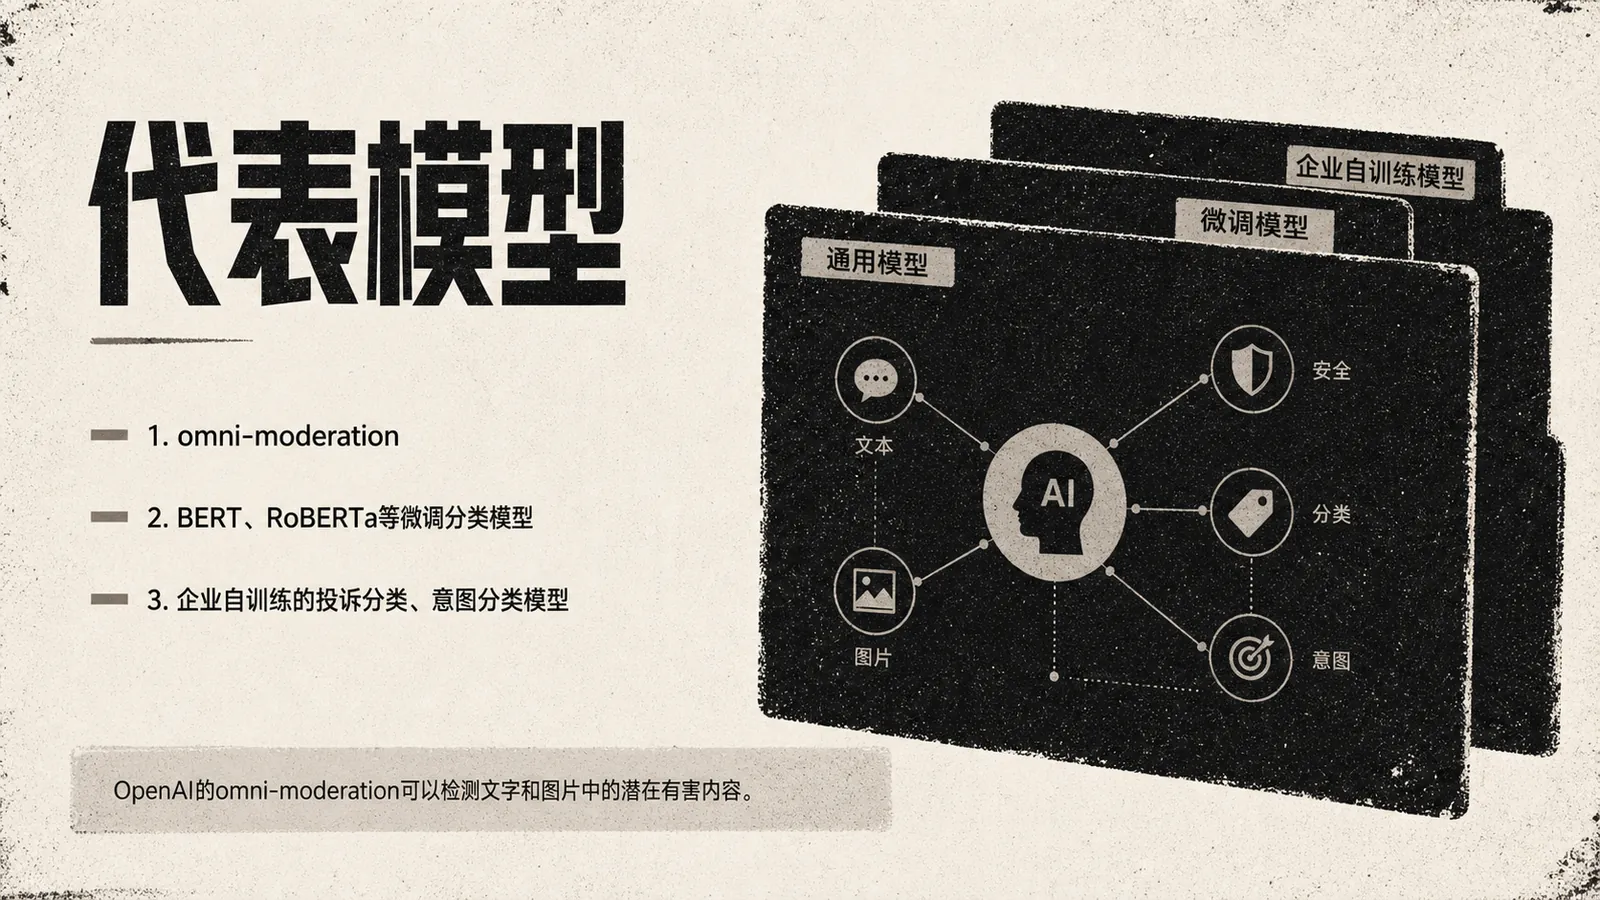
图片展示了AI分类与审核模型的代表模型,分为通用模型和微调模型。通用模型包括文本、图片、安全、分类、意图等类别。微调模型有企业自训练模型,如OpenAI的omni - moderation可检测文字和图片中的潜在有害内容,还有BERT、RoBERTa等微调分类模型,以及企业自训练的投诉分类、意图分类模型。图片与上下文紧密相关,直观呈现了文档中提到的AI分类与审核模型类型及功能。

  • omni-moderation
  • BERT、RoBERTa等微调分类模型
  • 企业自训练的投诉分类、意图分类模型

OpenAI的omni-moderation可以检测文字和图片中的潜在有害内容。

举例
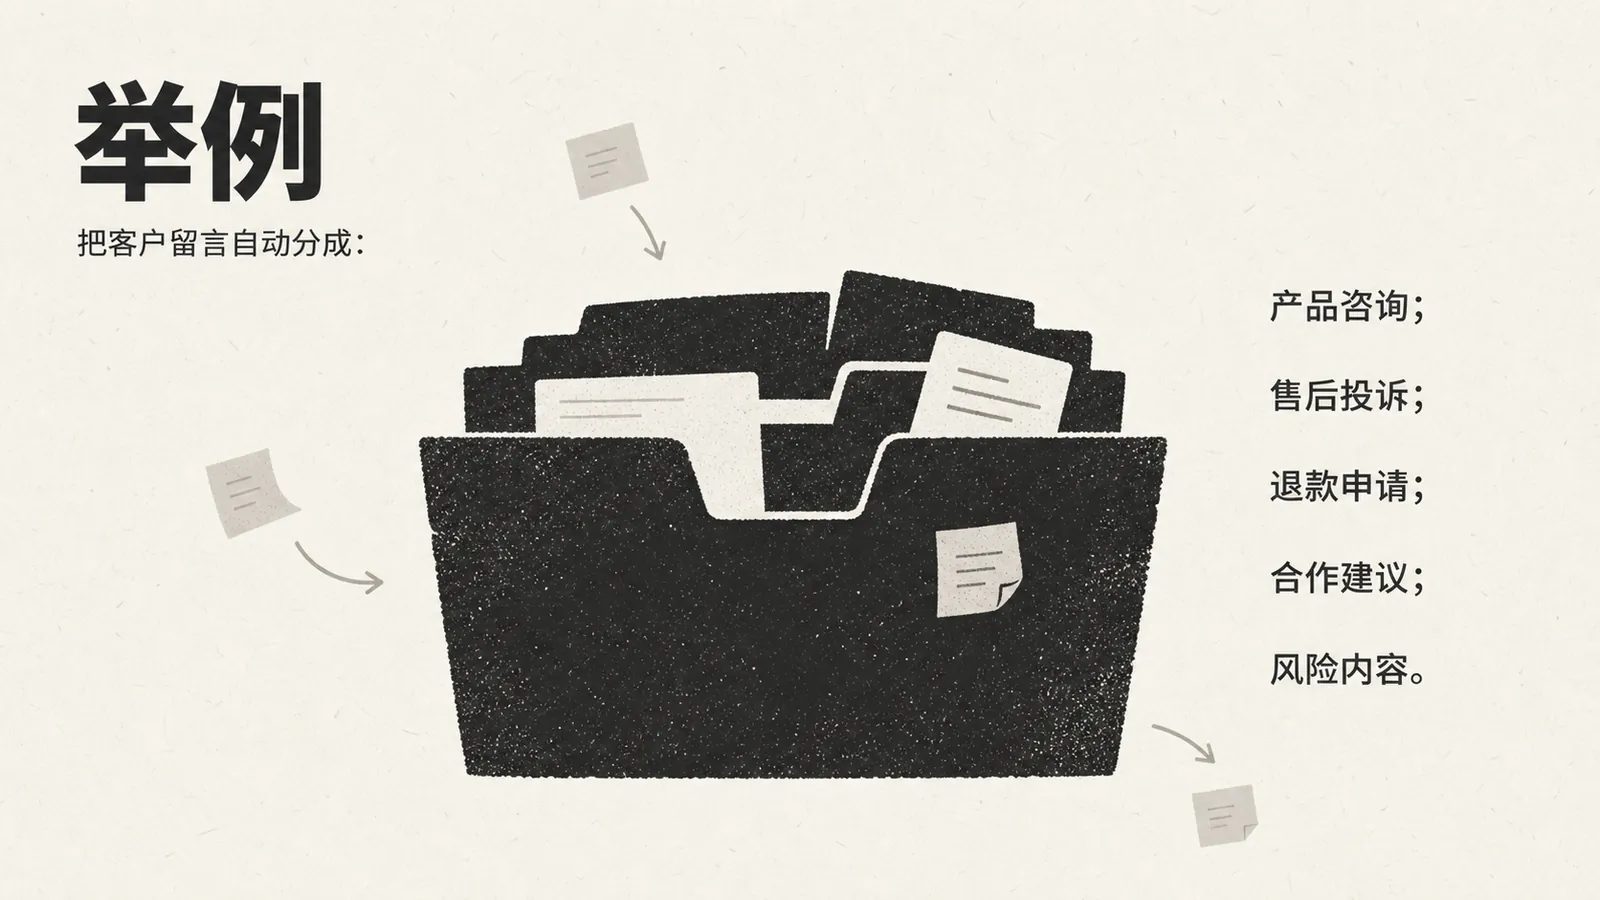
图片展示了AI分类与审核模型的举例内容。画面中有一个文件夹,左侧有三张飞出的纸片,右侧列出“产品咨询”“售后投诉”“退款申请”“合作建议”“风险内容”等分类。这与上下文介绍的分类与审核模型负责判断、分流和把关的内容相呼应,以文件夹分类形式形象地说明了模型将客户留言自动分成不同类别,如风险内容等,体现了AI在信息处理中的应用。

把客户留言自动分成:

  • 产品咨询;
  • 售后投诉;
  • 退款申请;
  • 合作建议;
  • 风险内容。

通俗类比

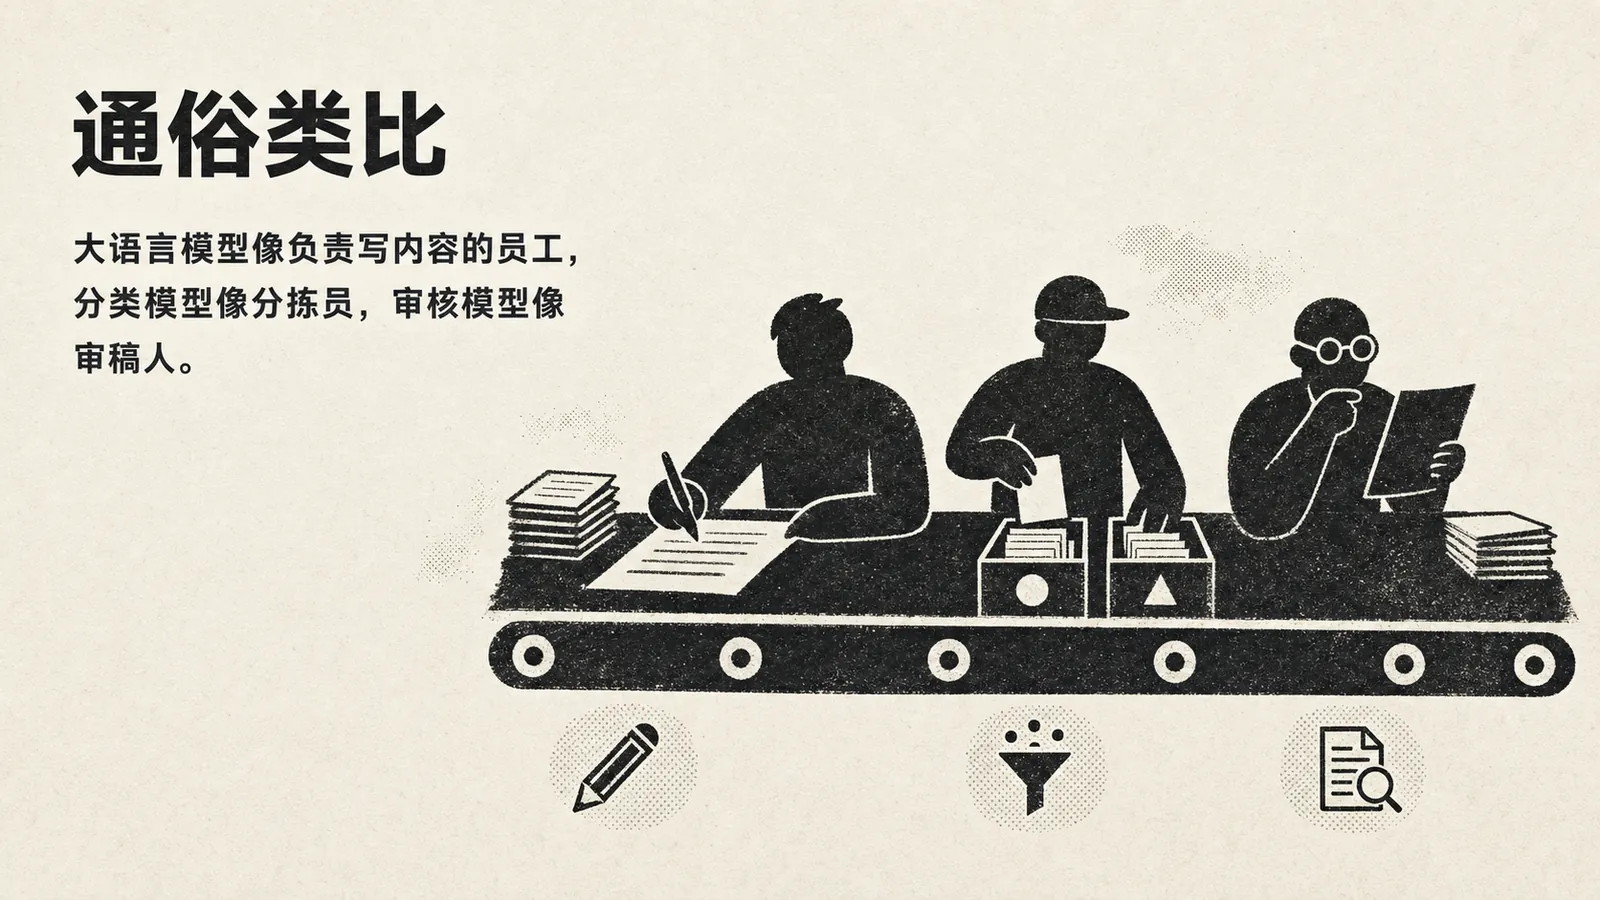
图片以“通俗类比”为标题,将大语言模型比作负责写内容的员工,分类模型比作分拣员,审核模型比作审稿人。画面中,左侧员工在写内容,中间分拣员在分拣,右侧审稿人拿着笔在审稿。画面下方有铅笔、漏斗和放大镜图标。该图与上下文紧密相关,通过生动形象的比喻,直观说明了大语言模型、分类模型和审核模型在AI系统中的不同职责。

大语言模型像负责写内容的员工,分类模型像分拣员,审核模型像审稿人。

第一模块最后的记忆口诀
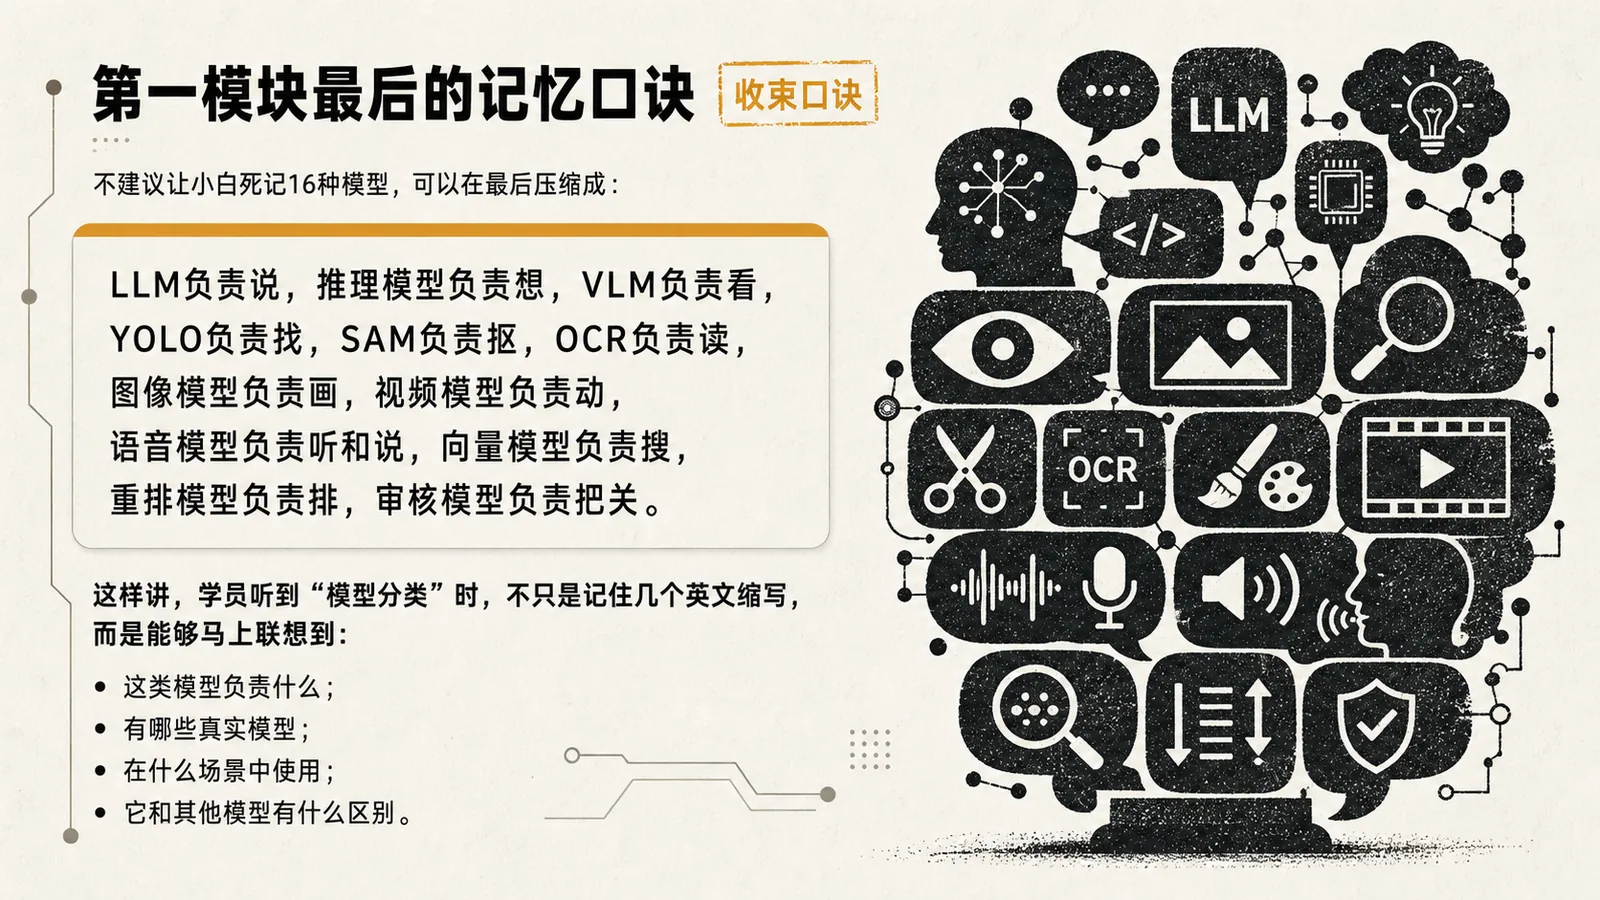
图片展示了AI模型分类的记忆口诀,背景为多个图标,如眼睛、剪刀、放大镜等。口诀内容为:LLM负责说,推理模型负责想,VLM负责看,YOLO负责找,SAM负责抠,OCR负责读,图像模型负责画,视频模型负责动,语音模型负责听和说,向量模型负责搜,重排模型负责排,审核模型负责把关。图片与上下文紧密相关,是对AI模型分类的总结,帮助学员在听到“模型分类”时,能联想到这些模型负责什么、有哪些真实模型、在什么场景中使用及与其他模型的区别。

不建议让小白死记16种模型,可以在最后压缩成:

LLM负责说,推理模型负责想,VLM负责看,YOLO负责找,SAM负责抠,OCR负责读,图像模型负责画,视频模型负责动,语音模型负责听和说,向量模型负责搜,重排模型负责排,审核模型负责把关。

这样讲,学员听到“模型分类”时,不只是记住几个英文缩写,而是能够马上联想到:

  • 这类模型负责什么;
  • 有哪些真实模型;
  • 在什么场景中使用;
  • 它和其他模型有什么区别。

做出来了,下一步:登记

项目能跑只是前半程。源码文档整理、申报材料生成这类重复劳动,可以交给软著通——AI 软件著作权申请工具,材料备齐再提交;登记结果以中国版权保护中心审核为准。

软著通下载入口